一、核心定义与问题背景
在处理海量字符串时,如果我们要在一本包含 set<string>,在极端数据下很容易因为重复的逐位比较而导致超时。
字典树(Trie,也称前缀树)正是为了解决此类问题而生的。它将拥有相同前缀的字符串合并在同一条路径上。在这种结构下,查询的时间复杂度仅取决于被查询字符串的长度
通俗类比:“查字典与做记号”
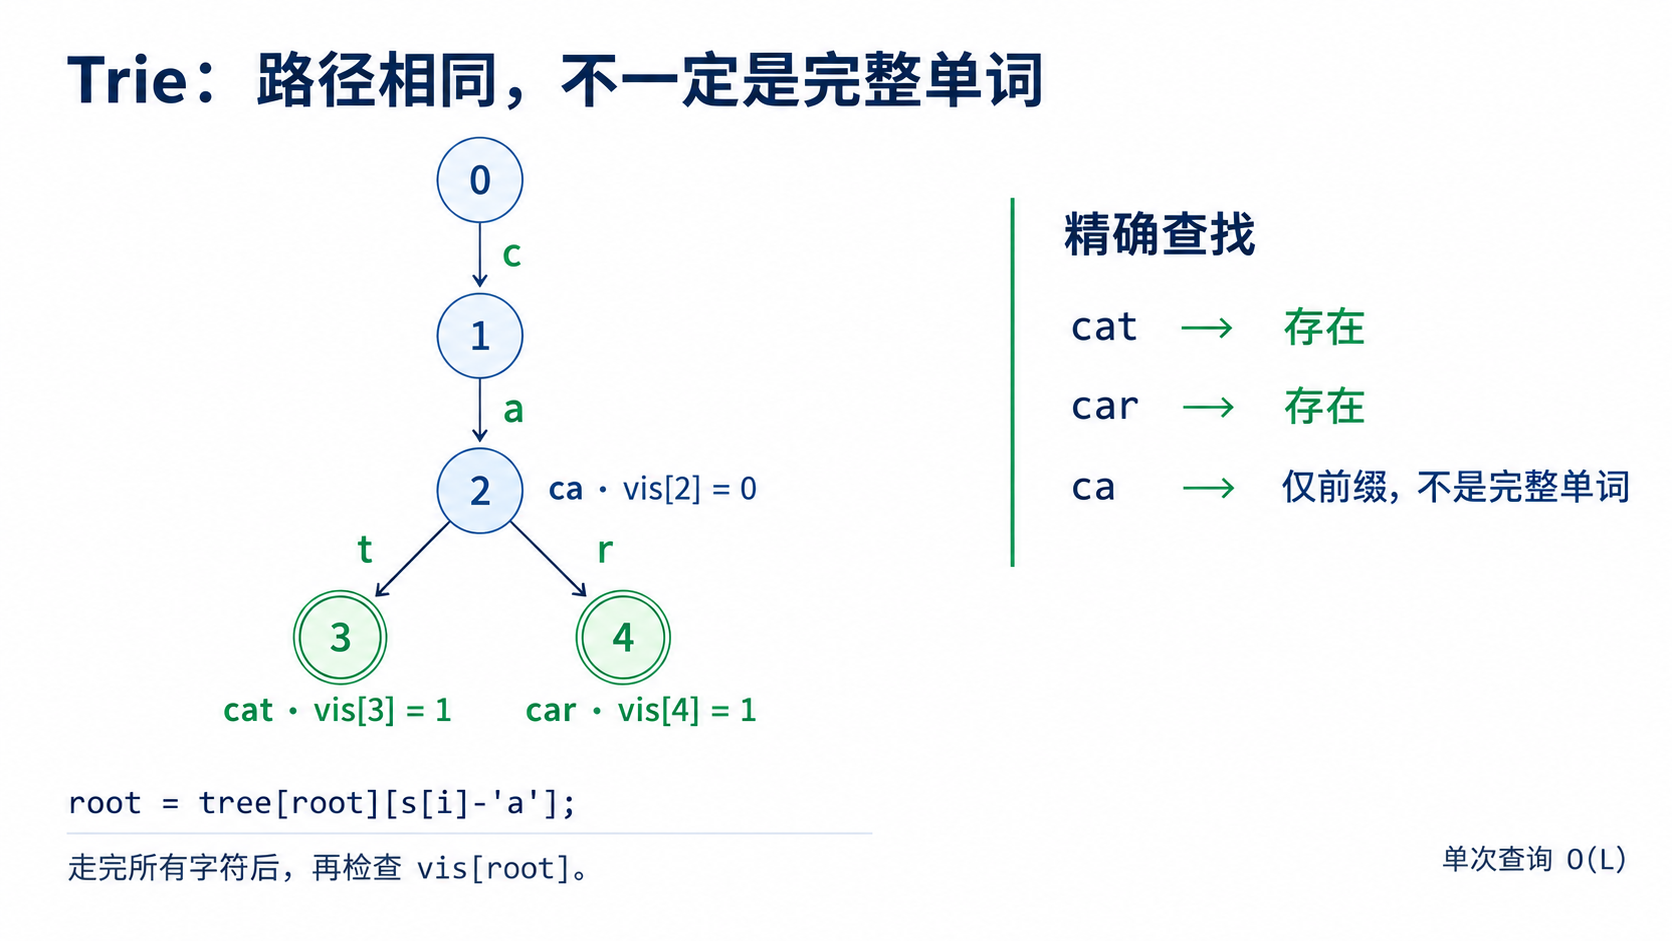
假设我们要录入单词 "cat" 和 "car"。
我们不需要准备两张纸,而是先建一个 'c' 的房间,里面开一扇 'a' 的门。走进去后,再分别开一扇 't' 的门和一扇 'r' 的门。
为了区分 "car"(小汽车)是一个完整的单词,而 "ca"(不是完整单词,只是前缀),我们必须在 't' 和 'r' 的房间里放一面“红旗”(标记位)。以后谁走到有红旗的房间,就说明找到了一个完整的单词。
二、核心原理与状态转移逻辑
字典树本质上是一个确定性有限状态自动机 (DFA)。在代码实现中,我们主要依赖两个核心数组:
1. 状态转移矩阵 (tree[root][id])
这是一个二维数组,负责构建树的骨架。
root表示当前所在的节点编号(初始根节点固定为)。 id表示接下来要走的一条边(将a-z映射为的整数)。 tree[root][id]的值代表:从当前节点root经过字符id转移后,到达的下一个节点的编号。如果该值为,说明这条路还没被修通。
2. 结尾标记数组 (vis[root])
这是一个布尔型(或整型)的一维数组,负责记录单词的终点。
- 只有当一个完整单词插入结束时,我们才会把当前停靠的节点
root对应的vis[root]标记为。 - 在查询时,即使路径完全匹配,也必须检查最终停留节点的
vis值是否为,以此来区分“找到了完整单词”还是“只匹配了一个前缀”。
三、标准求解算法与模板
以下是利用字典树实现字符串精确插入与查找的标准模板。
易错点分析:
- 字符映射:在计算
id时,必须用当前字符减去基准字符(如s[i] - 'a'),确保索引落在之间。 - 多测清空:在包含
组数据的题目中,每次循环开始必须将节点分配器 cnt清零,并将使用过的tree和vis数组空间重置。
这份模板处理小写字母,节点容量按每组插入字符串的总长度不超过
#include<bits/stdc++.h>
using namespace std;

// 节点分配器与核心数组
int cnt = 0;
bool vis[1000010];       // 标记当前节点是否为一个完整字符串的结尾
int tree[1000010][26];   // 状态转移树,第二维 26 代表全小写字母字符集

// 插入操作:将字符串 s 录入字典树
void ins(string s) {
    int root = 0; // 每次插入都从根节点 0 开始
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a'; // 字符映射为 0~25 的索引

        // 如果当前节点没有指向该字符的边,则开辟新节点
        if (tree[root][id] == 0) {
            tree[root][id] = ++cnt;
        }
        // 顺着边走到下一个节点
        root = tree[root][id];
    }
    // 字符串遍历结束,在最终停留的节点打上完整单词标记
    vis[root] = 1;
}

// 查找操作:在字典树中查询字符串 s 是否作为一个完整的单词存在
int find(string s) {
    int root = 0;
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a';

        // 只要有一步发现路不通,说明该字符串绝对不存在
        if (tree[root][id] == 0) {
            return 0;
        }
        root = tree[root][id];
    }
    // 路径完全匹配,但必须返回该节点是否有完整单词标记
    // (防止把字典里的 "apple" 当作查询 "app" 存在的依据)
    return vis[root];
}

int main() {
    // 优化 I/O 速度,应对大规模字符串读写
    ios::sync_with_stdio(0);
    cin.tie(0);
    cout.tie(0);

    int T, n, q;
    cin >> T;
    while (T--) {
        // 先清掉上一组用过的节点,再重置计数器;根节点 0 也要清
        for (int i = 0; i <= cnt; i++) {
            memset(tree[i], 0, sizeof tree[i]);
            vis[i] = 0;
        }
        cnt = 0;

        cin >> n >> q;
        for (int i = 0; i < n; i++) {
            string s;
            cin >> s;
            ins(s); // 插入字典
        }
        for (int i = 0; i < q; i++) {
            string s;
            cin >> s;
            cout << find(s) << "\n"; // 查询结果
        }
    }
    return 0;
}
四、洛谷实战题单:纯字符串应用延展
掌握了标准模板后,我们可以通过修改 vis 数组的含义,衍生出各种强大的纯字符串处理模型。
1. 题型一:精确匹配与状态复用
这类题目完全契合模板,只需将 bool vis[] 改为 int vis[],用来记录更多的状态(如:没访问过、访问过1次、访问过多次)。
- 洛谷 P2580 于是他错误的点名开始了
- 场景:给出
个正确的名字,然后进行 次点名。第一次点到正确名字输出 OK,重复点名输出REPEAT,点错输出WRONG。 - 思路:插入时将模板中的
vis[root] = 1。查询时,如果走到尽头vis == 1,说明点名正确,输出OK并将vis顺手改成2;如果vis == 2,输出REPEAT;如果半路断掉或者vis == 0,输出WRONG。
- 场景:给出
2. 题型二:前缀频率统计
如果题目不问“这个单词是否存在”,而是问“有多少个单词以 xxx 为前缀”,单靠末尾的 vis 标记就不够用了。
- 洛谷 P8306 【模板】字典树
- 场景:给定
个字符串作为词典,询问 次,每次问某个前缀在词典中出现了多少次。 - 思路:将
vis数组替换为num数组。在ins(s)时,只要经过该节点,就让num[root]++。查询时,走到前缀的最后一个节点,直接返回num[root]即可,代表有多少个单词曾经路过这里。 - 迁移提醒:这题含大小写字母和数字,要把字符映射改为
a-z → 0..25、A-Z → 26..51、0-9 → 52..61,转移表第二维开到 62;节点数按插入总长度预留,别原封不动复制这里的 26 列小写模板。多测还要清空num。 - 内存提醒:按 32 位整数估算,转移表要占“节点数 × 62 × 4”字节;百万节点仅这张表就约 248 MB,还没算计数数组。先按原题总长度和内存限制估算,再决定开多大。
- 场景:给定
3. 题型三:文档倒排索引(标记数组升级)
有些应用要求知道一个单词具体出现在了哪些文档(段落)中,我们需要把 vis 升级为动态容器。
- 洛谷 P3879 [TJOI2010] 阅读理解
- 场景:给出
篇文章,然后给出 个询问。每次询问一个单词,要求按顺序输出包含该单词的所有文章编号。 - 思路:单词结尾的
vis不再是一个布尔值,而是改为vector<int> docs[1000010],存下包含它的文章编号,存编号的同时还要去重。按文章编号id依次读入时,只有docs[root].empty() || docs[root].back() != id才把id加进去,同一篇里重复出现的单词就不会重复登记。查询时直接遍历输出docs[root]即可,编号也天然有序。
- 场景:给出
4. 题型四:前缀双向包含关系
既要考虑“你是我的前缀”,也要考虑“我是你的前缀”,需要拆分节点属性。
- 洛谷 P2922 [USACO08DEC] Secret Message G
- 场景:给出
条已知信息(01 串),再给出 条截获信息。求每条截获信息与多少条已知信息存在“前缀包含”关系。 - 思路:一个节点维护两个数组:
pass_cnt(有多少字符串经过)和end_cnt(有多少字符串在此结束)。查询时,每走到一个节点就执行ans += end_cnt[u],统计“已知信息是截获信息的前缀”。若完整走完查询串,再执行ans += pass_cnt[u] - end_cnt[u]:补上更长的已知信息,减去刚才已算过的相等串。若途中断路,直接返回已经累加的ans。
- 场景:给出
五、进阶架构:多重计数、动态删除与字典序遍历
在处理更复杂的纯字符串应用时,我们经常需要像 std::multiset 一样支持插入、查询频次甚至删除。仅仅依靠布尔类型的 vis 数组无法满足这些需求,因此我们需要将节点状态进行扩充。
1. 状态拆分:pass_cnt 与 end_cnt
为了支持丰富的计数查询,我们通常定义两个数组:
pass_cnt[root]:表示有多少个字符串经过了该节点。物理意义上,它等于“以当前路径为前缀”的字符串总数。end_cnt[root]:表示有多少个字符串在当前节点结束。物理意义上,它是某个确切单词在字典中的完整副本数量。
2. 懒惰删除法 (Lazy Deletion)
假如我们在字典中录入了 3 次 "apple",现在要删去 1 次。我们绝不能直接把节点在内存里清掉,因为 "app" 可能还是 "application" 的前缀,物理删除会破坏整棵树的连通性!
正确的做法是:先查询待删除的单词是否存在。如果存在,就沿着它的路径走一遍,沿途把所有经过节点的 pass_cnt 减 1,最后把终点节点的 end_cnt 减 1。只要 pass_cnt 变成 0,就说明这个节点在逻辑上已经“废弃”了。
💡 【手算小例子】
- 插入 "cat", "car"。此时 'c', 'a' 节点的
pass_cnt均为 2;'t', 'r' 的pass_cnt和end_cnt均为 1。- 删除 "cat"。走过 'c', 'a', 't',将它们的
pass_cnt全部减 1;最后把 't' 的end_cnt减 1。- 此时 't' 节点的
pass_cnt和end_cnt均为 0,在后续查询前缀或遍历时,它就自然地“隐身”了,而 "car" 的路径完好无损。
// 功能:包含完整插入、查询前缀、精确匹配与删除功能的增强版 Trie
// 输入:第一行一个整数 Q (1 <= Q <= 10^5),表示操作次数。
//       接下来 Q 行,每行一个操作 op 和一个由小写字母组成的字符串 s。
//       op=1 插入;op=2 查询完整单词次数;op=3 查询前缀次数;op=4 删除(需保证存在)。
//       所有插入操作的字符串总长度不超过 10^6;删除不回收节点编号。
/*
样例输入:
6
1 apple
1 apple
1 app
2 apple
4 apple
3 app

样例输出:
2
2
*/
#include<bits/stdc++.h>
using namespace std;

// 内存提示:百万级节点的 Trie 树空间开销较大(tree 数组约 104MB)。
// 为防 MLE,本模板不强行套用 #define int long long,直接使用 32 位 int。
const int N = 1000010;

int cnt = 0;
int tree[N][26];
int pass_cnt[N]; // 经过次数(前缀计数)
int end_cnt[N];  // 结尾次数(精确计数)

void insert(string s) {
    int root = 0;
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a';
        if (!tree[root][id]) tree[root][id] = ++cnt;
        root = tree[root][id];
        pass_cnt[root]++; // 沿途累加前缀计数
    }
    end_cnt[root]++; // 终点累加完整串计数
}

int count_exact(string s) {
    int root = 0;
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a';
        if (!tree[root][id]) return 0;
        root = tree[root][id];
    }
    return end_cnt[root];
}

int count_prefix(string s) {
    int root = 0;
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a';
        if (!tree[root][id]) return 0;
        root = tree[root][id];
    }
    return pass_cnt[root];
}

void remove(string s) {
    // 铁律:必须先确认存在,才能执行删除,否则会撤销掉不属于该串的经过痕迹
    if (count_exact(s) == 0) return;

    int root = 0;
    for (int i = 0; i < (int)s.length(); i++) {
        int id = s[i] - 'a';
        root = tree[root][id];
        pass_cnt[root]--; // 撤销经过的痕迹
    }
    end_cnt[root]--; // 撤销结尾标记
}

void solve() {
    int q;
    if (!(cin >> q)) return;
    while (q--) {
        int op;
        string s;
        cin >> op >> s;
        if (op == 1) insert(s);
        else if (op == 2) cout << count_exact(s) << "\n";
        else if (op == 3) cout << count_prefix(s) << "\n";
        else if (op == 4) remove(s);
    }
}

int main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
3. 选学:Trie 的隐藏天赋——DFS 字典序遍历
由于字典树每个节点的子节点天然按照 a-z 的顺序存放在 tree 数组的
配合前面的计数数组,我们可以轻松实现字典序遍历:
// 接在上一小节的增强版 Trie 中使用,从 dfs(0, "") 开始遍历
// 依赖全局数组:tree, pass_cnt, end_cnt
// 字典树 DFS 遍历:按字典序打印所有存在的字符串
void dfs(int root, string current_str) {
    // 遇到被彻底删除的分支,或者尚未修通的分支,直接剪枝
    if (root != 0 && pass_cnt[root] == 0) return;

    // 如果这里有完整单词,有几个就打印几次
    for (int k = 0; k < end_cnt[root]; k++) {
        cout << current_str << "\n";
    }

    // 严格按照 a-z 的顺序向下搜索,保证天然字典序
    for (int i = 0; i < 26; i++) {
        if (tree[root][i]) {
            dfs(tree[root][i], current_str + char(i + 'a'));
        }
    }
}
六、前瞻阅读:Trie 的局限与 AC 自动机
字典树能极快地验证“某个给定单词是否在词典中”。但如果在实战中,我们把问题反过来:给定一篇长达十万字的文章,要求找出词典里所有的违禁词是否出现过。
如果依然使用基础的 Trie,我们必须从文章的第 1 个字符开始查;一旦查不下去,就必须倒退回文章的第 2 个字符,从字典树根节点重新查一遍。这与字符串暴力匹配的主串回溯痛点如出一辙,面对极端情况会退化成极其缓慢的算法。
学完后面的 KMP 讲义会看到,通过计算 Border 数组,可以实现“主串永不回头”。当我们将 KMP 的不回溯思想武装到 Trie 的树形结构上时,就诞生了多模式匹配的大杀器——AC 自动机 (Aho-Corasick Automaton)。
它对字典树最大的改造,就是为所有节点增加了一条不同于“父指针”的Fail 指针(失配指针):
- 父指针:沿着原本插入单词的路径往回走,对应的物理动作是“缩短当前单词的前缀”。
- Fail 指针:像 KMP 的回跳一样,指向当前串的真后缀中,能够在 Trie 中找到的最长者所对应的节点。它可能在另一条分支,也可能在自己这条路上(如
aa→a)。一旦当前字符匹配失败,就顺着 Fail 指针退到这个较短的状态继续匹配。
有了这套机制,文章指针将一路向前,再也不需要回头重扫。AC 自动机属后续新课,本套不展开,这里先记住它解决的是多个模式串的匹配问题。
七、字符串算法特征对比与适用场景
| 比较维度 | 暴力比对 (Brute Force) | 字符串哈希 (String Hash) | 字典树 (Trie) |
|---|---|---|---|
| 底层机制 | 字符数组逐位比对 | 多项式取模映射为整数 | 多维数组构建状态转移图 |
| 典型操作及耗时 | 两个串逐位比对 |
预处理后提取子串哈希 |
在词典中查一个词 |
| 空间开销 | 极小 | 适中(需开辟一维数组) | 较大(二维状态转移表开销明显) |
| 核心优势 | 实现简单,无额外空间 | 灵活进行任意区间子串比对 | 高效处理公共前缀共享、精确查找与频率统计 |