一、暴力递推的死局:当 n n n 10 18 10^{18} 1 0 18
递推是我们在入门算法时最熟悉的朋友。比如最经典的斐波那契数列:
F 0 = 0 , F 1 = 1 , F t + 2 = F t + 1 + F t F_0 = 0,\quad F_1 = 1,\quad F_{t+2} = F_{t+1} + F_t F 0 = 0 , F 1 = 1 , F t + 2 = F t + 1 + F t 让你求第 n n n for 循环:开两个变量滚动累加,一步一步往后推,O ( n ) O(n) O ( n )
但如果出题人把数据范围改成了 n ≤ 10 18 n \le 10^{18} n ≤ 1 0 18
计算机每秒执行的基本运算大约是 10 8 10^8 1 0 8 10 18 10^{18} 1 0 18
痛点根源 :递推的本质是“单步更新”,每算一项就必须消耗一次循环。
破局思路 :回想我们在初学整数求幂 a n a^n a n 1 1 1 n n n O ( n ) O(n) O ( n ) 快速幂 ,我们可以把 a × a a \times a a × a a 2 a^2 a 2 a 4 , a 8 … a^4, a^8\dots a 4 , a 8 … log n \log n log n
那能不能把递推中“求下一项”的操作,也打包成一次乘法?
只要能把状态转移写成乘法的形式,我们就能把快速幂套上去,将庞大的 10 18 10^{18} 1 0 18 矩阵 。
二、破局魔法:把“一次转移”打包成矩阵乘法
线性代数的理论很深,但作为信奥选手,我们先不要去背那些抽象的行列式与特征值。今天我们只从状态转移的物理视角 来看矩阵。
1. 什么是状态行向量?
在信奥代码中,我们最习惯将当前的所有状态横排放在一个行向量 里。
假设系统里有两个变量 x x x y y y [ x , y ] [x, y] [ x , y ]
现在我们要执行一个操作:第一个量保持不变,第二个量变成两者的和 。也就是:
[ x , y ] ⟶ [ x , x + y ] [x, y] \longrightarrow [x, x + y] [ x , y ] ⟶ [ x , x + y ] 我们把这个变化规则写成一个表格(矩阵),排成两行两列:
[ x , y ] ( 1 1 0 1 ) = [ x , x + y ] [x, y] \begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix} = [x, x+y] [ x , y ] ( 1 0 1 1 ) = [ x , x + y ] 为什么是这个矩阵?我们来拆开看它的物理意义 :
第一列 负责拼出“新的第一个数”:旧的 x × 1 + y × 0 = x x \times 1 + y \times 0 = x x × 1 + y × 0 = x 第二列 负责拼出“新的第二个数”:旧的 x × 1 + y × 1 = x + y x \times 1 + y \times 1 = x + y x × 1 + y × 1 = x + y
记忆法则(关键) :
矩阵中的每一行,代表旧状态里的某一个变量 ;
矩阵中的每一列,代表新状态里的某一个变量的制造配方 !
我们把这个矩阵记为 A A A B B B
B = ( 1 0 1 1 ) B = \begin{pmatrix} 1 & 0 \\ 1 & 1 \end{pmatrix} B = ( 1 1 0 1 ) 如果从初始状态 [ 2 , 3 ] [2, 3] [ 2 , 3 ] A A A [ 2 , 5 ] [2, 5] [ 2 , 5 ] B B B [ 7 , 5 ] [7, 5] [ 7 , 5 ]
( [ 2 , 3 ] A ) B ([2, 3] A) B ([ 2 , 3 ] A ) B 2. 矩阵乘法的物理意义:中间人 k k k
能不能把操作 A A A B B B C = A B C = AB C = A B
数学上的矩阵乘法定义为:若 A A A r × s r \times s r × s B B B s × t s \times t s × t C = A B C = AB C = A B r × t r \times t r × t i i i j j j
C i j = ∑ k = 1 s A i k B k j C_{ij} = \sum_{k=1}^{s} A_{ik} B_{kj} C ij = k = 1 ∑ s A ik B kj 看懂这个式子,就抓住了矩阵乘法的灵魂:
k k k i i i k k k A i k A_{ik} A ik 接着从中转项 k k k j j j B k j B_{kj} B kj
把所有可能的中间人 k k k i i i j j j
正因为必须有“中间人”来对接,所以前一个矩阵的列数必须等于后一个矩阵的行数 ,否则中转接口完全对不上。
我们亲手算一下刚才的 A × B A \times B A × B
A B = ( 1 1 0 1 ) ( 1 0 1 1 ) = ( 1 × 1 + 1 × 1 1 × 0 + 1 × 1 0 × 1 + 1 × 1 0 × 0 + 1 × 1 ) = ( 2 1 1 1 ) AB = \begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix} \begin{pmatrix} 1 & 0 \\ 1 & 1 \end{pmatrix} = \begin{pmatrix} 1 \times 1 + 1 \times 1 & 1 \times 0 + 1 \times 1 \\ 0 \times 1 + 1 \times 1 & 0 \times 0 + 1 \times 1 \end{pmatrix} = \begin{pmatrix} 2 & 1 \\ 1 & 1 \end{pmatrix} A B = ( 1 0 1 1 ) ( 1 1 0 1 ) = ( 1 × 1 + 1 × 1 0 × 1 + 1 × 1 1 × 0 + 1 × 1 0 × 0 + 1 × 1 ) = ( 2 1 1 1 ) 我们用合成后的矩阵来算一次:[ 2 , 3 ] ( 2 1 1 1 ) = [ 2 × 2 + 3 × 1 , 2 × 1 + 3 × 1 ] = [ 7 , 5 ] [2, 3] \begin{pmatrix} 2 & 1 \\ 1 & 1 \end{pmatrix} = [2 \times 2 + 3 \times 1, 2 \times 1 + 3 \times 1] = [7, 5] [ 2 , 3 ] ( 2 1 1 1 ) = [ 2 × 2 + 3 × 1 , 2 × 1 + 3 × 1 ] = [ 7 , 5 ]
如果倒过来算 B A BA B A
B A = ( 1 1 1 2 ) BA = \begin{pmatrix} 1 & 1 \\ 1 & 2 \end{pmatrix} B A = ( 1 1 1 2 ) 从 [ 2 , 3 ] [2, 3] [ 2 , 3 ] B A BA B A [ 5 , 8 ] [5, 8] [ 5 , 8 ] 致命警告 :矩阵乘法不满足交换律 (A B ≠ B A AB \ne BA A B = B A
3. 为什么能用快速幂?结合律与单位矩阵
虽然矩阵乘法不能随意交换前后顺序,但它严格满足结合律 :
( A B ) C = A ( B C ) (AB)C = A(BC) ( A B ) C = A ( BC ) 只要顺序不变,先算哪一对完全自由!
如果我们要连续做 n n n T T T
S n = S 0 × T × T × ⋯ × T ⏟ n 个 = S 0 × T n S_n = S_0 \times \underbrace{T \times T \times \dots \times T}_{n \text{ 个}} = S_0 \times T^n S n = S 0 × n 个 T × T × ⋯ × T = S 0 × T n 既然满足结合律,我们就可以把 T × T T \times T T × T T 2 T^2 T 2 T 2 × T 2 T^2 \times T^2 T 2 × T 2 T 4 T^4 T 4 快速幂 。
在整数快速幂里,乘法的初始基础是 1 1 1 单位矩阵 I I I :
主对角线全为 1 1 1 0 0 0
I = ( 1 0 … 0 0 1 … 0 ⋮ ⋮ ⋱ ⋮ 0 0 … 1 ) I = \begin{pmatrix} 1 & 0 & \dots & 0 \\ 0 & 1 & \dots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & \dots & 1 \end{pmatrix} I = 1 0 ⋮ 0 0 1 ⋮ 0 … … ⋱ … 0 0 ⋮ 1 单位矩阵的物理意义极其纯粹:什么都不做,让所有状态完美保持原样 。任何矩阵乘上单位矩阵都等于自身(T I = I T = T TI = IT = T T I = I T = T T 0 = I T^0 = I T 0 = I
三、经典第一战:斐波那契数列的极速突围
1. 状态设计与系数推导
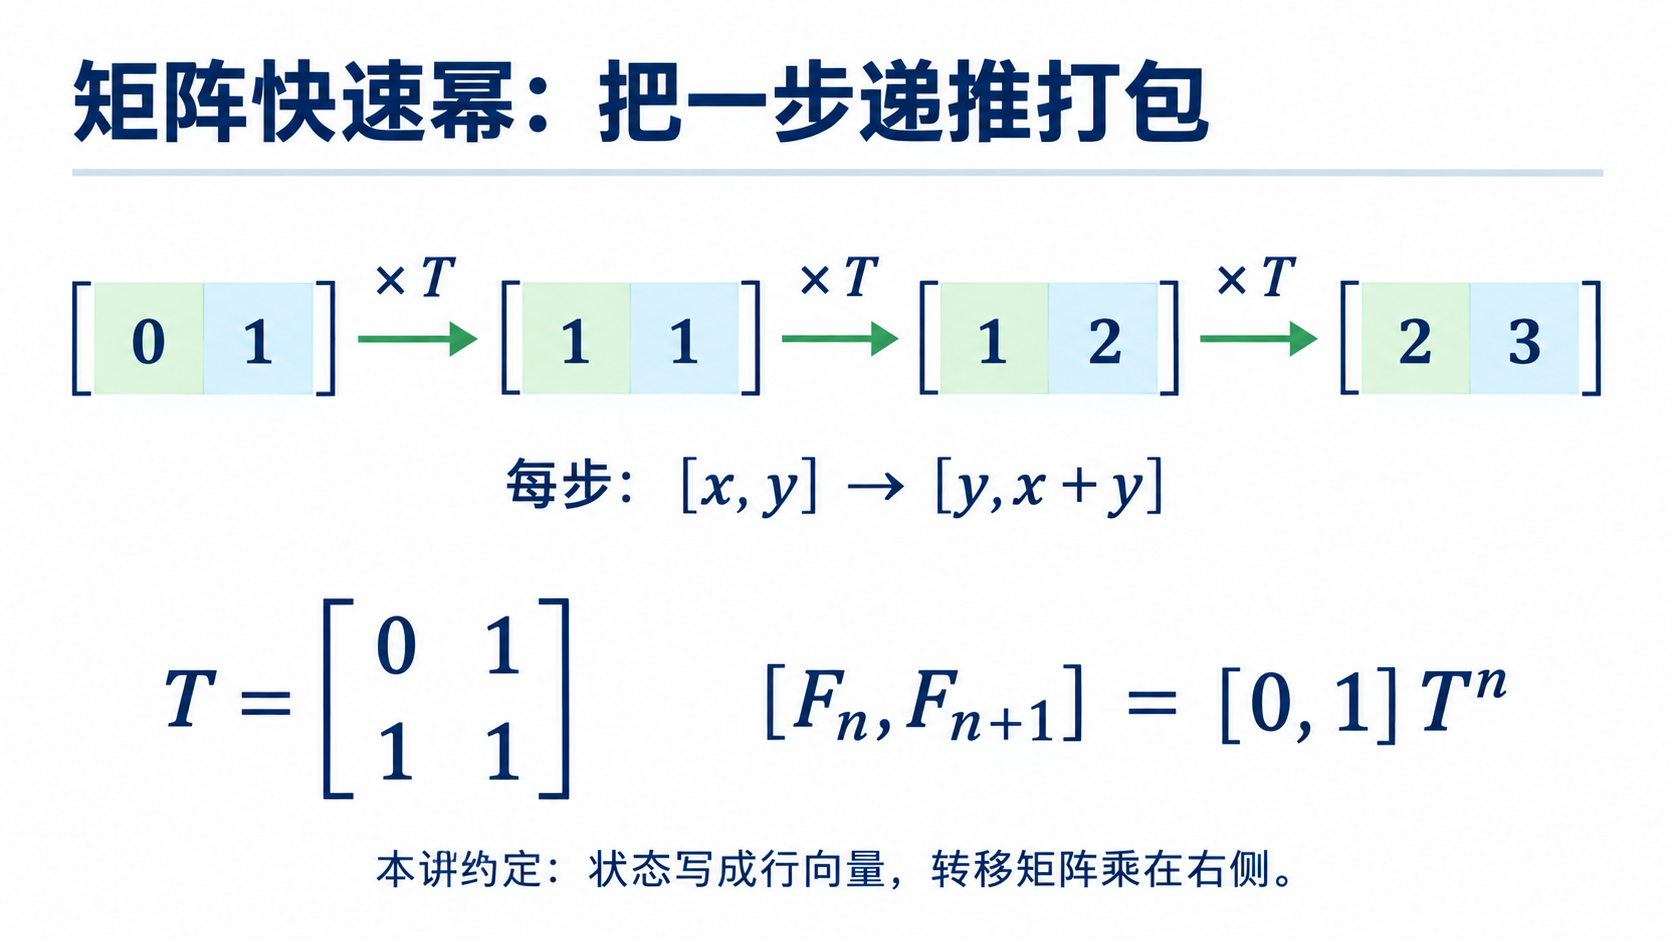
现在我们来攻克斐波那契数列:F t + 2 = F t + 1 + F t F_{t+2} = F_{t+1} + F_t F t + 2 = F t + 1 + F t
想要算出下一项,光知道当前项 F t F_t F t 灵魂状态向量 必须打包两个变量:
S t = [ F t , F t + 1 ] S_t = [F_t, F_{t+1}] S t = [ F t , F t + 1 ] 我们的目标是找到一个 2 × 2 2 \times 2 2 × 2 T T T
[ F t , F t + 1 ] × T = [ F t + 1 , F t + 2 ] = [ F t + 1 , F t + F t + 1 ] [F_t, F_{t+1}] \times T = [F_{t+1}, F_{t+2}] = [F_{t+1}, F_t + F_{t+1}] [ F t , F t + 1 ] × T = [ F t + 1 , F t + 2 ] = [ F t + 1 , F t + F t + 1 ] 按照前面讲的“看列填系数”法则:
新状态的第 1 格 需要变成 F t + 1 F_{t+1} F t + 1 0 × F t + 1 × F t + 1 0 \times F_t + 1 \times F_{t+1} 0 × F t + 1 × F t + 1 ( 0 1 ) \begin{pmatrix} 0 \\ 1 \end{pmatrix} ( 0 1 ) 新状态的第 2 格 需要变成 F t + F t + 1 F_t + F_{t+1} F t + F t + 1 1 × F t + 1 × F t + 1 1 \times F_t + 1 \times F_{t+1} 1 × F t + 1 × F t + 1 ( 1 1 ) \begin{pmatrix} 1 \\ 1 \end{pmatrix} ( 1 1 )
把两列拼起来,转移矩阵 T T T
T = ( 0 1 1 1 ) T = \begin{pmatrix} 0 & 1 \\ 1 & 1 \end{pmatrix} T = ( 0 1 1 1 ) 我们手推演练一下从初态 S 0 = [ F 0 , F 1 ] = [ 0 , 1 ] S_0 = [F_0, F_1] = [0, 1] S 0 = [ F 0 , F 1 ] = [ 0 , 1 ]
[ 0 , 1 ] T = [ 1 , 1 ] = [ F 1 , F 2 ] [0, 1] T = [1, 1] = [F_1, F_2] [ 0 , 1 ] T = [ 1 , 1 ] = [ F 1 , F 2 ] [ 1 , 1 ] T = [ 1 , 2 ] = [ F 2 , F 3 ] [1, 1] T = [1, 2] = [F_2, F_3] [ 1 , 1 ] T = [ 1 , 2 ] = [ F 2 , F 3 ] [ 1 , 2 ] T = [ 2 , 3 ] = [ F 3 , F 4 ] [1, 2] T = [2, 3] = [F_3, F_4] [ 1 , 2 ] T = [ 2 , 3 ] = [ F 3 , F 4 ] [ 2 , 3 ] T = [ 3 , 5 ] = [ F 4 , F 5 ] [2, 3] T = [3, 5] = [F_4, F_5] [ 2 , 3 ] T = [ 3 , 5 ] = [ F 4 , F 5 ]
转移一次下标推进一步,因此转移 n n n
[ F n , F n + 1 ] = [ 0 , 1 ] T n [F_n, F_{n+1}] = [0, 1] T^n [ F n , F n + 1 ] = [ 0 , 1 ] T n
2. 答案坐标怎么取?别靠猜!
设矩阵 T n T^n T n
T n = ( a b c d ) T^n = \begin{pmatrix} a & b \\ c & d \end{pmatrix} T n = ( a c b d ) 那么最终的状态行向量为:
[ F n , F n + 1 ] = [ 0 , 1 ] ( a b c d ) = [ 0 × a + 1 × c , 0 × b + 1 × d ] = [ c , d ] [F_n, F_{n+1}] = [0, 1] \begin{pmatrix} a & b \\ c & d \end{pmatrix} = [0 \times a + 1 \times c,\quad 0 \times b + 1 \times d] = [c, d] [ F n , F n + 1 ] = [ 0 , 1 ] ( a c b d ) = [ 0 × a + 1 × c , 0 × b + 1 × d ] = [ c , d ] 对比左右两边,立即得到:
F n = c F_n = c F n = c T n T^n T n 第 1 行第 0 列 的元素(采用 0-based 数组下标即 R.a[1][0])!F n + 1 = d F_{n+1} = d F n + 1 = d R.a[1][1]。
考场上千万不要去死记最后答案是取 a[0][0] 还是 a[1][0]。花 5 秒钟写出初态行向量 [ 0 , 1 ] [0, 1] [ 0 , 1 ]
3. 核心模板一:斐波那契极速求解
输入输出协议与范围 :
输入:一个非负整数 n n n 0 ≤ n ≤ 10 18 0 \le n \le 10^{18} 0 ≤ n ≤ 1 0 18
输出:F n m o d 1000000007 F_n \bmod 1000000007 F n mod 1000000007
样例测试:
复杂度:矩阵大小为常数 2 2 2 2 3 = 8 2^3 = 8 2 3 = 8 O ( log n ) O(\log n) O ( log n ) O ( 1 ) O(1) O ( 1 )
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int MOD=1000000007 ;
struct Mat {
int a[2 ][2 ];
Mat (){
memset (a,0 ,sizeof (a));
}
};
Mat mul (const Mat& A,const Mat& B) {
Mat C;
for (int i=0 ;i<2 ;i++){
for (int k=0 ;k<2 ;k++){
if (!A.a[i][k]) continue ;
for (int j=0 ;j<2 ;j++){
C.a[i][j]=(C.a[i][j]+A.a[i][k]*B.a[k][j])%MOD;
}
}
}
return C;
}
Mat power (Mat A,int k) {
Mat R;
R.a[0 ][0 ]=R.a[1 ][1 ]=1 ;
while (k){
if (k&1 ) R=mul (R,A);
A=mul (A,A);
k>>=1 ;
}
return R;
}
void solve () int n;
if (!(cin>>n)) return ;
Mat T;
T.a[0 ][0 ]=0 ; T.a[0 ][1 ]=1 ;
T.a[1 ][0 ]=1 ; T.a[1 ][1 ]=1 ;
Mat R=power (T,n);
cout<<R.a[1 ][0 ]<<'\n' ;
}
signed main () sync_with_stdio (0 ),cin.tie (0 );
solve ();
return 0 ;
}
四、状态构造的降维拆解:变式递推如何搭积木?
学会了斐波那契,最怕换一道递推题就两眼抹黑。其实构造转移矩阵有一套通用的“搭积木流程”:
确定状态维度 :写出递推式,看要推出下一时刻,最少需要抓住历史上的哪几个量。写出行向量 :把这些量排成一行 [ x 1 , x 2 , … ] [x_1, x_2, \dots] [ x 1 , x 2 , … ] 按列配平系数 :针对每一个目标新变量,看它由旧变量的几倍相加而成,依次把系数填进对应的列。
1. 变式 1:带系数的二阶线性递推
递推式 :f t + 2 = 2 f t + 1 + 3 f t f_{t+2} = 2f_{t+1} + 3f_t f t + 2 = 2 f t + 1 + 3 f t f 0 = 1 , f 1 = 2 f_0 = 1, f_1 = 2 f 0 = 1 , f 1 = 2
我们依然维护当前两项 [ f t , f t + 1 ] [f_t, f_{t+1}] [ f t , f t + 1 ] [ f t + 1 , 3 f t + 2 f t + 1 ] [f_{t+1}, 3f_t + 2f_{t+1}] [ f t + 1 , 3 f t + 2 f t + 1 ]
新第 1 格:0 × f t + 1 × f t + 1 0 \times f_t + 1 \times f_{t+1} 0 × f t + 1 × f t + 1 → \to → ( 0 1 ) \begin{pmatrix} 0 \\ 1 \end{pmatrix} ( 0 1 )
新第 2 格:3 × f t + 2 × f t + 1 3 \times f_t + 2 \times f_{t+1} 3 × f t + 2 × f t + 1 → \to → ( 3 2 ) \begin{pmatrix} 3 \\ 2 \end{pmatrix} ( 3 2 )
转移矩阵立得:
T = ( 0 3 1 2 ) T = \begin{pmatrix} 0 & 3 \\ 1 & 2 \end{pmatrix} T = ( 0 1 3 2 ) 我们手算验算:
初态为 [ 1 , 2 ] [1, 2] [ 1 , 2 ] [ 1 , 2 ] ( 0 3 1 2 ) = [ 2 , 1 × 3 + 2 × 2 ] = [ 2 , 7 ] [1, 2] \begin{pmatrix} 0 & 3 \\ 1 & 2 \end{pmatrix} = [2, 1 \times 3 + 2 \times 2] = [2, 7] [ 1 , 2 ] ( 0 1 3 2 ) = [ 2 , 1 × 3 + 2 × 2 ] = [ 2 , 7 ] f 1 = 2 , f 2 = 7 f_1=2, f_2=7 f 1 = 2 , f 2 = 7 [ 2 , 7 ] ( 0 3 1 2 ) = [ 7 , 2 × 3 + 7 × 2 ] = [ 7 , 20 ] [2, 7] \begin{pmatrix} 0 & 3 \\ 1 & 2 \end{pmatrix} = [7, 2 \times 3 + 7 \times 2] = [7, 20] [ 2 , 7 ] ( 0 1 3 2 ) = [ 7 , 2 × 3 + 7 × 2 ] = [ 7 , 20 ] f 2 = 7 , f 3 = 20 f_2=7, f_3=20 f 2 = 7 , f 3 = 20 n n n T n T^n T n
[ f n , f n + 1 ] = [ 1 , 2 ] T n = [ 1 × ( T n ) 0 , 0 + 2 × ( T n ) 1 , 0 , 1 × ( T n ) 0 , 1 + 2 × ( T n ) 1 , 1 ] [f_n, f_{n+1}] = [1, 2] T^n = [1 \times (T^n)_{0,0} + 2 \times (T^n)_{1,0},\quad 1 \times (T^n)_{0,1} + 2 \times (T^n)_{1,1}] [ f n , f n + 1 ] = [ 1 , 2 ] T n = [ 1 × ( T n ) 0 , 0 + 2 × ( T n ) 1 , 0 , 1 × ( T n ) 0 , 1 + 2 × ( T n ) 1 , 1 ] 此时 f n f_n f n 1 × ( T n ) 0 , 0 + 2 × ( T n ) 1 , 0 1 \times (T^n)_{0,0} + 2 \times (T^n)_{1,0} 1 × ( T n ) 0 , 0 + 2 × ( T n ) 1 , 0
2. 变式 2:常数项骚扰 —— 引入“常数 1”扩维
递推式 :f t + 1 = 2 f t + 3 f_{t+1} = 2f_t + 3 f t + 1 = 2 f t + 3
多了一个带尾巴的常数 + 3 +3 + 3 扩维技巧 :如果一个量在递推中不是变量,我们也可以把它当成一个“永远不变的特殊变量”塞进状态向量!
我们构造状态向量为 [ f t , 1 ] [f_t, 1] [ f t , 1 ]
下一步的新第一格是 2 f t + 3 × 1 2f_t + 3 \times 1 2 f t + 3 × 1
下一步的新第二格常数必须维持为 1 1 1 0 × f t + 1 × 1 0 \times f_t + 1 \times 1 0 × f t + 1 × 1
矩阵立刻写出:
T = ( 2 0 3 1 ) T = \begin{pmatrix} 2 & 0 \\ 3 & 1 \end{pmatrix} T = ( 2 3 0 1 ) 验算:[ f t , 1 ] ( 2 0 3 1 ) = [ 2 f t + 3 , 1 ] [f_t, 1] \begin{pmatrix} 2 & 0 \\ 3 & 1 \end{pmatrix} = [2f_t + 3, 1] [ f t , 1 ] ( 2 3 0 1 ) = [ 2 f t + 3 , 1 ]
3. 变式 3:多阶递推的“传送带”法则
递推式 :f t = f t − 1 + f t − 2 + f t − 3 f_t = f_{t-1} + f_{t-2} + f_{t-3} f t = f t − 1 + f t − 2 + f t − 3 f 0 = 1 , f 1 = 1 , f 2 = 2 f_0=1, f_1=1, f_2=2 f 0 = 1 , f 1 = 1 , f 2 = 2
需要用到过去连续三项,状态向量就扩为三维 [ f t , f t + 1 , f t + 2 ] [f_t, f_{t+1}, f_{t+2}] [ f t , f t + 1 , f t + 2 ] [ f t + 1 , f t + 2 , f t + f t + 1 + f t + 2 ] [f_{t+1}, f_{t+2}, f_t + f_{t+1} + f_{t+2}] [ f t + 1 , f t + 2 , f t + f t + 1 + f t + 2 ]
前两格就像“传送带”一样往左平移一格:
新第 1 格取旧第 2 格:列为 ( 0 1 0 ) \begin{pmatrix} 0 \\ 1 \\ 0 \end{pmatrix} 0 1 0
新第 2 格取旧第 3 格:列为 ( 0 0 1 ) \begin{pmatrix} 0 \\ 0 \\ 1 \end{pmatrix} 0 0 1
新第 3 格把旧三项全部相加:列为 ( 1 1 1 ) \begin{pmatrix} 1 \\ 1 \\ 1 \end{pmatrix} 1 1 1
组合起来就是优雅的伴随矩阵:
T = ( 0 0 1 1 0 1 0 1 1 ) T = \begin{pmatrix} 0 & 0 & 1 \\ 1 & 0 & 1 \\ 0 & 1 & 1 \end{pmatrix} T = 0 1 0 0 0 1 1 1 1 4. 递推前缀和:把“历史账本”塞进矩阵
很多时候,题目不仅要求我们算出第 n n n n n n S n = ∑ i = 0 n F i S_n = \sum_{i=0}^n F_i S n = ∑ i = 0 n F i
如果单独算每一项再加起来,运算量又退化成了 O ( n ) O(n) O ( n ) 扩维策略 :把前缀和 S t S_t S t
以斐波那契数列为例,我们需要维护的状态从两个扩展到了三个:[ F t , F t + 1 , S t ] [F_t, F_{t+1}, S_t] [ F t , F t + 1 , S t ] [ F t + 1 , F t + 2 , S t + 1 ] [F_{t+1}, F_{t+2}, S_{t+1}] [ F t + 1 , F t + 2 , S t + 1 ] S t + 1 = S t + F t + 1 S_{t+1} = S_t + F_{t+1} S t + 1 = S t + F t + 1
按照“看列填系数”法则:
新第 1 格 (F t + 1 F_{t+1} F t + 1 0 × F t + 1 × F t + 1 + 0 × S t 0 \times F_t + 1 \times F_{t+1} + 0 \times S_t 0 × F t + 1 × F t + 1 + 0 × S t ( 0 1 0 ) \begin{pmatrix} 0 \\ 1 \\ 0 \end{pmatrix} 0 1 0 新第 2 格 (F t + 2 F_{t+2} F t + 2 1 × F t + 1 × F t + 1 + 0 × S t 1 \times F_t + 1 \times F_{t+1} + 0 \times S_t 1 × F t + 1 × F t + 1 + 0 × S t ( 1 1 0 ) \begin{pmatrix} 1 \\ 1 \\ 0 \end{pmatrix} 1 1 0 新第 3 格 (S t + 1 S_{t+1} S t + 1 0 × F t + 1 × F t + 1 + 1 × S t 0 \times F_t + 1 \times F_{t+1} + 1 \times S_t 0 × F t + 1 × F t + 1 + 1 × S t ( 0 1 1 ) \begin{pmatrix} 0 \\ 1 \\ 1 \end{pmatrix} 0 1 1
把这三列并排拼起来,得出的扩维转移矩阵为:
T = ( 0 1 0 1 1 1 0 0 1 ) T = \begin{pmatrix} 0 & 1 & 0 \\ 1 & 1 & 1 \\ 0 & 0 & 1 \end{pmatrix} T = 0 1 0 1 1 0 0 1 1
我们从初态 [ F 0 , F 1 , S 0 ] = [ 0 , 1 , 0 ] [F_0, F_1, S_0] = [0, 1, 0] [ F 0 , F 1 , S 0 ] = [ 0 , 1 , 0 ] [ 0 , 1 , 0 ] ( 0 1 0 1 1 1 0 0 1 ) = [ 1 , 1 , 1 ] [0, 1, 0] \begin{pmatrix} 0 & 1 & 0 \\ 1 & 1 & 1 \\ 0 & 0 & 1 \end{pmatrix} = [1, 1, 1] [ 0 , 1 , 0 ] 0 1 0 1 1 0 0 1 1 = [ 1 , 1 , 1 ] F 1 = 1 , F 2 = 1 , S 1 = 1 F_1=1, F_2=1, S_1=1 F 1 = 1 , F 2 = 1 , S 1 = 1 S 1 = F 0 + F 1 = 0 + 1 = 1 S_1 = F_0 + F_1 = 0 + 1 = 1 S 1 = F 0 + F 1 = 0 + 1 = 1 O ( log n ) O(\log n) O ( log n )
5. 周期性转移:将一组规律打包为“时间胶囊”
有时候,题目给的转移规律不是一成不变的,而是周期性变化的。
比如:第 1 秒按照矩阵 A A A B B B C C C A , B , C , A , B , C … A, B, C, A, B, C \dots A , B , C , A , B , C … k k k
这还能用快速幂吗?当然可以!虽然每个时刻矩阵不同,但矩阵乘法满足结合律,我们可以把一整个周期的转移 合并打包成一个总矩阵:
T p e r i o d = A × B × C T_{period} = A \times B \times C T p er i o d = A × B × C
行向量的物理直觉优势 :这里必须强调一下我们坚持使用行向量 的巨大优势!
因为状态在左侧,操作在右侧,状态演化的书写顺序是 [ S t a t e ] × A × B × C [State] \times A \times B \times C [ St a t e ] × A × B × C C × B × A × ( S t a t e ) C \times B \times A \times \begin{pmatrix} State \end{pmatrix} C × B × A × ( St a t e )
有了周期总矩阵 T p e r i o d T_{period} T p er i o d k k k
算出完整的周期数 p = k / 3 p = k / 3 p = k /3
对周期总矩阵做快速幂:R = ( T p e r i o d ) p R = (T_{period})^p R = ( T p er i o d ) p
算出剩下的零头步数 r e m = k m o d 3 rem = k \bmod 3 re m = k mod 3
最终状态就是:I n i t i a l _ S t a t e × R × ( 如果 r e m ≥ 1 再乘 A ) × ( 如果 r e m ≥ 2 再乘 B ) Initial\_State \times R \times (\text{如果 } rem \ge 1 \text{ 再乘 } A) \times (\text{如果 } rem \ge 2 \text{ 再乘 } B) I ni t ia l _ St a t e × R × ( 如果 re m ≥ 1 再乘 A ) × ( 如果 re m ≥ 2 再乘 B )
6. 边界警告:什么递推绝对不能直接打包?
这里的矩阵快速幂适合加速系数固定的线性递推 ,常数项可以像上一例一样,扩一维 1 1 1
非线性运算 :如果递推式是 f t = f t − 1 × f t − 2 f_t = f_{t-1} \times f_{t-2} f t = f t − 1 × f t − 2 动态变化的转移系数 :如果递推系数每一步都随时间 t t t
五、跨界融合:图论游走与邻接矩阵的连击魔法
现在,我们要把视线从数论递推跳跃到一个看起来截然不同的领域:图论 。
场景 :给出一张有向图,问:从起点 s s s 恰好走 k k k 到达终点 t t t (注意:这里允许重复经过顶点和边,允许有重边和自环,这种在图上漫步的路径称为“游走”)
1. 物理意义的升华:中间点就是中转站
我们用邻接矩阵 A A A A i j A_{ij} A ij i i i j j j
如果没有边,A i j = 0 A_{ij} = 0 A ij = 0
如果有 1 条边,A i j = 1 A_{ij} = 1 A ij = 1
如果有 2 条重边,A i j = 2 A_{ij} = 2 A ij = 2
走 1 步的方案数,显然就是矩阵 A A A
那走 2 步呢?
从 i i i j j j u u u
第一步从 i i i u u u A i u A_{iu} A i u
第二步从 u u u j j j A u j A_{uj} A u j
根据乘法原理,经过中转站 u u u A i u × A u j A_{iu} \times A_{uj} A i u × A u j u u u
∑ u A i u A u j \sum_u A_{iu} A_{uj} u ∑ A i u A u j 看看这个式子——这不就是矩阵乘法 A × A = A 2 A \times A = A^2 A × A = A 2 吗!
在代数推导里抽象的“下标 k k k 图上的中转节点 u u u !
同理:
走 3 步就是 A 3 A^3 A 3
恰好走 k k k k k k A k A^k A k !
从起点 s s s t t t k k k ( A k ) s t (A^k)_{st} ( A k ) s t
2. 三点小图的手推演练
给出一个具体的小图:
节点 1 到节点 2 有 2 条边
节点 2 到节点 1 有 1 条边
节点 2 到节点 3 有 1 条边
节点 3 到节点 3 有 1 条自环边
邻接矩阵 A A A
A = ( 0 2 0 1 0 1 0 0 1 ) A = \begin{pmatrix} 0 & 2 & 0 \\ 1 & 0 & 1 \\ 0 & 0 & 1 \end{pmatrix} A = 0 1 0 2 0 0 0 1 1 我们来问:从 1 出发恰好走 4 步到 3,有几种走法?
我们先手算 A 2 A^2 A 2
A 2 = A × A = ( 0 2 0 1 0 1 0 0 1 ) ( 0 2 0 1 0 1 0 0 1 ) = ( 2 0 2 0 2 1 0 0 1 ) A^2 = A \times A = \begin{pmatrix} 0 & 2 & 0 \\ 1 & 0 & 1 \\ 0 & 0 & 1 \end{pmatrix} \begin{pmatrix} 0 & 2 & 0 \\ 1 & 0 & 1 \\ 0 & 0 & 1 \end{pmatrix} = \begin{pmatrix} 2 & 0 & 2 \\ 0 & 2 & 1 \\ 0 & 0 & 1 \end{pmatrix} A 2 = A × A = 0 1 0 2 0 0 0 1 1 0 1 0 2 0 0 0 1 1 = 2 0 0 0 2 0 2 1 1 再算 A 4 = A 2 × A 2 A^4 = A^2 \times A^2 A 4 = A 2 × A 2 ( A 4 ) 1 , 3 = ∑ u ( A 2 ) 1 , u ( A 2 ) u , 3 = 2 × 2 + 0 × 1 + 2 × 1 = 4 + 0 + 2 = 6 (A^4)_{1,3} = \sum_u (A^2)_{1,u} (A^2)_{u,3} = 2 \times 2 + 0 \times 1 + 2 \times 1 = 4 + 0 + 2 = 6 ( A 4 ) 1 , 3 = ∑ u ( A 2 ) 1 , u ( A 2 ) u , 3 = 2 × 2 + 0 × 1 + 2 × 1 = 4 + 0 + 2 = 6
我们去图上肉眼验证这 6 种是哪来的:
路径类型 A:1 → 2 → 3 → 3 → 3 1 \to 2 \to 3 \to 3 \to 3 1 → 2 → 3 → 3 → 3 2 × 1 × 1 × 1 = 2 2 \times 1 \times 1 \times 1 = 2 2 × 1 × 1 × 1 = 2
路径类型 B:1 → 2 → 1 → 2 → 3 1 \to 2 \to 1 \to 2 \to 3 1 → 2 → 1 → 2 → 3 2 × 1 × 2 × 1 = 4 2 \times 1 \times 2 \times 1 = 4 2 × 1 × 2 × 1 = 4
3. 走 0 步的深刻内涵:为什么对角线必须是 1?
当 k = 0 k = 0 k = 0
如果起点就是终点(s = t s = t s = t 1 1 1
如果起点不同于终点(s ≠ t s \ne t s = t 0 0 0
这恰恰与单位矩阵 I I I 在物理层面上完美统一 !
4. 核心模板二:恰好走 k k k
输入输出协议与范围 :
第一行输入 5 个整数:n , m , k , s , t n, m, k, s, t n , m , k , s , t
点数 1 ≤ n ≤ 50 1 \le n \le 50 1 ≤ n ≤ 50
边数 0 ≤ m ≤ 10 4 0 \le m \le 10^4 0 ≤ m ≤ 1 0 4
步数 0 ≤ k ≤ 10 18 0 \le k \le 10^{18} 0 ≤ k ≤ 1 0 18
起点终点 1 ≤ s , t ≤ n 1 \le s, t \le n 1 ≤ s , t ≤ n
接下来 m m m u , v u, v u , v u u u v v v
输出一个整数:从 s s s t t t k k k 1000000007 1000000007 1000000007
复杂度:点数 n ≤ 50 n \le 50 n ≤ 50 O ( n 3 log k ) O(n^3 \log k) O ( n 3 log k ) O ( m ) O(m) O ( m ) O ( n 2 ) O(n^2) O ( n 2 )
样例输入 :
3 5 4 1 3
1 2
1 2
2 1
2 3
3 3
样例输出 :
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int MOD=1000000007 ;
const int N=55 ;
int n,m,k,s,t;
struct Mat {
int a[N][N];
Mat (){
memset (a,0 ,sizeof (a));
}
};
Mat mul (const Mat& A,const Mat& B) {
Mat C;
for (int i=1 ;i<=n;i++){
for (int k_mid=1 ;k_mid<=n;k_mid++){
if (!A.a[i][k_mid]) continue ;
for (int j=1 ;j<=n;j++){
C.a[i][j]=(C.a[i][j]+A.a[i][k_mid]*B.a[k_mid][j])%MOD;
}
}
}
return C;
}
Mat power (Mat A,int p) {
Mat R;
for (int i=1 ;i<=n;i++) R.a[i][i]=1 ;
while (p){
if (p&1 ) R=mul (R,A);
A=mul (A,A);
p>>=1 ;
}
return R;
}
void solve () if (!(cin>>n>>m>>k>>s>>t)) return ;
Mat A;
for (int i=1 ;i<=m;i++){
int u,v;
cin>>u>>v;
A.a[u][v]=(A.a[u][v]+1 )%MOD;
}
Mat R=power (A,k);
cout<<R.a[s][t]<<'\n' ;
}
signed main () sync_with_stdio (0 ),cin.tie (0 );
solve ();
return 0 ;
}
六、避坑指南:取模安全与防溢出铁律
1. 为什么 long long 不会在累加时爆掉?
在上面的乘法模板中,内层循环的核心语句是:
C.a[i][j] = (C.a[i][j] + A.a[i][k] * B.a[k][j]) % MOD;
很多同学会担心:乘积会很大,再加起来会不会爆 long long?
我们来看极值估算:
矩阵内每一个元素经过取模后,最大是 M O D − 1 ≈ 10 9 MOD - 1 \approx 10^9 MO D − 1 ≈ 1 0 9
两个数相乘,最大约为 ( 10 9 ) 2 = 10 18 (10^9)^2 = 10^{18} ( 1 0 9 ) 2 = 1 0 18
加上已经取模过的 C.a[i][j],总和最大约为 10 18 + 10 9 10^{18} + 10^9 1 0 18 + 1 0 9
而有符号 64 位整型 long long 的上限是 2 63 − 1 ≈ 9.22 × 10 18 2^{63}-1 \approx 9.22 \times 10^{18} 2 63 − 1 ≈ 9.22 × 1 0 18
因为我们每加一次就取一次模 ,运算过程牢牢被压在 10 18 10^{18} 1 0 18 n n n n = 50 n = 50 n = 50 50 × 10 18 = 5 × 10 19 > 9.22 × 10 18 50 \times 10^{18} = 5 \times 10^{19} > 9.22 \times 10^{18} 50 × 1 0 18 = 5 × 1 0 19 > 9.22 × 1 0 18 瞬间爆 long long 导致溢出变成负数 !考场上写这种“危险优化”极易爆零。
2. 模数的本质:矩阵快速幂需要质数吗?
很多同学做多了数论题,一看到取模就想费马小定理,以为 M O D MOD MO D 大错特错 !
矩阵快速幂在整个运行过程中,只涉及乘法和加法,根本没有除法(逆元)运算 。根据同余理论,加法和乘法对任意正整数模数都完美保持同余性质。哪怕模数是一个合数(比如 10 9 10^9 1 0 9 65536 65536 65536
七、图论进阶:Min-Plus 乘法与恰好 K 条边最短路(选学)
(先修要求:掌握《最短路与状态建图》中的 Floyd 全源最短路思想)
前面我们利用矩阵乘法 C i j = ∑ k A i k B k j C_{ij} = \sum_k A_{ik} B_{kj} C ij = ∑ k A ik B kj K K K s s s 恰好 K K K 到终点 t t t 最短距离 是多少?
我们重新审视传统乘法里的操作物理意义:
A i k × B k j A_{ik} \times B_{kj} A ik × B kj 累乘 ;∑ k \sum_k ∑ k k k k 累加 。
在最短路问题中,组合两段路径的逻辑变了:
经过中转站 k k k 相加 (A i k + B k j A_{ik} + B_{kj} A ik + B kj
在所有可能的中转站 k k k 最小的 (min k \min_k min k
我们大胆地把矩阵乘法的加法与乘法内核替换掉:
C i j = min k ( A i k + B k j ) C_{ij} = \min_{k} (A_{ik} + B_{kj}) C ij = k min ( A ik + B kj ) 这就是鼎鼎大名的 Min-Plus(最小-加)矩阵乘法 !
最神奇的是,因为 min ( a + b , a + c ) = a + min ( b , c ) \min(a+b, a+c) = a + \min(b, c) min ( a + b , a + c ) = a + min ( b , c ) 完美保留了结合律 !既然满足结合律,快速幂就能毫无保留地套上去,只需 O ( log K ) O(\log K) O ( log K ) K K K O ( n 3 log K ) O(n^3\log K) O ( n 3 log K )
1. 核心实现要点与避坑
使用 Min-Plus 乘法时,有几个致命的细节必须改掉:
初始化 :普通乘法找方案数,没边的格子是 0;Min-Plus 找最短路,没边的格子必须初始化为正无穷 INF。单位矩阵 :普通乘法的单位矩阵是对角线为 1,其余为 0;Min-Plus 乘法中,单位矩阵代表“走 0 步”。原地不动距离是 0,而0步飞到别的点是不可达 INF。所以它的单位矩阵是对角线全为 0,其余全为 INF !防溢出 :既然有加法,如果用系统的 INT_MAX,两个 INF 相加极易爆成负数。必须定义一个安全的无穷大,如 1e18。
2. 完整程序:恰好 K 条边最短路
自拟实战演练 :
输入 :第一行 n , m , k , s , t n, m, k, s, t n , m , k , s , t 1 ≤ n ≤ 50 , 0 ≤ m ≤ 1000 , 0 ≤ k ≤ 10 9 , 1 ≤ s , t ≤ n 1\le n\le 50, 0\le m\le 1000, 0\le k\le 10^9, 1\le s,t\le n 1 ≤ n ≤ 50 , 0 ≤ m ≤ 1000 , 0 ≤ k ≤ 1 0 9 , 1 ≤ s , t ≤ n m m m u , v , w u, v, w u , v , w u → v u \to v u → v w w w ∣ w ∣ ≤ 10 6 |w|\le10^6 ∣ w ∣ ≤ 1 0 6 10 15 10^{15} 1 0 15 INF=1e18。输出 :恰好走 k k k s s s t t t Impossible。样例输入 :3 3 2 1 3
1 2 5
2 3 4
1 3 1
样例输出 :9(解释:1->2->3 长度 9 恰好是两条边;1->3 长度 1 虽然更短,但只有一条边,不符合“恰好两步”的要求)。
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int INF = 1e18 ;
const int N = 55 ;
int n, m, k, s, t;
struct Mat {
int a[N][N];
Mat () {
for (int i=0 ; i<N; i++) {
for (int j=0 ; j<N; j++) {
a[i][j] = INF;
}
}
}
};
Mat mul (const Mat& A, const Mat& B) {
Mat C;
for (int i=1 ; i<=n; i++) {
for (int k_mid=1 ; k_mid<=n; k_mid++) {
if (A.a[i][k_mid] == INF) continue ;
for (int j=1 ; j<=n; j++) {
if (B.a[k_mid][j] == INF) continue ;
C.a[i][j] = min (C.a[i][j], A.a[i][k_mid] + B.a[k_mid][j]);
}
}
}
return C;
}
Mat power (Mat A, int p) {
Mat R;
for (int i=1 ; i<=n; i++) R.a[i][i] = 0 ;
while (p) {
if (p & 1 ) R = mul (R, A);
A = mul (A, A);
p >>= 1 ;
}
return R;
}
void solve () if (!(cin >> n >> m >> k >> s >> t)) return ;
Mat A;
for (int i=1 ; i<=m; i++) {
int u, v, w;
cin >> u >> v >> w;
A.a[u][v] = min (A.a[u][v], w);
}
Mat R = power (A, k);
if (R.a[s][t] >= INF) cout << "Impossible\n" ;
else cout << R.a[s][t] << '\n' ;
}
signed main () sync_with_stdio (0 ), cin.tie (0 );
solve ();
return 0 ;
}
八、渐进式实战练习题单
不要把矩阵快速幂当成冰冷的背诵模板,请通过以下阶梯练习建立肌肉记忆:
1. 阶段一:手动构造型练习
变式二阶线性递推实测
题目要求 :输入一个整数 n n n 0 ≤ n ≤ 10 18 0 \le n \le 10^{18} 0 ≤ n ≤ 1 0 18 f 0 = 1 , f 1 = 2 , f t + 2 = 2 f t + 1 + 3 f t f_0=1, f_1=2, f_{t+2}=2f_{t+1}+3f_t f 0 = 1 , f 1 = 2 , f t + 2 = 2 f t + 1 + 3 f t f n m o d 1000000007 f_n \bmod 1000000007 f n mod 1000000007 验证指引 :输入 3 输出 20;输入 0 输出 1。突破点 :修改第一份程序的转移矩阵系数,并注意当提取最终答案时,必须是初态向量 [ 1 , 2 ] [1, 2] [ 1 , 2 ]
2. 阶段二:边界特判与图论机制
零步与不可达特判测试
题目要求 :使用第二份图论程序,输入 2 0 0 1 1(没有边,步数为 0,起点终点均为 1),应当输出 1;将最后终点改成 2(输入 2 0 0 1 2),应当输出 0。突破点 :如果你的代码两个都输出了 0,说明单位矩阵没初始化好;如果两个都输出了 1,说明忘记判断起点与终点是否重合。
重边累乘爆炸测试
题目要求 :输入第一行 1 2 3 1 1,紧接着两行边均为 1 1(1 个点,2 条自环重边,走 3 步,从 1 到 1)。验证指引 :输出应为 8(因为每一步都有 2 条边可选,走 3 步就是 2 3 = 8 2^3 = 8 2 3 = 8
3. 阶段三:对拍与终极检验
编写小范围暴力验证器
训练要求 :对于图论游走,当 k ≤ 100 k \le 100 k ≤ 100 dp[step][u] 表示走 step 步到达节点 u 的方案数,每一层枚举每条边转移到 step + 1。突破点 :拿随机小图将这个小暴力程序与你的矩阵快速幂程序进行对拍,重点检测带有重边、自环、步数为 0 以及死胡同不可达等极限情况。亲眼见证 O ( k ) O(k) O ( k ) O ( log k ) O(\log k) O ( log k )