在许多算法与数据结构问题中,数据的取值范围极大(如
离散化的物理本质:在不改变数据之间相对大小顺序的前提下,将无限或极大的值域映射到
一、标准离散化:核心三步法
标准单点离散化的处理流水线分为三步:排序
1. 数组去重原理 (std::unique)
std::unique 本身只消除相邻的重复元素。为了在离散化中完成全局去重,我们先排序,让相同的值排在一起,再调用 unique。它把有效元素移到数组前部,并返回有效区间的尾后迭代器;不会缩小原数组,也不应再使用尾部无效区间中的内容。
在 1-based 数组体系下:
-
排序:
sort(b + 1, b + n + 1); -
去重并获取唯一元素个数
: m = unique(b + 1, b + n + 1) - (b + 1);去重后的元素存放在
b[1 ... m]中,严格单调递增。
2. 坐标映射 (std::lower_bound)
去重后,若要求原数组某个值 b[1 ... m] 上进行二分查找:
int id = lower_bound(b + 1, b + m + 1, x) - b;
当 b 时,id 落在 lower_bound 返回的是插入位置,可能等于
保留的是大小与相等关系,不是原始距离,也不是原数组的位置发生排序。 例如原序列
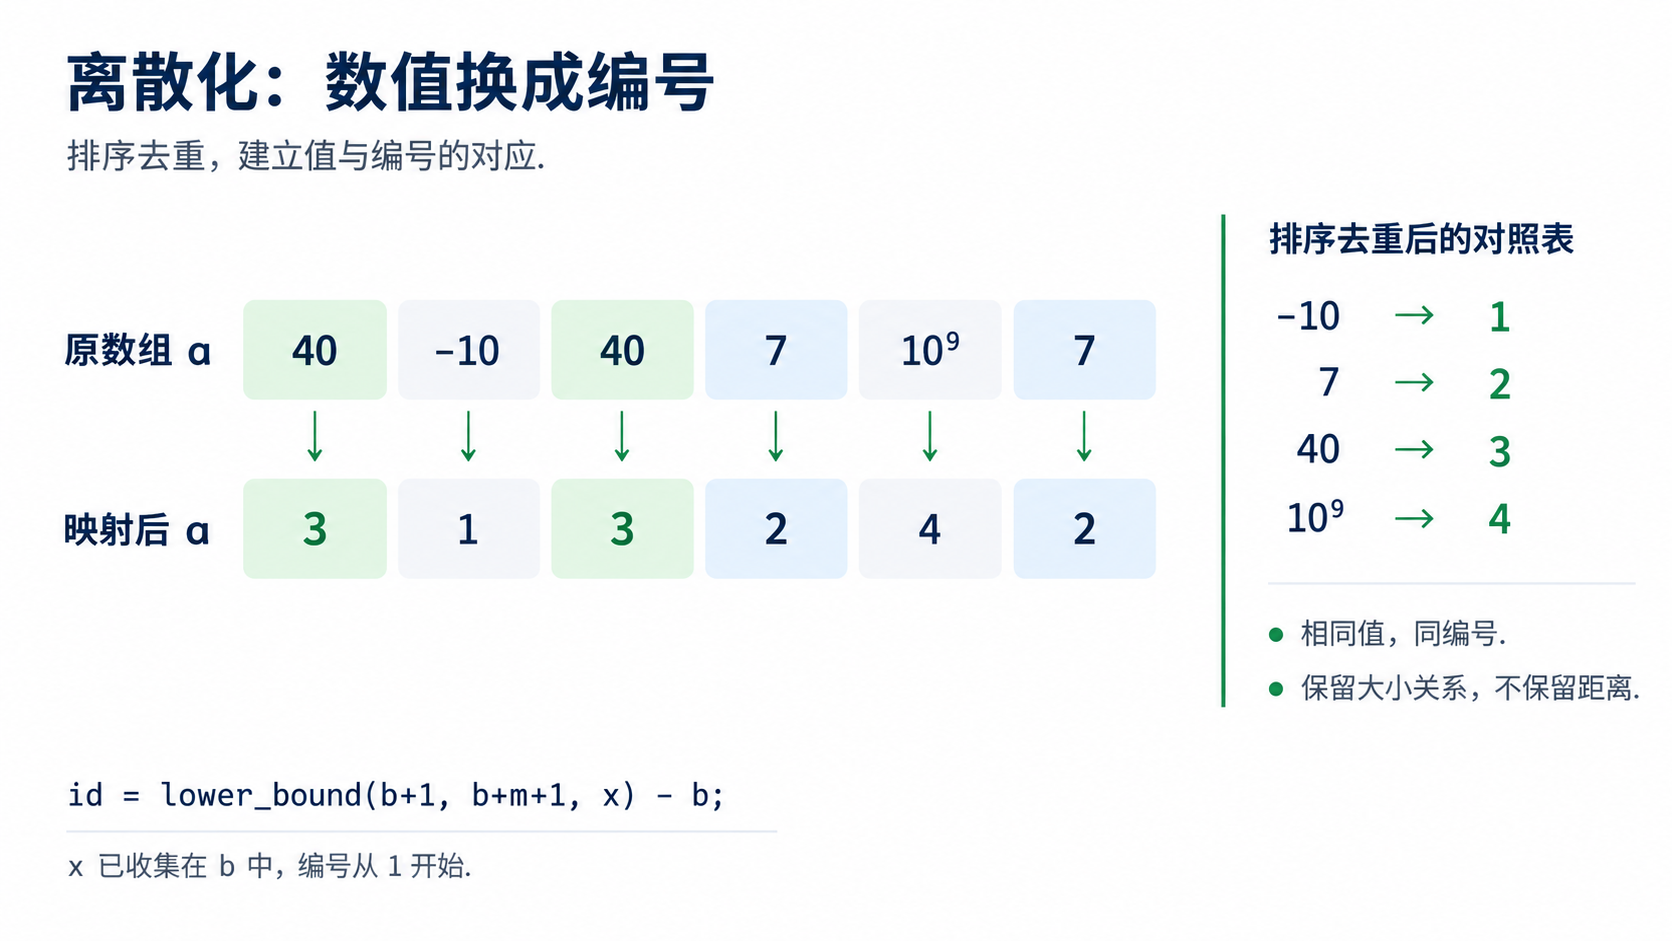
3. 标准模板实现
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;
int a[N],b[N];

void solve(){
	int n;
	cin>>n;
	for(int i=1;i<=n;i++){
		cin>>a[i];
		b[i]=a[i]; // 拷贝副本作映射基准
	}
	sort(b+1,b+n+1);
	int m=unique(b+1,b+n+1)-(b+1);

	// a[i] 映射为离散化后的值
	for(int i=1;i<=n;i++){
		a[i]=lower_bound(b+1,b+m+1,a[i])-b;
	}
	for(int i=1;i<=n;i++){
		cout<<a[i]<<(i==n?"":" ");
	}
	cout<<"\n";
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
二、离散化的两大核心变体与避坑点
1. 单点保序映射(数值大小关联)
若问题仅关心元素间的偏序关系(即
2. 区间离散化与“虚假相邻”陷阱(距离与覆盖关联)
区间问题要先分清:我们维护的是整数点的覆盖状态,还是连续线段的真实长度。离散化后相邻的编号,不代表原坐标相邻,也不代表相距
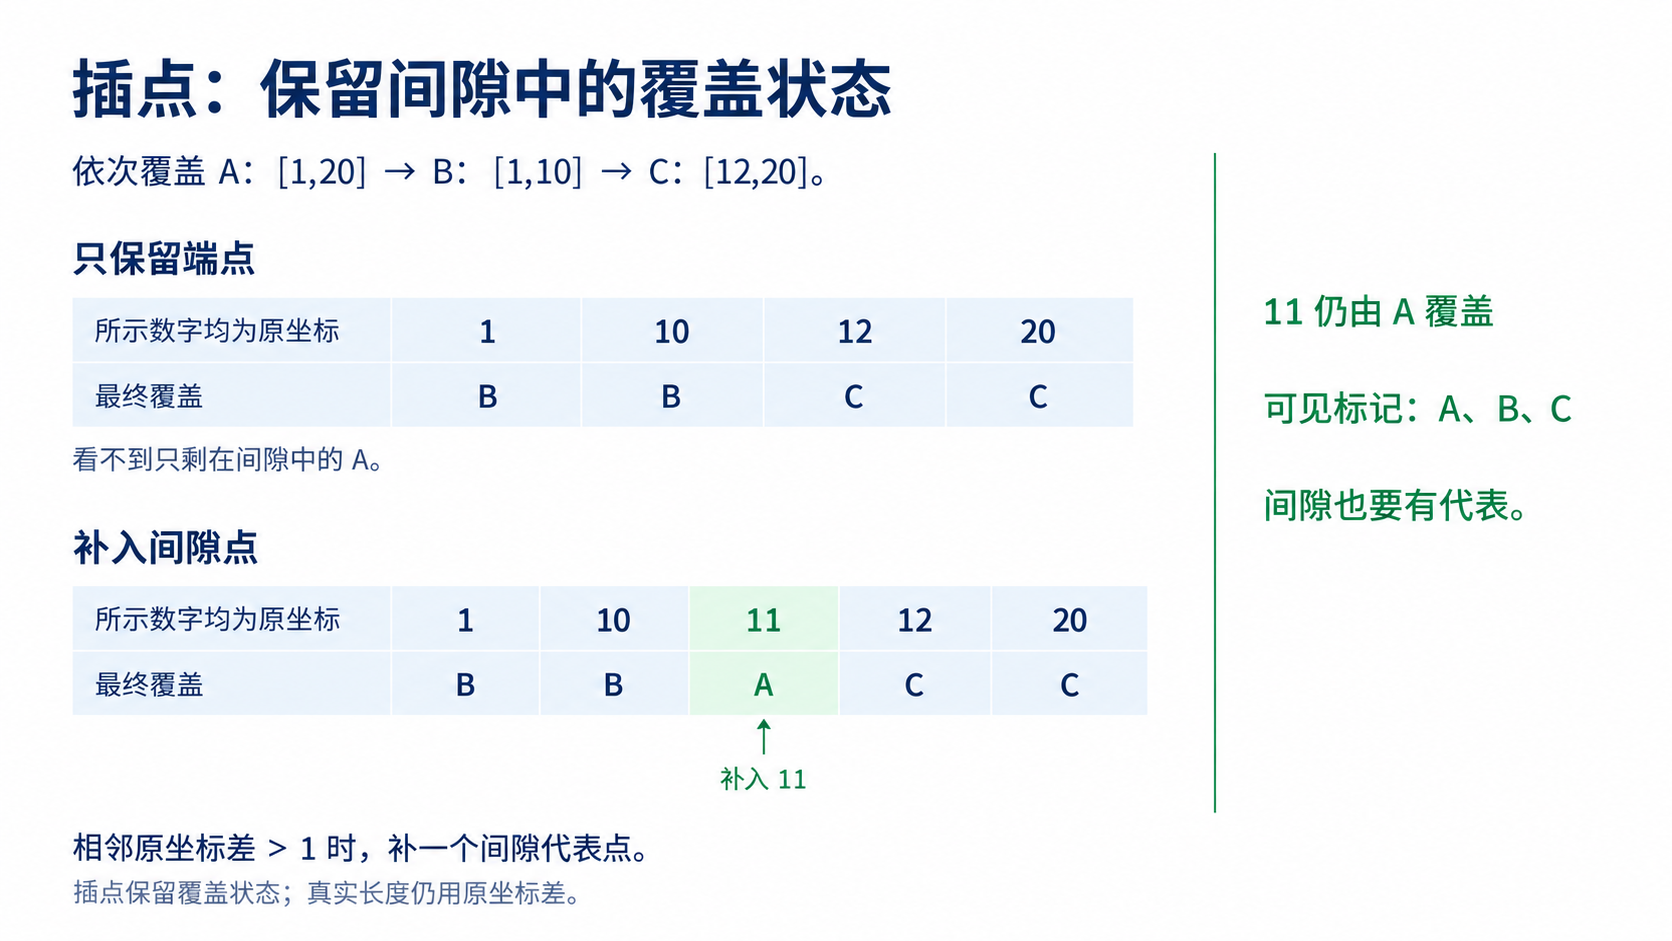
典型错误示例:只保留端点,漏掉中间的覆盖状态。
在整数点覆盖模型中,依次涂色:
- 先涂
; - 再涂
; - 最后涂
。
最终,点
若只保留端点
解决方案按维护对象区分:
- 方法 A(插点法,保留整数点覆盖状态):对排好序的相邻原坐标,若
,在中间补一个代表点,例如 ,再统一建立编号。本例补入 后,就能保留 的可见状态。代表点不能直接当作该间隙的真实长度。 - 方法 B(左闭右开元线段法,维护长度):只收集端点也可以正确计算连续长度。关键是把一个下标
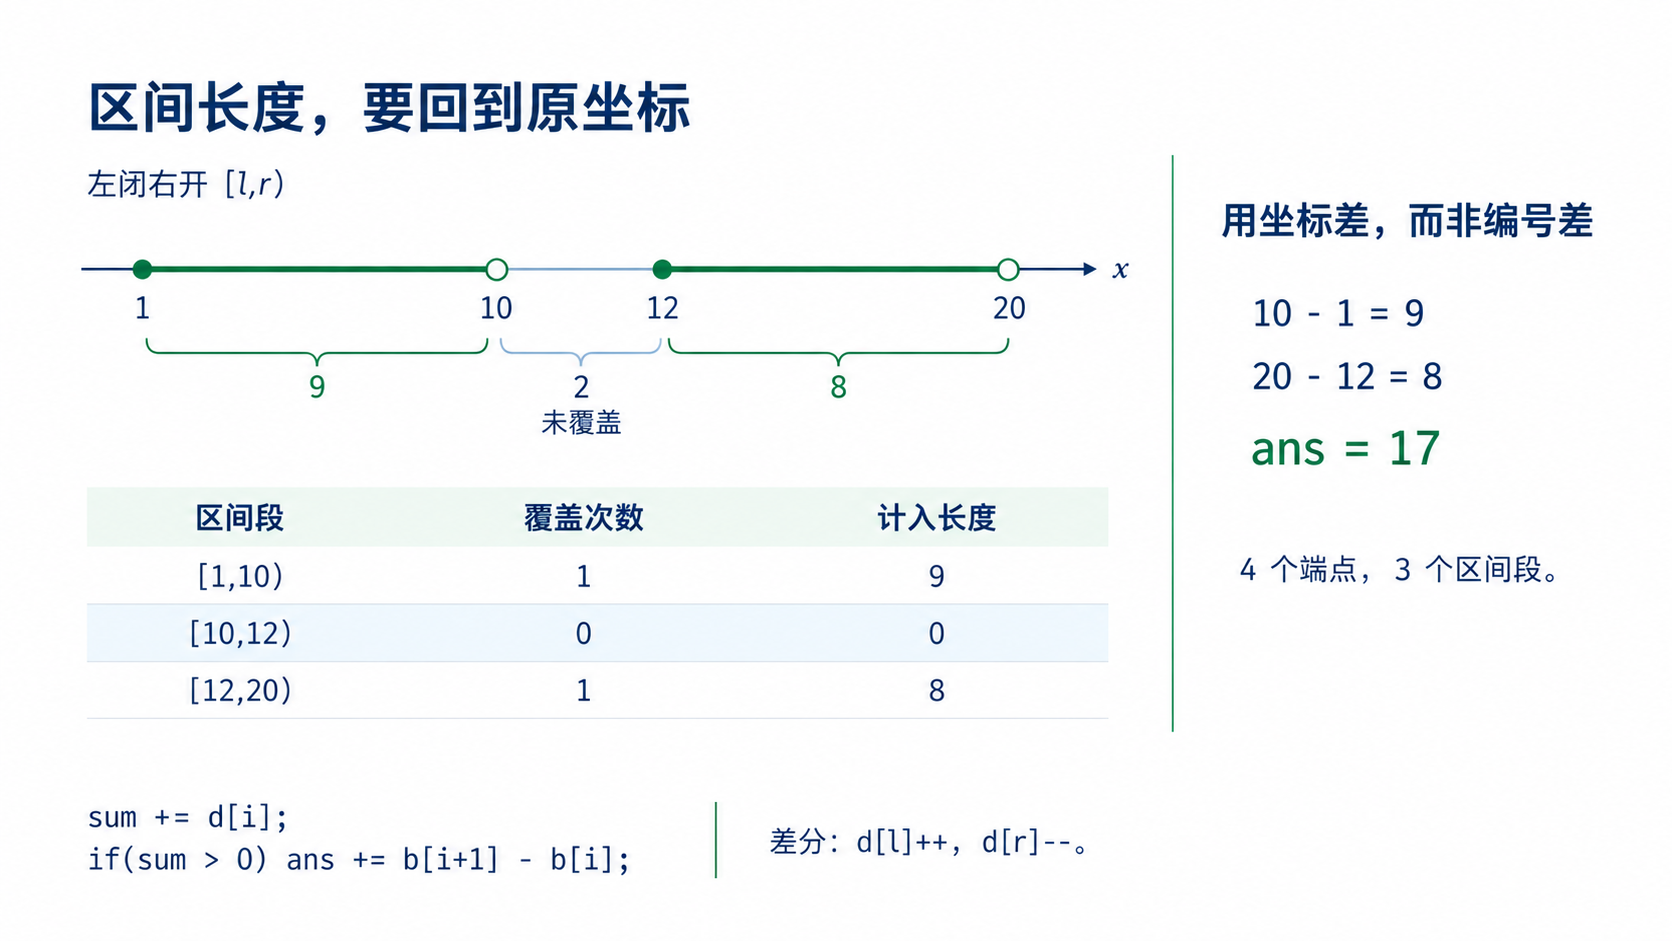
看作一段 ,该段长度为 。例如 与 的端点压缩后,未覆盖段 仍有独立的位置,总覆盖长度为 。
两种边界不要混用: 若题目给的是整数闭区间
,可以把它转成 再按段处理,并注意 的溢出。若题目本来求连续区间 的长度,就保留 ,不能额外加一。
三、实战模型解析
1. 模型一:单点离散化 + 树状数组求逆序对 (洛谷 P1908)
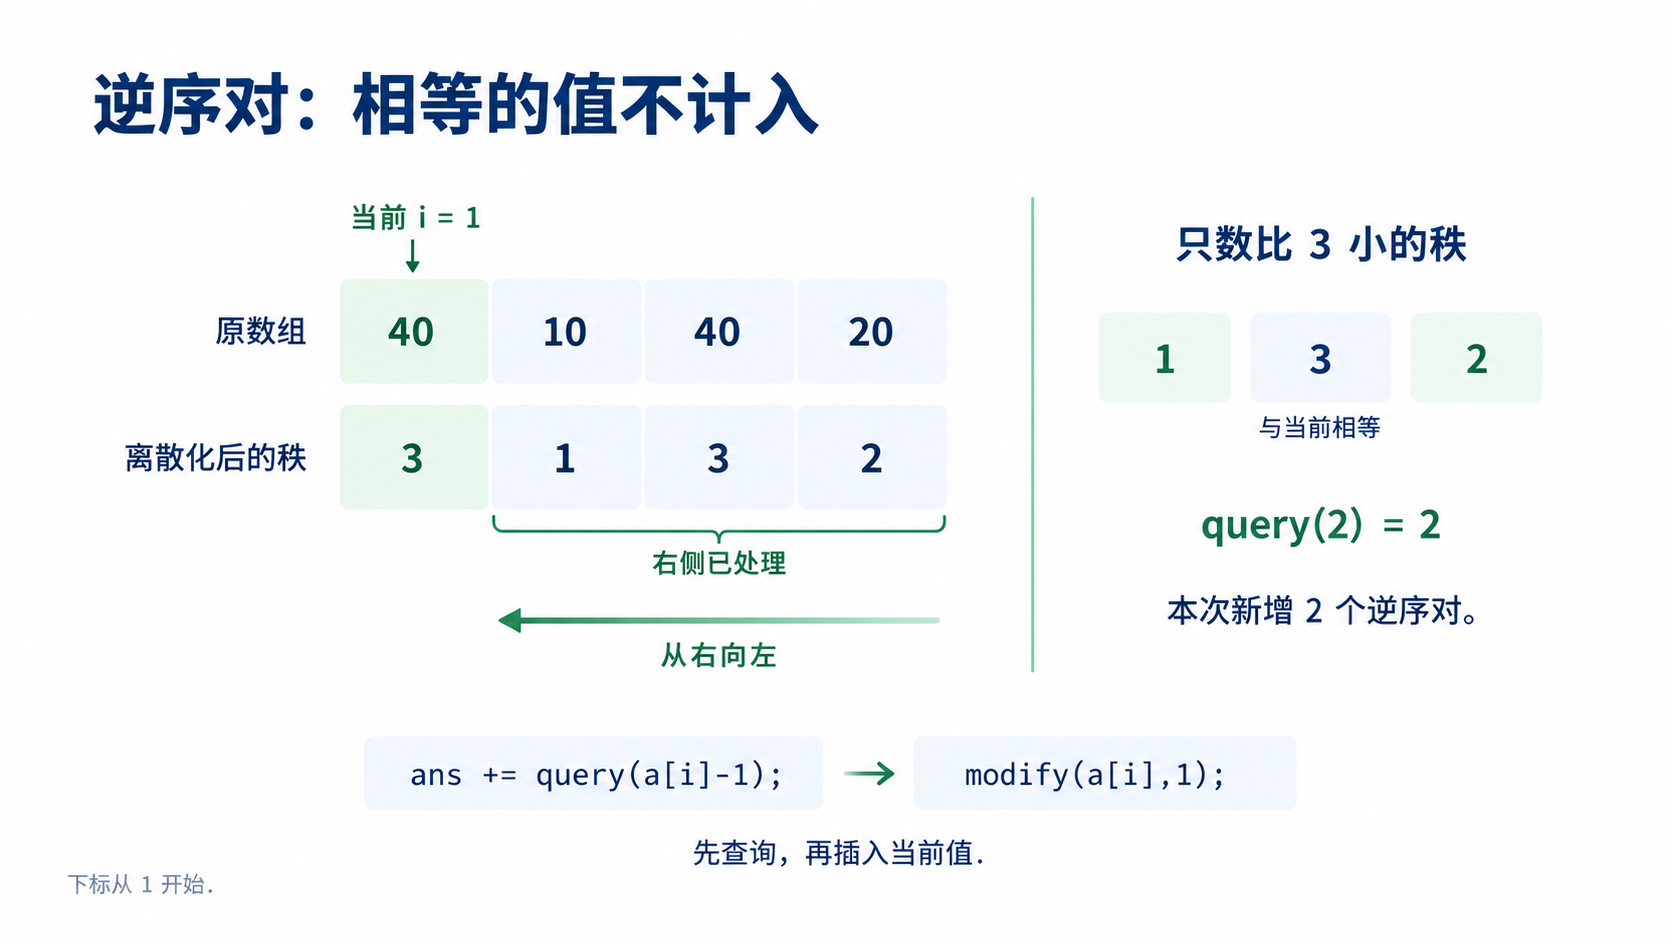
场景:求长度为
推导:
数值高达
为什么查询 a[i]-1? 逆序对要求严格大于,右侧与当前值相等的元素不能计入;树状数组维护的是右侧已处理元素的频次,所以先查询,再插入当前值。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=500005;

int a[N],b[N],tr[N];
int n,m;

int lowbit(int x){
	return x&-x;
}

void modify(int x,int c){
	for(int i=x;i<=m;i+=lowbit(i)) tr[i]+=c;
}

int query(int x){
	int sum=0;
	for(int i=x;i>0;i-=lowbit(i)) sum+=tr[i];
	return sum;
}

void solve(){
	cin>>n;
	for(int i=1;i<=n;i++){
		cin>>a[i];
		b[i]=a[i];
	}
	sort(b+1,b+n+1);
	m=unique(b+1,b+n+1)-(b+1);
	for(int i=1;i<=n;i++){
		a[i]=lower_bound(b+1,b+m+1,a[i])-b;
	}

	int ans=0;
	// 倒序遍历树状数组统计逆序对
	for(int i=n;i>=1;i--){
		ans+=query(a[i]-1);
		modify(a[i],1);
	}
	cout<<ans<<"\n";
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
2. 模型二:区间端点离散化与线段覆盖 (洛谷 P1496 火烧赤壁)
场景:数轴上有
推导:
直接将每个区间的起点
去重后得到序列
在离散化后的下标上利用差分数组 d 进行打标:对于区间 d[l]++ 与 d[r]--。
扫描前缀和:若某段微元
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=40005;

struct Node{
	int l,r;
}seg[N];

int b[N],d[N];

void solve(){
	int n;
	cin>>n;
	int cnt=0;
	for(int i=1;i<=n;i++){
		cin>>seg[i].l>>seg[i].r;
		b[++cnt]=seg[i].l;
		b[++cnt]=seg[i].r;
	}
	sort(b+1,b+cnt+1);
	int m=unique(b+1,b+cnt+1)-(b+1);

	for(int i=1;i<=n;i++){
		int l=lower_bound(b+1,b+m+1,seg[i].l)-b;
		int r=lower_bound(b+1,b+m+1,seg[i].r)-b;
		d[l]++;
		d[r]--; // 左闭右开微元区间差分
	}

	int ans=0,sum=0;
	for(int i=1;i<m;i++){
		sum+=d[i];
		if(sum>0){
			ans+=b[i+1]-b[i]; // 累加对应的实际物理长度
		}
	}
	cout<<ans<<"\n";
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
四、离散化的逆向查询与灵活二分
在很多高级数据结构题中,我们不仅要“把大数变成小数”,还要能“找回原来的数”,甚至面对一开始没见过的查询条件。
1. 还原原坐标:原值一直都在
离散化把原值映射成了秩(编号)。如果后续线段树查到了某个区间的最优解所在位置是编号 id,怎么输出它原本的坐标?
完全不需要额外的映射数组,去重后的 b 数组本身就是编号到原值的完美字典。
因为映射过程是 id = lower_bound(b + 1, b + m + 1, x) - b,那么对应地,b[id] 就是原值 x。
例如原坐标为 [10, 50, 100],映射后编号为 1, 2, 3。若最终答案落在编号 2,原坐标就是 b[2] = 50。
2. 阈值查询:没见过的
场景:你已经把给定的数组 b[1...m])。突然来了一个新查询:“统计当前数组中小于等于
推导:
其实根本不用把 b 数组。既然 b[1...m] 是单调递增的,我们只需要在 b 数组中找到最后一个小于等于 upper_bound 找第一个严格大于
// 在已去重的 b[1...m] 中,找原值 <= X 的最大编号
int id = upper_bound(b + 1, b + m + 1, X) - b - 1;

// 查询树状数组中编号 <= id 的频次和,就等价于查询原值 <= X 的频次和
int ans = query(id);
实战例子:
离散化数组 b 是 [10, 20, 50, 100](分别对应编号 1, 2, 3, 4)。
查询有多少个数 upper_bound 找 30,会指向 50(对应位置 3)。减去 1 得到编号 2。
这就意味着:“原值 query(2) 即可,完美绕开了重新离散化。
(注:如果 id 算出来是 query(0) 恰好返回
五、选型小练习:点与线段的直觉判定
在动手做综合大题前,先花一分钟测试自己的直觉:遇到区间题,我们该用单点映射,还是线段微元长度,还是会掉进虚假相邻陷阱?
- 情景 A:数轴上有
个哨塔,坐标很大。有 次询问,每次问坐标区间 内有几个哨塔。 判定:这是单点映射。只关心哨塔的相对位置,不用管它们隔得多远。用离散化把已知哨塔坐标压缩,查询时利用刚刚学的灵活二分把 转成离散编号 ,树状数组前缀和相减即可。 - 情景 B:施工队在公路上修路,给出每天修路的起止坐标
(允许重叠),求最终公路修好的总里程。 判定:这是线段长度。直接把所有端点放到一起排序去重,把相邻端点跨度 看作微元段。如果该微元段被覆盖,就累加其实际物理长度 。 - 情景 C:一面极长的墙,按整数块划分。每天用不同颜色的海报覆盖墙面
块。全部贴完后,墙上能看到多少种不同的颜色? 判定:这就是必须警惕的整数点覆盖(虚假相邻)!如果只把端点离散化,中间未被端点切分但仍残留着底色的海报段会被无情吞没。必须在不相邻的端点之间插点(补 b[i-1]+1),或者把转换成左闭右开 纳入边界池。
六、渐进式实战练习题单
1. 第一阶梯:单点映射与数据结构结合
- 洛谷 B3694 【模板】数列离散化
- 考点:排序、去重、查秩。
- 思路:直接练习三步法。注意本题有多组数据,先读入
,再执行 次 solve();前面的标准模板演示的是单组输入。
- 洛谷 P1097 [NOIP 2007 提高组] 统计数字
- 考点:基础去重与频次统计。
- 思路:对大数值进行排序后统计相邻同值块长度,或者离散化后开桶记录出现次数。
- 洛谷 P1908 逆序对
- 考点:单点离散化 + 树状数组/归并排序。
- 思路:将数值映射至
,用树状数组维护前缀频次,相等值不计入逆序对。 - 也可以不做离散化,直接在归并时统计,见《排序算法进阶》第一节。
- 洛谷 P1966 [NOIP 2013 提高组] 火柴排队
- 考点:两序列的秩对应 + 位置映射 + 逆序对。
- 思路:先由排序不等式确定同秩配对能够使平方差之和最小,再建立同秩元素的位置映射,用逆序对求最少相邻交换次数。原始高度决定距离的数值,但求最优配对及交换次数时只需保留秩关系。
2. 第二阶梯:区间离散化与线段差分
- 洛谷 P1496 火烧赤壁
- 考点:区间端点离散化 + 差分前缀和。
- 思路:按原题左闭右开区间建立微元段
,利用差分覆盖累计真实长度。
- 洛谷 P4122 [USACO17DEC] Blocked Billboard B
- 考点:二维坐标离散化 / 矩形面积。
- 思路:横纵坐标分别离散化,在小网格上标记广告牌与遮挡区域。每个有效格子累加
,不能按格子个数当作面积;本题也可以直接求矩形交集。
3. 第三阶梯:覆盖顺序与间隙保留
- 洛谷 P3740 [HAOI2014] 贴海报
- 考点:整数闭区间覆盖、后写覆盖前写、间隙状态保留。
- 思路:端点间插入代表点后维护最后覆盖标记;也可以把整数闭区间
转为 ,收集边界后按元区间维护。最后统计不同可见海报编号,而不是覆盖长度。