前面几种结构,是通过少做重复查询来提速。这一讲换个思路:如果一个状态只有“能”与“不能”,能不能一次处理一大排状态?
bitset 就是 C++ 里专门处理二进制位集合的利器。把一个布尔状态装进一位,再用按位运算批量处理。背包可达性、图上可达性,都很适合试一试。
一、原理与优势
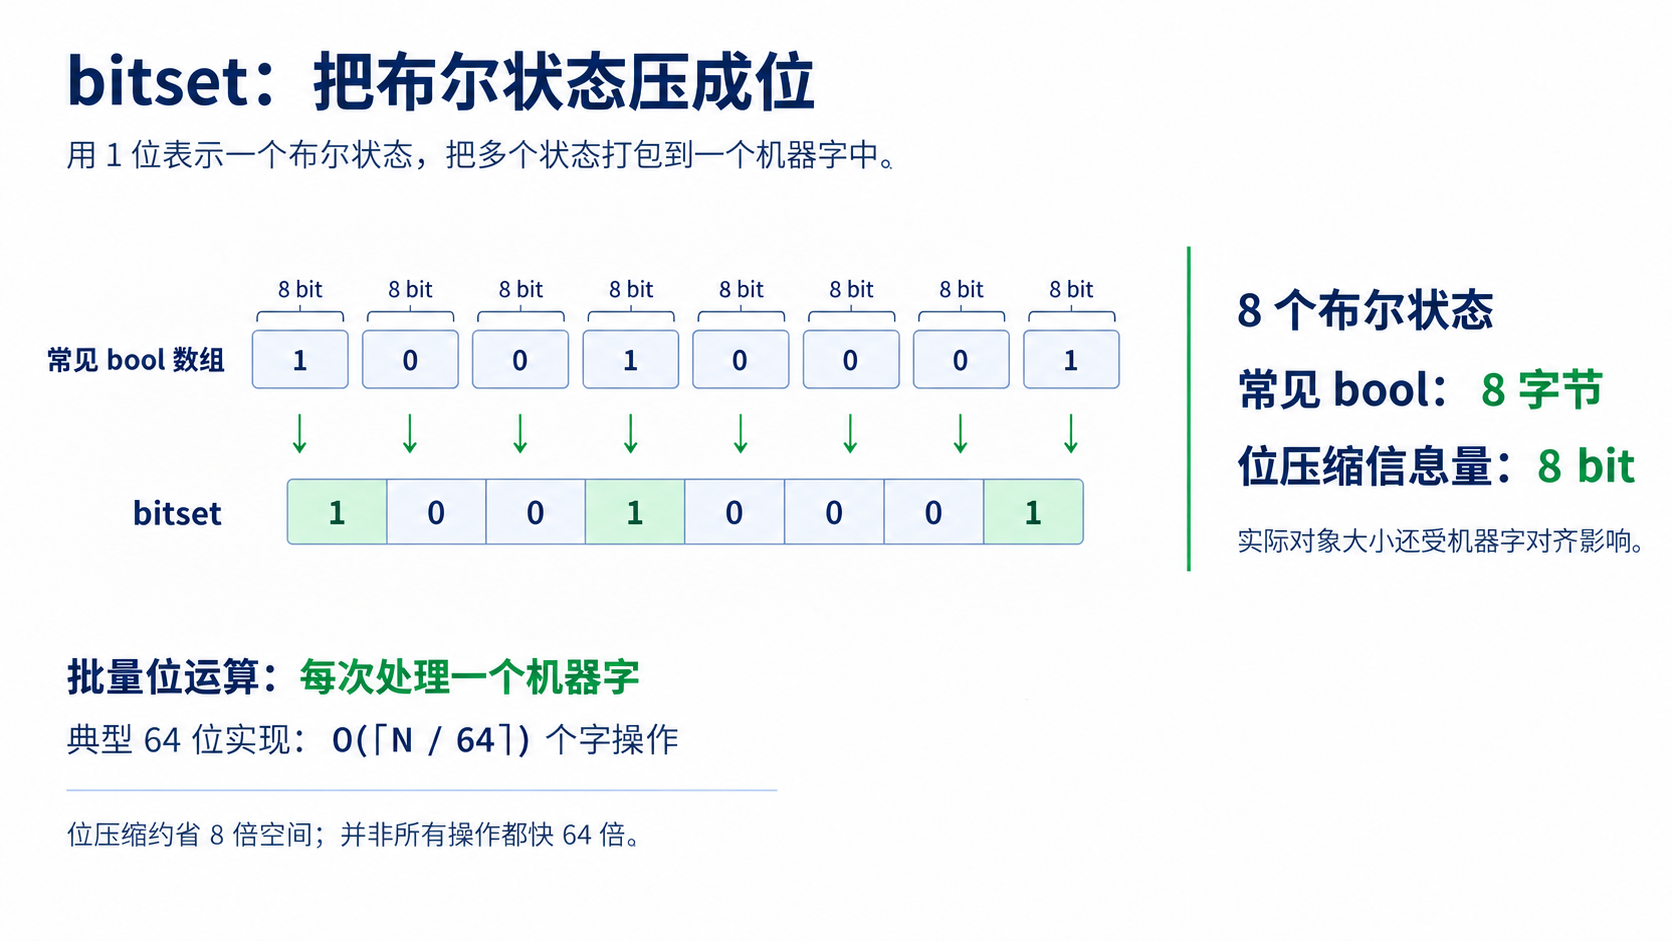
普通的 bool 数组每个元素占用 1 个字节(8 bits),而 bitset 完美利用了底层的每一个 bit。
- 极度省空间:相比于
bool数组,内存缩小到原来的 1/8。 - 极度提速:支持直接进行位运算(
&, |, ^, <<, >>),可以把它理解为一次处理一整组位,常见竞赛环境按 64 位一组估算。原来逐个处理的布尔状态,常能把这一部分运算压到约原来的 1/64。
二、定义与核心 API
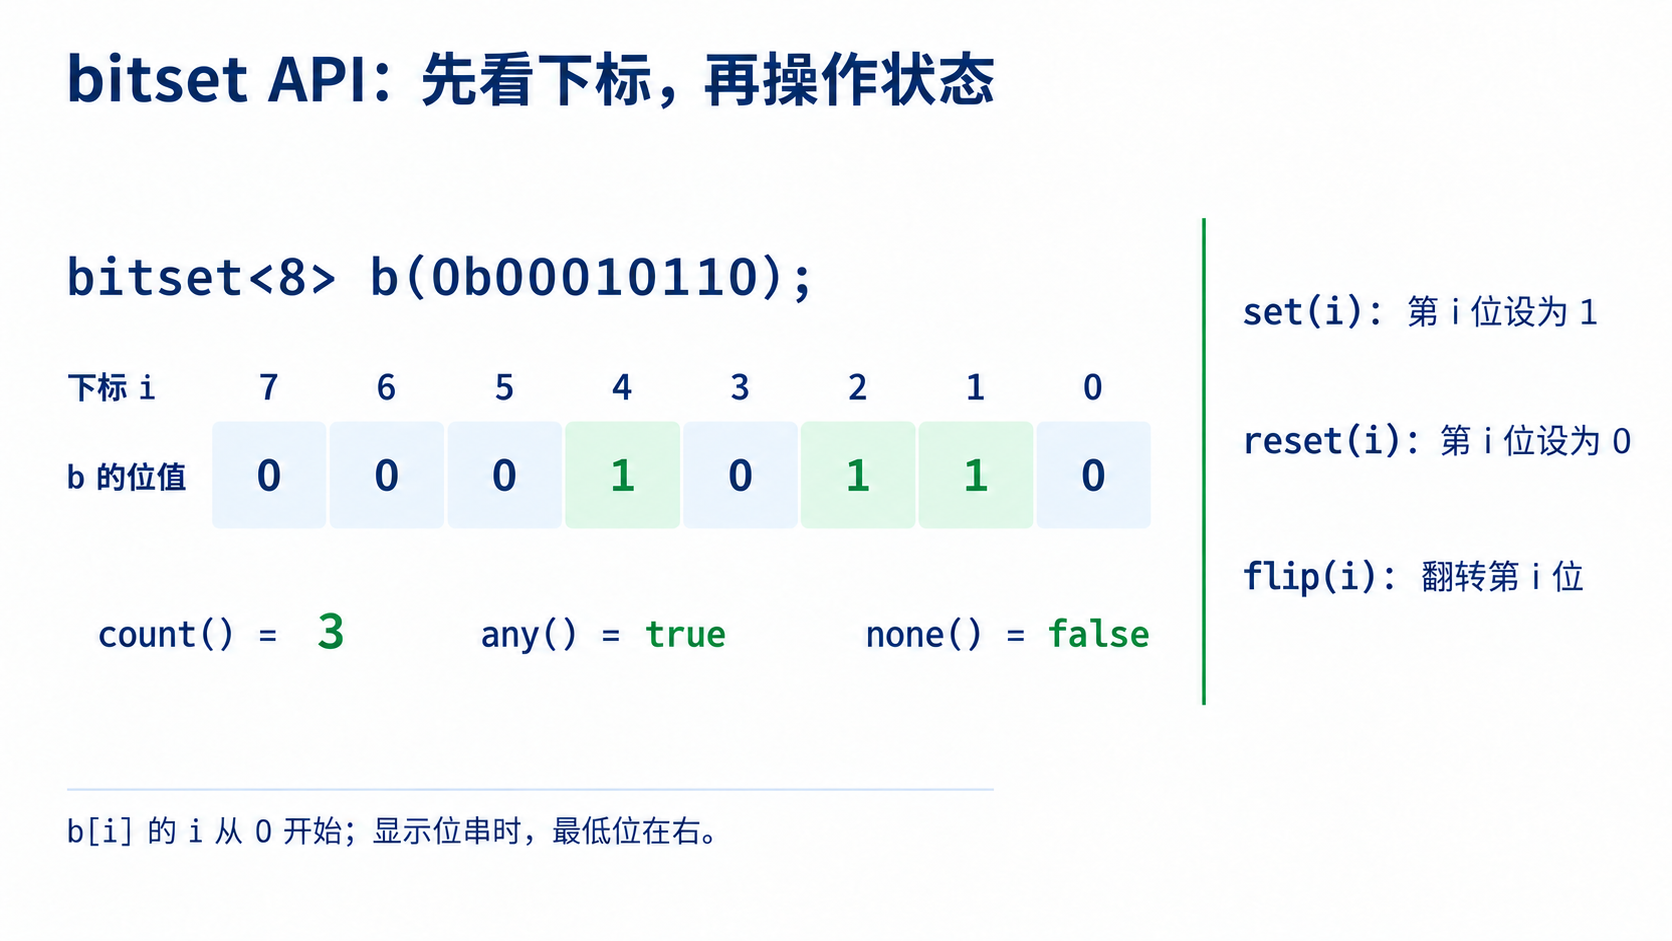
bitset 的大小必须是在编译期就确定的常量。可以通过 b[i] 直接访问和修改特定位(下标从 0 开始,打印成位串时第 0 位在最右边)。
const int N = 100005;
bitset<N> b; // 定义一个大小为 N 的 bitset,默认全 0
状态查询:
b.count():返回里面有几个 1,适合统计当前可达状态数。b.any():只要有 1 个以上的 1,返回 true。b.none():如果没有 1,返回 true。
状态修改:
b.set():所有位变成 1。b.set(i):第i位变成 1。b.reset():所有位变成 0。b.flip():所有位按位取反。
极致运算:
可以直接操作整个集合进行位运算。
b1 = b2 & b3;  // 交集:都为 1 才是 1
b1 = b2 | b3;  // 并集:有一个为 1 就是 1
b1 = b2 ^ b3;  // 异或:不同为 1,相同为 0
b1 <<= 2;      // 整体向左平移 2 位(相当于在网格上向右移动 2 格)
记住:批量操作虽快,也要扫描一组组的位,不是无论多长都只做一次操作。设共有 B 位,常按
估算一次整串运算。移出去的位会被丢掉, bitset<N>不会自动扩容。
三、实战模型一:01 背包的可达性优化
场景:给定
普通 DP 求可达性复杂度为 bitset 正好能把这一排转移合起来做。
核心思维:
当前能拼出的体积集合为 f,加入一个体积为
操作就是:将集合 f 整体左移 f 取并集。
比如原来能拼出 {0,2,3},新物品体积是 3。选它,就能得到 {3,5,6};不选它,保留 {0,2,3}。两部分合起来是 {0,2,3,5,6}。
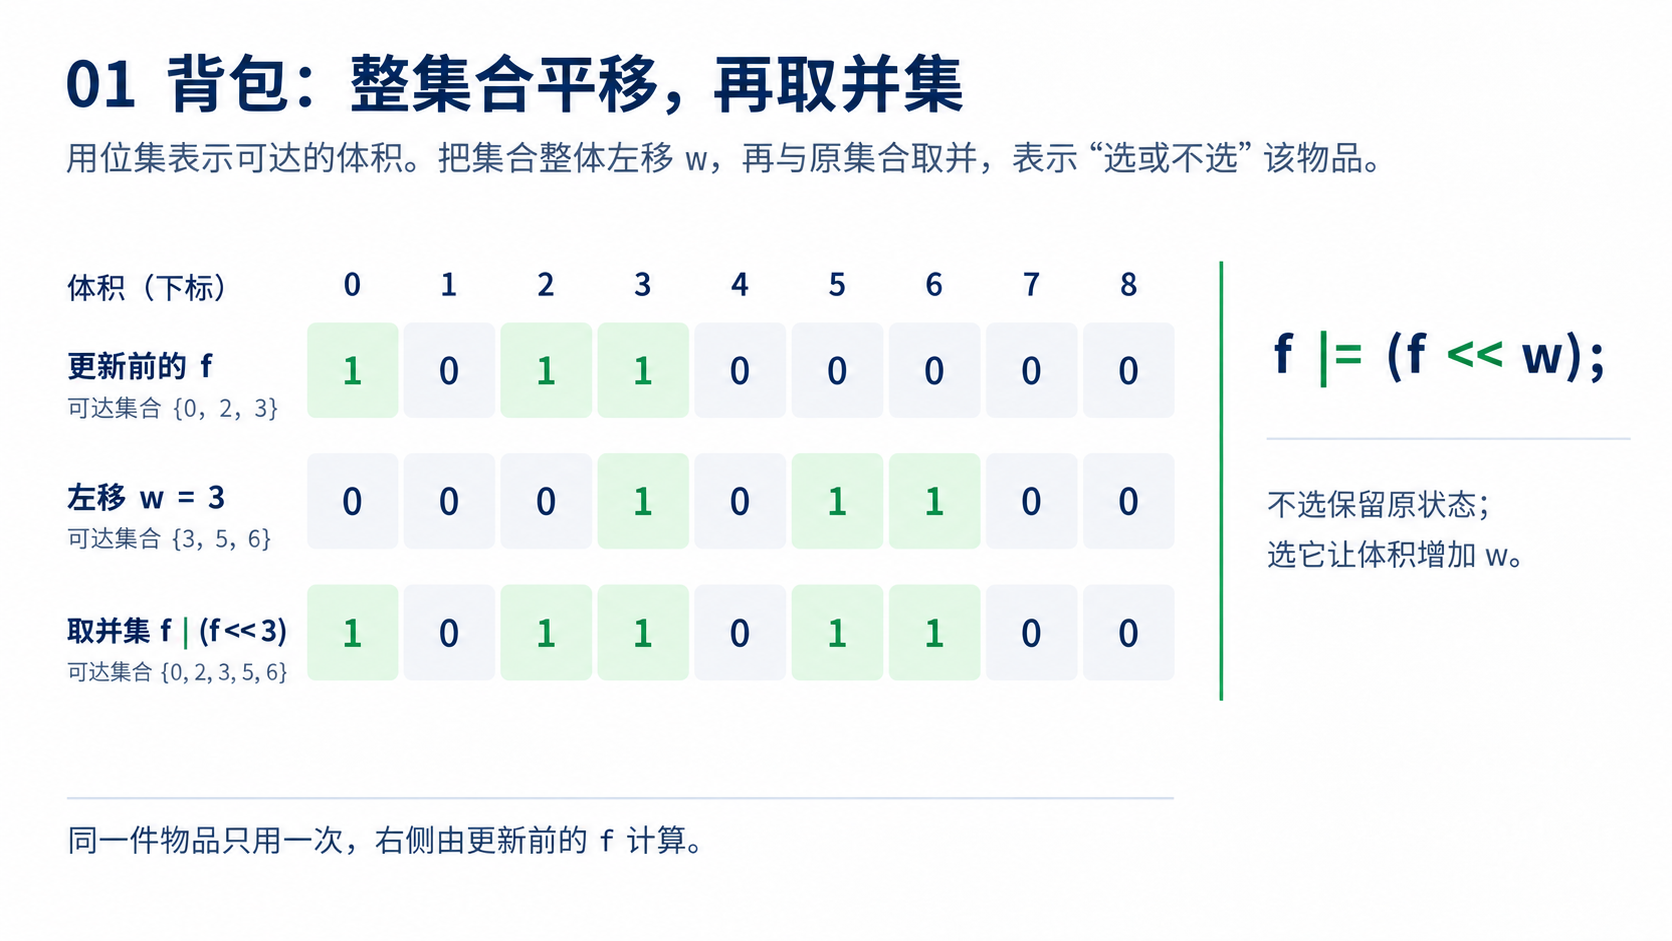
f |= f<<w[i] 右边移的是更新前的状态,所以这个物品只用了一次。这里的 1 只表示“能拼出来”,不是方案数,也不是最大价值。
下面的小程序输入 n 和 n 个正整数体积,输出能拼出的不同正体积数量。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;
int w[N];
bitset<N>f;

void solve(){
	int n;
	cin>>n;
	for(int i=1;i<=n;i++) cin>>w[i];
	f.reset();
	f.set(0);
	for(int i=1;i<=n;i++){
		// 状态转移:当前状态 = 之前状态 | 之前状态整体平移 w[i]
		f|=(f<<w[i]);
	}
	cout<<f.count()-1<<'\n'; // 减去体积为 0 的情况
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
四、实战模型二:有向图的传递闭包(Floyd 常数优化)
场景:给定一张
普通 Floyd 算法是 bitset 可以把最内层对所有 j 的处理,合成一次按位或。
核心思维:
开一个数组 bitset<N> d[N],d[i] 存储节点
如果在 Floyd 的外层循环中,发现 d[i][k] == 1),那么 d[i] |= d[k]。
比如 1 能到 2,而 2 能到 {2,3,4},那这三个点也都能记到 1 的可达集合里。仍然是 k 在最外层,i 在内层,别随意交换。
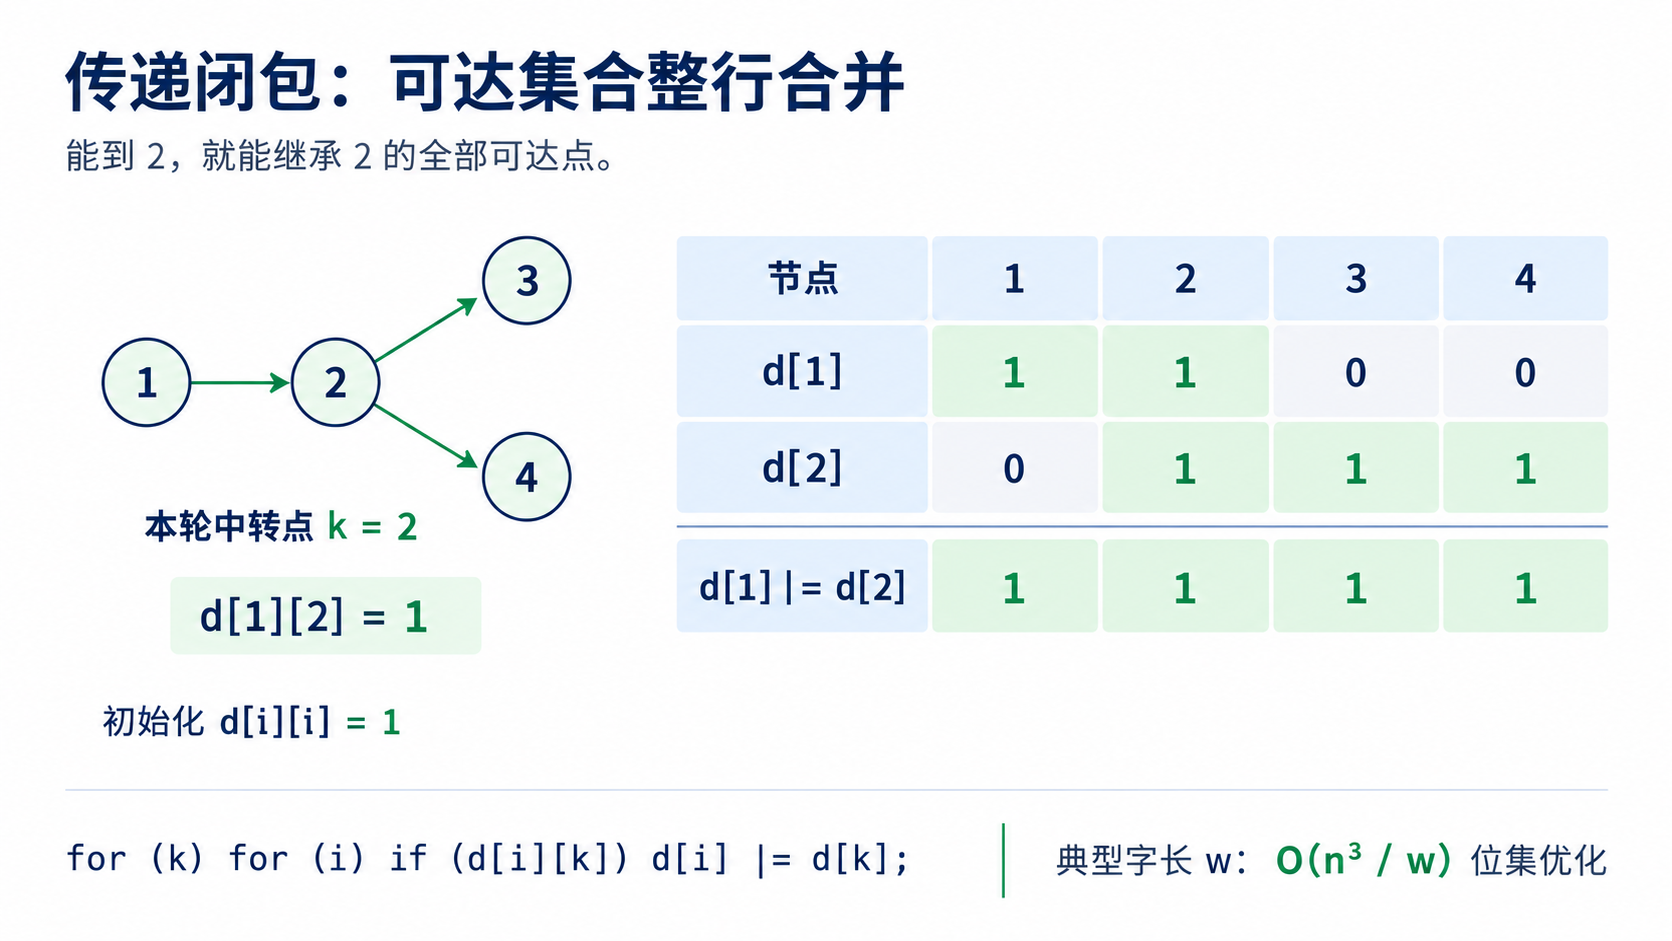
下面程序读入 n、m 和 m 条有向边,算出所有点的可达集合,再示范查询 1 能否到 n。d[i][i]=1 表示不走边也能到自己。这里只问能不能到,不算最短路长度。
这一部分常写成约
如果图保证是 DAG,还能按拓扑序合并可达集合,见《拓扑排序与 DAG 动态规划》第九节。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=2005;
bitset<N>d[N];

void solve(){
	int n,m;
	cin>>n>>m;
	for(int i=1;i<=n;i++) d[i].set(i);
	for(int i=1;i<=m;i++){
		int u,v;
		cin>>u>>v;
		d[u].set(v);
	}
	for(int k=1;k<=n;k++){
		for(int i=1;i<=n;i++){
			// 若 i 可达 k,则将 k 的可达集合并入 i 的集合
			if(d[i][k]) d[i]|=d[k];
		}
	}
	if(d[1][n]) cout<<"YES\n";
	else cout<<"NO\n";
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
五、实战模型三:线性 DP 批量状态转移(步长跳跃可达性)
场景:有一个长度为
核心思维:
不再用 for 循环去挨个推算 dp[i]。
假设当前第 f,那么走第
-
向右走 2 格的集合是
f << 2。 -
向右走 3 格的集合是
f << 3。 -
把这两种可能取并集,再用按位与
&剔除掉网格上的陷阱即可!每一步不用再挨个枚举位置,而是用两次移位、一次合并,最后筛掉不安全的位置。
这里问的是恰好 k 步,所以新状态要覆盖旧状态,不能写 f |= ...,否则会把少走几步的位置混进来。比如无障碍时,1 步能到 {2,3},2 步能到 {4,5,6},不应该还留着 2 和 3。
下图单独给定状态集合 {0,2},只演示一轮移位与筛选,不是从起点 0 出发的某一轮记录。图中 ~trap 用来排除陷阱;代码的 safe 还会一并排除网格范围外的位置。
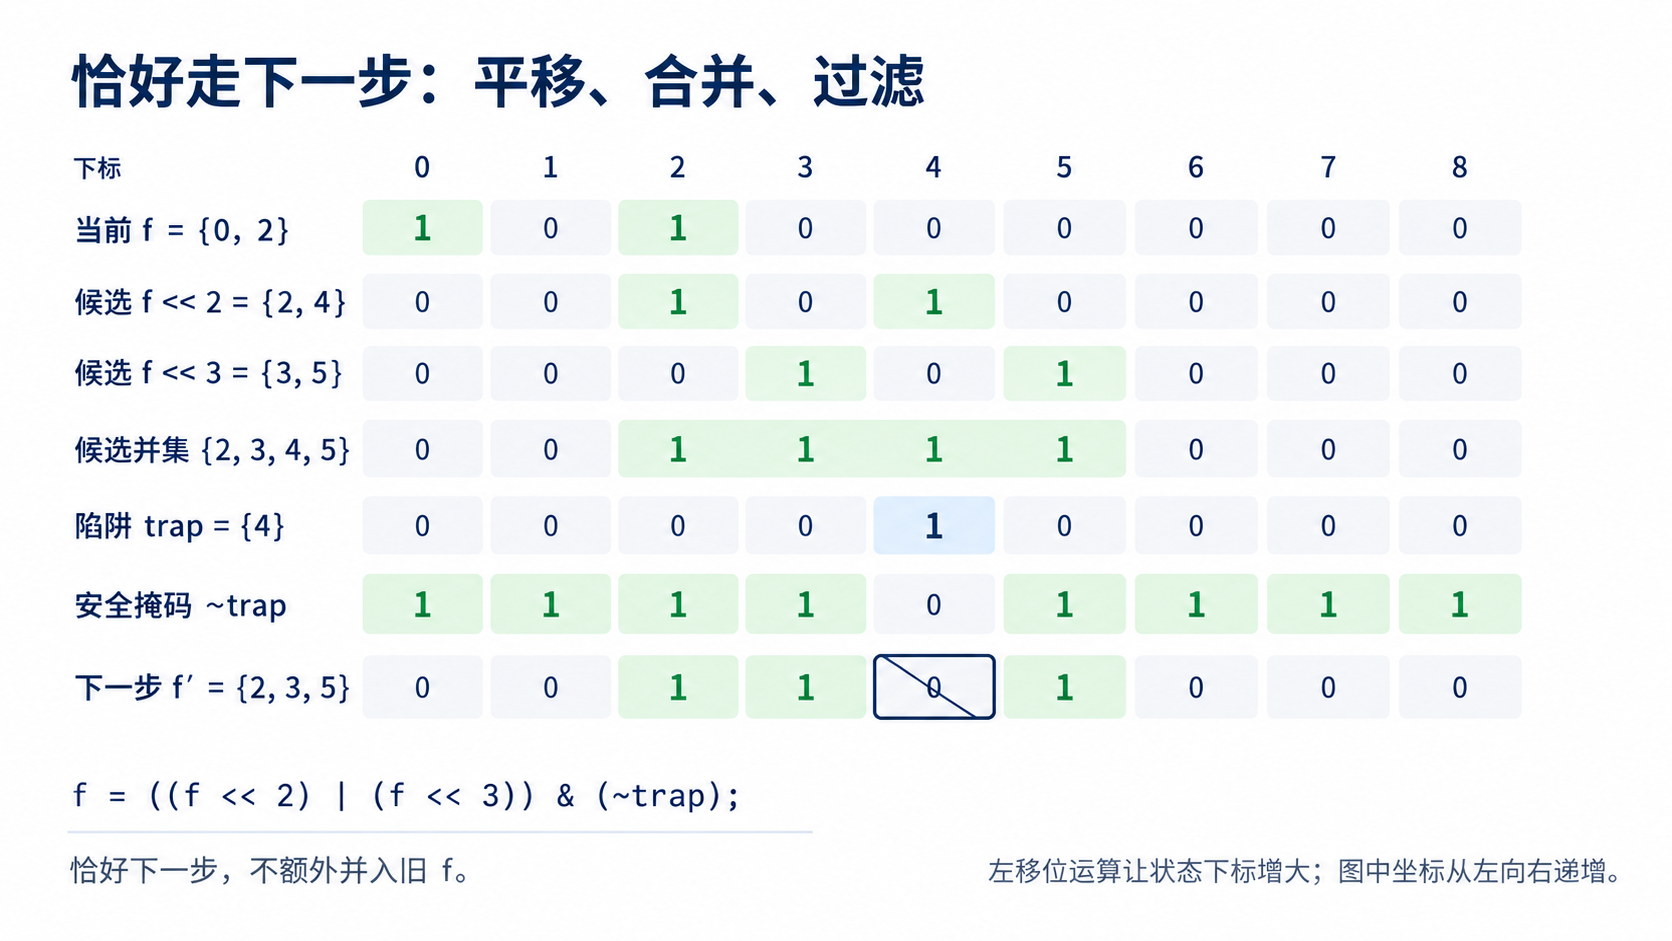
下面约定格子编号是 [0,n]。输入 n、k、m 和 m 个陷阱位置,输出恰好 k 步能否到 n。安全掩码只标记这段范围;如果起点就是陷阱,一开始就没有可达状态。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;
bitset<N>f;
bitset<N>trap; // 记录陷阱位置,trap[i]=1 表示有陷阱
bitset<N>safe;

void solve(){
	int n,k,m;
	cin>>n>>k>>m; // n为网格长度,k为跳跃次数,m为陷阱数量
	for(int i=1;i<=m;i++){
		int x;
		cin>>x;
		trap.set(x);
	}

	f.reset();
	for(int i=0;i<=n;i++) if(!trap[i]) safe.set(i);
	if(safe[0]) f.set(0); // 起点安全才可以出发

	// 模拟 k 次跳跃
	for(int i=1;i<=k;i++){
		// 全局状态同时向右平移 2 格和 3 格,并取并集
		f=(f<<2)|(f<<3);

		// 只保留网格范围内的安全位置
		f&=safe;
	}

	if(f[n]) cout<<"YES\n";
	else cout<<"NO\n";
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
六、进阶 API:集合差集与越界截断机制
前面介绍了交并补,如果我们要从状态集合 A 中去掉属于集合 B 的状态,该怎么写?
可以直接组合使用按位与和按位取反:A &= ~B。这在物理意义上等价于求集合的差集
边界与截断:
bitset<N> 是严格定长的。就像一个长度固定为
- 当执行
b << k时,下标上的状态移到 ;新下标达到 或更大,就会直接丢弃,不会报错,也不会自动扩容。 - 空出来的低下标位置会自动补
0。 - 注意陷阱:状态编号增加 3 用
b << 3,减少 3 用b >> 3,不能用负数表示反方向。bitset会把-3转成一个很大的无符号位移量,结果反而把状态全部移没了。
七、实战模型四:图论中的共同邻居计数
场景:给一张
普通做法是遍历
核心思维:
我们给每个节点建一个 bitset<N> adj[N]。如果 adj[u] 的第 (adj[u] & adj[v]).count()。
每次询问的计算量从顺次比对
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=2005;

bitset<N> adj[N];

void solve(){
	int n,m,q;
	cin>>n>>m>>q;

	for(int i=1;i<=m;i++){
		int u,v;
		cin>>u>>v;
		adj[u].set(v);
		adj[v].set(u);
	}

	while(q--){
		int u,v;
		cin>>u>>v;
		// 直接计算两个集合的交集,并求 1 的个数
		cout<<(adj[u] & adj[v]).count()<<'\n';
	}
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
(样例测试:输入
5 5 1表示 5点5边1查询,接着输入边1 2、1 3、2 4、3 4、4 5,查询输入2 3。2和3的共同邻居是1和4,程序瞬间输出2。)
八、选学:多重背包的二进制拆分与 bitset 结合
先修知识:《动态规划基础》第五节的多重背包二进制拆分。
在前面的模型一中,我们用 f |= f<<w[i] 优化了 01 背包的可达性。如果遇到多重背包(第
可以,但前提条件极为严苛:必须且只能是求解“能否达到某种体积”或“能达到多少种不同体积”(即可达性问题)。如果题目问的是“达到体积
组合降维:
当明确是求可达性时,我们可以先用二进制拆分,把 f |= (f << 新体积) 即可。
在处理大规模背包的存在性拷问时,这两个优化经常一起出现:二进制拆分把每种物品的
九、几种写法,一眼分清
- 01 背包:选或不选,所以
f |= f<<w,保留旧状态。 - 传递闭包:能到 k,就把 k 能到的那一整排并过来。
- 恰好 k 次跳跃:只保留下一步的位置,所以
f = ((f<<2)|(f<<3)) & safe。 - 共同邻居:取两个邻居集合的交集,再数 1,即
(adj[u]&adj[v]).count()。
看到大段布尔 DP,先问问自己:这一整排转移,能不能改写成位集合的移位、交集或并集?能改写,才是 bitset 发力的地方。