上一讲我们一直在问局部问题:某个点的子树在哪里,两点的路径在哪儿拐弯。现在把视线拉远一点:这棵树最长能走多远?删掉哪个点,剩下的几块最均匀?
这两个问题分别引出直径和重心。一个关心路径长度,一个关心连通块大小。名字听起来都像在找树的“中间”,但千万别在做题时把它们混在一起。
(先修要求:无向树存储、树的遍历、父亲与子树大小。本篇继续用显式栈或队列,长链也不用担心深层递归爆栈。)
一、直径:不是从根出发的最长路
树上任意两点之间只有一条简单路径。把所有这样的路径放在一起,长度最大的那条就是树的一条直径,它的长度叫直径长度。
物理意义防坑:无权树把每条边看成长度
;带权树把路径上的边权相加。经过 个点的无权路径只有 条边,别把点数当成长度。直径可能不唯一,但所有直径的长度肯定相同。
直观例子:一棵七点树,边是 1-2、1-3、2-4、2-5、3-6、5-7。(所有边权均为
如果从根节点
所以“树的高度”和“树的直径”完全不是一回事。高度需要先选根,换根以后高度可能会变;直径只看树本身的客观结构,画图时你把哪个点拎在最上面,并不会改变答案。
如果最直接地暴力做,我们可以把每个点都当一次起点,遍历整棵树取最大值,时间复杂度
二、物理推导:两遍遍历的神奇魔法
对于无权树或边权非负的树,找直径的过程极其简单,只有两步:
- 第一遍:任取一个点
,找到距离它最远的点 。 - 第二遍:再从
出发,找到距离它最远的点 。那么 到 就是一条直径。
第一遍不是直接求答案,而是在找一个合适的出发位置。随便从树的内部开走,可能往哪边都差一点;先走到一个最远端,再横穿整棵树,就能把长度充分展开。
注意:这里“最远”比较的是累计距离,不是最后出栈的节点,也不是编号最大的节点。如果有多个点并列最远,任选一个即可,不需要特意把所有候选留下再搜一遍。
1. 把七点树走两遍
| 节点 | 从 1 出发的距离 | 从 7 出发的距离 |
|---|---|---|
| 1 | 0 | 3 |
| 2 | 1 | 2 |
| 3 | 1 | 4 |
| 4 | 2 | 3 |
| 5 | 2 | 1 |
| 6 | 2 | 5 |
| 7 | 3 | 0 |
第一遍从 dis 数组上继续累加。
2. 为什么这不是碰巧?
可以把一条直径画成主干,其余节点挂在主干的某些位置上。任意起点要么位于主干上,要么通过一条支路接到主干。因为树没有环,这些路径怎样相交、怎样分叉,是被结构死死固定住的。
把“起点到最远点”的路径与这条主干比较,在它们相接的位置拆开。如果这个最远点不能作为任何一条直径的端点,那么把它的分支换成主干中更长的那一端,要么得到离起点更远的点,要么拼出比原直径更长的路径。前者违背“最远”,后者违背“直径”。
这个比较用到了边权非负的前提:多保留一段路径,不会反而把长度变小。于是第一遍找到的点必然可以作为某条直径的端点;既然已经站在了端点上,第二遍再找最远点,自然就把整条直径找全了。学习时先会手推这条逻辑,再去记代码,而不是只死记“跑两遍就行”。
三、完整程序一:非负权树的直径
输入协议:第一行 u v w,表示无向边。范围为
下面使用迭代的 DFS(显式栈)来防爆栈。树上从起点到每个点只有一条路径,走到孩子时直接累加边权就够了,不存在像最短路那样“有另一条路线回来把距离改小”的问题。遍历时间是纯线性的
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=500005;

struct Edge { int v, w; };
vector<Edge> node[N];
int dis[N], par[N];
int n;

// 核心模块:从起点 s 找最远点,返回 {最远点编号, 最大距离}
pair<int, int> farthest(int s) {
	// 每次遍历前必须清空状态
	for(int i=1; i<=n; i++) {
		dis[i] = 0;
		par[i] = 0;
	}

	stack<int> st;
	st.push(s);
	int best = s;

	while(!st.empty()){
		int u = st.top();
		st.pop();

		// 动态打擂台更新最远点
		if(dis[u] > dis[best]) best = u;

		for(int i=0; i<node[u].size(); i++){
			int v = node[u][i].v;
			int w = node[u][i].w;
			if(v == par[u]) continue; // 不走回头路

			par[v] = u;
			dis[v] = dis[u] + w;
			st.push(v);
		}
	}
	return {best, dis[best]};
}

void solve() {
	cin >> n;
	for(int i=1; i<n; i++){
		int u, v, w;
		cin >> u >> v >> w;
		node[u].push_back({v, w});
		node[v].push_back({u, w});
	}
	// 第一遍:任选节点 1 作为起点,找到端点 a
	int a = farthest(1).first;
	// 第二遍:从 a 出发找最远点,其距离即为直径长度
	int ans = farthest(a).second;

	cout << ans << '\n';
}

signed main() {
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
两次遍历,每次访问全部节点和边,总时间和空间都是
💡 进阶提示:如果题目还要输出直径经过的具体节点,就保留第二遍的父亲数组,从终点
顺着 par走回,把路径存下来再反转即可。千万别沿第一遍的父亲回溯,那份父亲关系服务的是错误的起点。
四、危险边界:当树里藏着负权边
如果树里有负权边,千万别把两遍遍历硬套上去!
看一条链,依次是 1—2—3—4,边权为 -100、10、10。
从 farthest 把起点也作为候选,最远的反而就是
此时必须换成树形 DP:定义 down[u] 表示从 u 往子树内延伸,能拿到的最大贡献。在遍历孩子
这段只说明方法的分界,看到“树”并不意味着所有树题都能两遍遍历;真正决定能不能用的是边权条件。
五、重心:把最大的一块压到最小
换个问题:删掉节点
关键词是“先取最大,再让它最小”。不是让最小块最大,不是找度数最大的点,也不是看画出来的位置最居中。删掉一棵星形树的叶子,会留下几乎整棵树;但如果删掉中心点,剩下的每一块却都只有一个点,显然重心更为均匀。
为什么求重心也要先任选一个根?不是因为重心依赖根,而是我们想借“子树大小”把这些连通块的规模快速算出来。根只是脚手架,最后删点形成的那些客观连通块不会因为换根而改变。
假设已经知道了子树大小
- 孩子方向:每个孩子的整棵子树,大小就是
。 - 父亲方向:整棵树减掉
的子树剩下的所有部分,大小为 。
因此,节点
根的父亲方向大小是
1. 七点树里的重心是谁?
| 删除的点 | 剩余连通块大小 | 最大块 |
|---|---|---|
| 1 | 4、2 | 4 |
| 2 | 1、2、3 | 3 |
| 3 | 1、5 | 5 |
| 4 | 6 | 6 |
| 5 | 1、5 | 5 |
| 6 | 6 | 6 |
| 7 | 6 | 6 |
删除
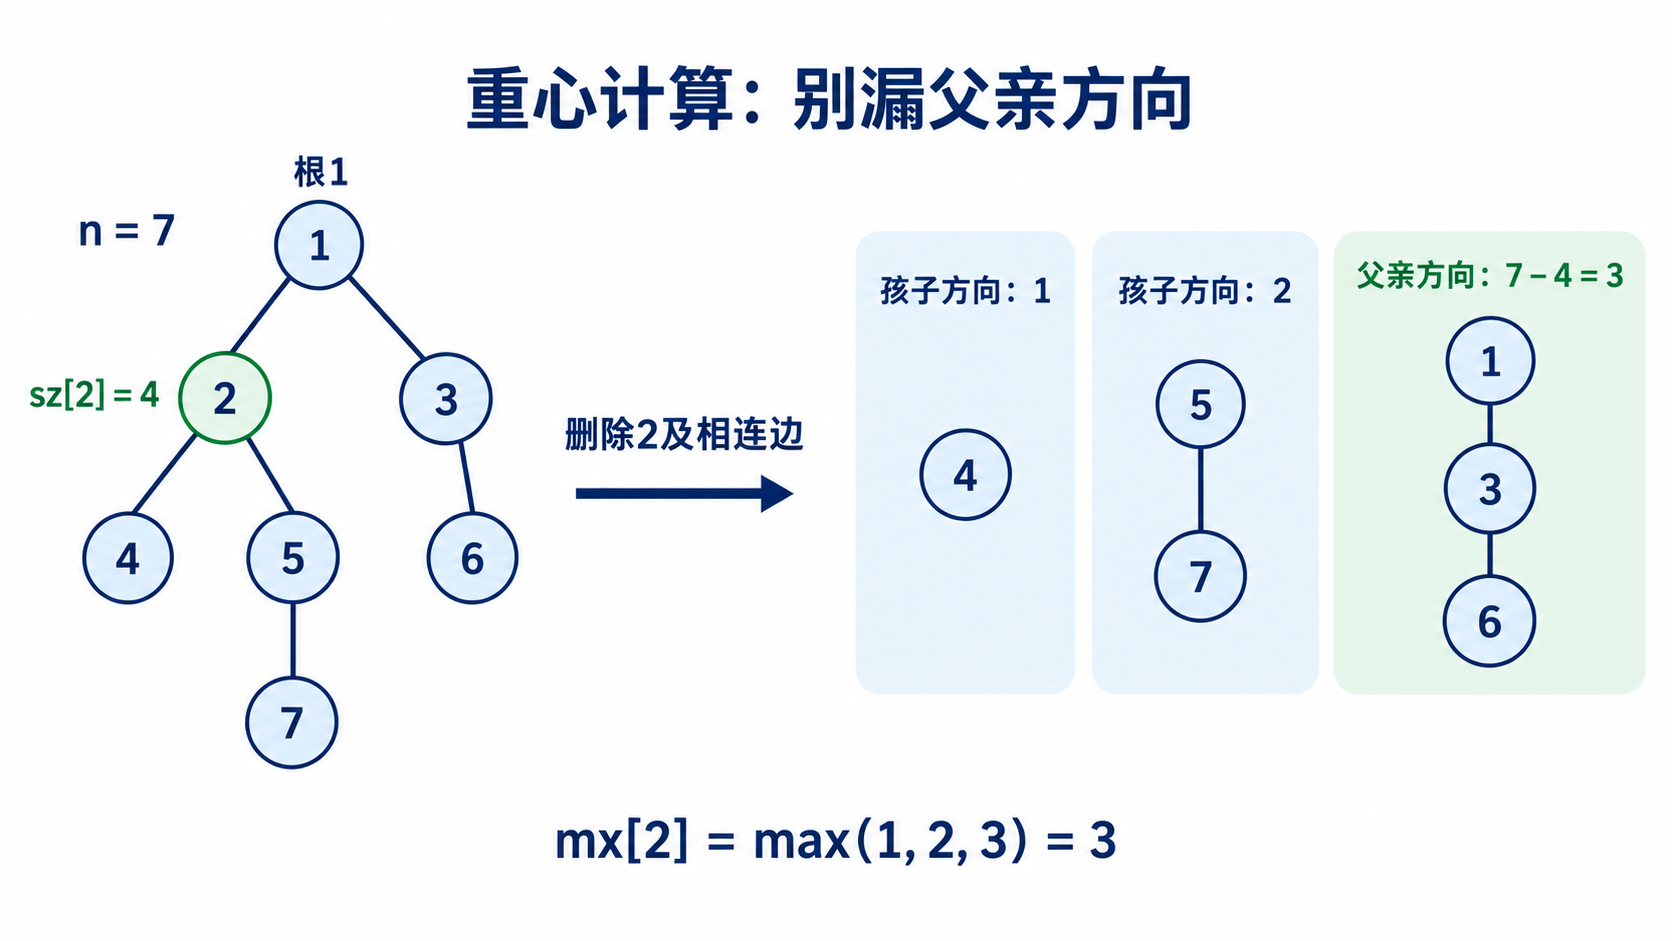
💡 易错警告:最常见的漏项就在父亲方向。如果只看孩子子树,会把叶子的最大块误算成
,仿佛每个叶子都特别均匀。其实它身后还有 个点,这必须作为一个整体块一起算进去!
六、完整程序二:求出全部重心
输入协议:第一行 u v(无权),
这里我们利用一个“灵魂数组” ord:先用类似 BFS 的队列方式建立父亲关系,这顺便留下了一个父亲永远在孩子前面的拓扑访问顺序;接着只要倒着扫 ord 数组,就能保证在处理父亲时,孩子的
#include<bits/stdc++.h>
using namespace std;
const int N=500005;

vector<int> node[N];
int par[N], sz[N], mx[N], ord[N];
int n;

void solve(){
	cin >> n;
	for(int i=1; i<n; i++){
		int u, v;
		cin >> u >> v;
		node[u].push_back(v);
		node[v].push_back(u);
	}

	// 1. 用类似 BFS 的方式获取遍历序列 ord,建立严格的父子关系
	int head = 1, tail = 0;
	ord[++tail] = 1;
	while(head <= tail){
		int u = ord[head++];
		for(int i=0; i<node[u].size(); i++){
			int v = node[u][i];
			if(v == par[u]) continue;
			par[v] = u;
			ord[++tail] = v;
		}
	}

	// 2. 倒序遍历 ord 数组:相当于剥洋葱式地从叶子向上推导
	for(int i=n; i>=1; i--){
		int u = ord[i];
		sz[u] = 1; // 自己算 1 个点
		mx[u] = 0;
		for(int j=0; j<node[u].size(); j++){
			int v = node[u][j];
			if(v == par[u]) continue; // 只看孩子
			sz[u] += sz[v];
			mx[u] = max(mx[u], sz[v]); // 收集孩子方向的最大块
		}
		// 灵魂补刀:千万别忘了父亲方向剩下的那一块!
		mx[u] = max(mx[u], n - sz[u]);
	}

	// 3. 找出所有重心
	int best = 1e9;
	for(int i=1; i<=n; i++) best = min(best, mx[i]);

	cout << best << '\n';

	bool first = true;
	for(int i=1; i<=n; i++){
		if(mx[i] == best){ // 树可能有两个重心,都要输出
			if(!first) cout << " ";
			cout << i;
			first = false;
		}
	}
	cout << '\n';
}

int main(){
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
性质推论:重心有一个很实用的判断——删掉它后,每一块大小都不会超过总点数的一半。如果某一块超过了一半,你只要向那一块走一步,最大块还能继续缩小,所以当前点不可能已经是最优的。另外,一棵树最多只有两个重心(如果有两个,必然相邻)。
七、灵魂拷问:重心和中心到底差在哪儿?
- 树的中心关心的是距离:选一个位置,让它到最远节点的距离尽量小。无权树在直径中间找中心点。
- 树的重心关心的是连通块大小:选一个位置,让删掉它后最大的碎块尽量小。
想象节点 1—6—7—8。这棵树有
可是这棵树的直径是 2—1—6—7—8,正中间的节点是
人多的一侧会影响重心,路长的一侧会影响中心,两种截然不同的物理目标自然可能选出不同的位置。不要一遇到“想在树上找个中间点”就乱套模板。
八、选学一:利用直径端点求每个点的最远距离
(先修要求:掌握树的直径两遍遍历求法。)
问题模型:如果我们要在这棵树上建一个消防站,我们需要评估每个候选位置的“最坏响应距离”。也就是给定一棵无向正权树,求出对于每个节点
如果对每个点都当一次起点去跑遍历,时间复杂度会达到
关键推导:
不管你站在树上的哪个节点
为什么?假设存在一条全树直径,两端点为
实现要点:
我们只需要在原来的基础上多跑一遍遍历,总共跑三遍,即可在
- 第一遍:从随便一个点出发,找到距离最远的点
。这必定是直径的一个端点。 - 第二遍:从
出发找最远点,得到另一个端点 。在此过程中,顺便记录下所有节点到 的距离,存进 disA数组。 - 第三遍:从
出发跑一遍遍历。这遍不需要再找最远点了,只需要记录下所有节点到 的距离,存进 disB数组。
最终,任意节点 max(disA[u], disB[u])。
同一个问题也可以用换根 DP 解决,见《树形 DP》第六节;这里借直径端点,把状态压缩成了两份距离。
// 独立验证:求树上每个点到其余节点的最远距离
// 输入:第一行 n,随后 n-1 行 u v w (无向正权边),1 <= n <= 100000
// 输出:n 行,第 i 行表示节点 i 到全树的最远距离
/*
样例输入:
4
1 2 5
2 3 2
2 4 3
样例输出:
8
5
7
8
*/
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;

struct Edge { int v, w; };
vector<Edge> node[N];
int disA[N], disB[N];
int n;

// 返回 {最远点编号, 距离},并将遍历距离存入传入的 dis 数组
pair<int, int> farthest(int s, int dis[]) {
	for(int i=1; i<=n; i++) dis[i] = -1;

	queue<int> q;
	q.push(s);
	dis[s] = 0;
	int best = s;

	while(!q.empty()){
		int u = q.front();
		q.pop();

		if(dis[u] > dis[best]) best = u;

		for(int i=0; i<node[u].size(); i++){
			int v = node[u][i].v;
			int w = node[u][i].w;
			if(dis[v] != -1) continue; // 已访问过

			dis[v] = dis[u] + w;
			q.push(v);
		}
	}
	return {best, dis[best]};
}

void solve() {
	cin >> n;
	for(int i=1; i<n; i++){
		int u, v, w;
		cin >> u >> v >> w;
		node[u].push_back({v, w});
		node[v].push_back({u, w});
	}

	// 借用 disA 作为第一遍寻找端点 A 的临时数组
	int a = farthest(1, disA).first;
	// 第二遍:从 A 找最远点 B,并永久留下所有点到 A 的距离 disA
	int b = farthest(a, disA).first;
	// 第三遍:从 B 出发跑距离,留下 disB
	farthest(b, disB);

	for(int i=1; i<=n; i++){
		cout << max(disA[i], disB[i]) << '\n';
	}
}

signed main() {
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
九、选学二:两棵树连桥后的新直径生成
(先修要求:掌握选学一的最远距离模型。)
问题模型:有两棵互相独立的树,内部直径分别是
关键推导: 新树的最长路径只有三种可能的生存空间:
- 路径完全没有经过新桥,老老实实待在第一棵树内部,长度必定被
限制。 - 路径完全待在第二棵树内部,长度被
限制。 - 路径跨越了新桥。这条跨界路径要想最长,必定是在第一棵树里从最远的地方走到
,过桥,再在第二棵树里一直走到最远的地方。
此时,第一棵树里走到
跨桥的最大路径长度直接就是三段拼图:
所以,连边后不需要重新跑遍历,新树的直径直接在三者中取最大值即可:
手算小例子:
假设两棵树都只有一个节点(自己到自己的最远距离是
十、选学三:重心的距离汇聚与带权中位点
(先修要求:掌握树的重心定义与
问题模型:如果要把树上所有人都聚集到一个节点开会,选哪个点能让大家“走过的总距离之和”最小?
关键推导:
在无权点模型下(把每个节点看作
想象一开始聚会点选在节点
这一侧子树里的所有人(数量为 ),距离聚会点都近了 。 - 树上剩下的所有人(数量为
),距离聚会点都远了 。
所以,总距离的变化量是:
回想重心的核心性质:删去重心后,任何一块连通块的大小都不会超过
带权中位点的区别:
如果这不仅是一棵树,每个节点代表的村庄人数还不一样(给节点加上了点权
此时就不再是寻找普通重心了,而是寻找带权中位点(带权重心)。
判断挪动是否划算的物理逻辑依然有效,只是比较的筹码变了:
实现要点:
求带权中位点不用重写遍历逻辑。在原来的重心模板里,把初始化 sz[u] = 1 改成 sz[u] = W[u],再把 n - sz[u] 改为 Total_W - sz[u]。此时 sz、mx 统计的是人数而非节点数,要按总人数选用类型(必要时用 long long),best 也要用足够大的初值,如 Total_W。选点取决于点权分布,而不取决于正边长的具体大小。
想把每个聚集点的总花费都算出来,可以接着看《树形 DP》第四节的 P2986:同一条“挪一步”的式子,会变成换根转移。
十一、把两种工具真正用起来
直径端点怎样帮助求每个点的最远距离,见第八节。
而重心常用于把树拆得比较均匀。后续如果递归处理删点后的各块,每块都不会超过原来的一半(保证递归深度不超过
1. 实战演练指引
课后可以按三步进行思维刻意练习:
- 先在链、星形图、七点树上手算两遍距离;
- 再逐点删除小树,手算连通块,与第二份程序打印出的数组作比较;
- 自我挑战:构造一个重心和中心不同的新例子。能自己构造反例,比只会复述定义更能说明你彻底吃透了这两个概念。
想继续做直径应用的实战,推荐看 洛谷 P1099 [NOIP2007 提高组] 树网的核。它要求在直径上选一段受长度限制的路径,使最远点到这段路径的距离最小。它不是只输出直径长度,也不是直接套重心程序,需要你先把题意和本节的模型精准对接,再做区间处理。
最后留三个极端边界自测,确保模板不翻车:
- 单点树的直径和最大块都是
。 - 全零边权树的直径长度仍是
。 - 偶数点链必定有两个重心。 只有跑过长链(检查防爆栈)和星形树(检查遍历孩子),才能放心把模板带到更复杂的赛场题目里。