一、暴力 BST 的痛点:退化成链的灾难
场景:我们已经会用 set 了,为什么还要自己写平衡树?因为有些题目不仅问“有没有这个数”,还要问“有多少个数比它小”“第 set 的迭代器一步一步往后走,走到第
物理劣势:二叉搜索树(BST)按照数值安排左右,小的往左,大的往右。如果运气好,树很均匀,每次查询都能排除一半候选人;但如果把
FHQ Treap 的降维打击:
不想让输入的顺序直接决定树的形状?Treap 的魔法是给每个新节点发一个随机优先级 pri。
在维护左右数值顺序不乱的同时,规定父亲的优先级不能大于孩子(小根堆性质)。因为优先级是随机产生的,树的结构就被彻底打散,不再因为输入值递增就必然长成链。随机优先级模型下,操作的期望时间稳定在
而今天的主角 FHQ Treap(无旋平衡树) 更加符合暴力美学:它完全不要求我们背诵复杂的“左旋”“右旋”,而是把所有的操作拆成最直接的两件事——按值把树劈成两半(Split),再把树拼回去(Merge)。
二、灵魂结构:节点里存什么?
我们要维护的是一个允许重复值出现的多重集(例如存在多个
我们需要五个核心字段:
l, r:左右孩子编号。v:数值。pri:随机优先级。- 灵魂数组
sz:以当前节点为根的子树大小。包含重复数在内,它是回答“第小”和“排名”的核心依据。
铁律:重新计算大小 (Pull) 空节点编号为
,大小为 。真实节点的大小等于左右子树大小加上自己: sz[p] = sz[l[p]] + sz[r[p]] + 1以后只要改动了节点的左右孩子,就必须重新计算大小!排名跑偏,99% 的原因都是漏写了这步。
三、第一步核心魔法:Split(把树劈开)
目标:split(p, k, a, b),把以 p 为根的树劈成两棵:a 树中的所有值 b 树中的所有值
物理推导(只需沿一条路走):
- 当前根的值
时:根和它的整个左子树显然都符合要求,全部留在 a树!难办的只有右子树(里面可能有一段也)。所以我们继续进入右子树劈开它,把分出的较小部分接回根的右边,较大部分丢给 b。 - 当前根的值
时:情况反过来。根和整个右子树都属于 b,我们继续分裂左子树。把分出的较大部分接回根的左边,较小部分成为a。
💡 直观例子与手推: 假设给
[2, 4, 4, 7]的四次插入分别安排优先级。为方便手推,我们用 4a和4b区分两个相同值。 按照优先级建树,根是4a(20)。
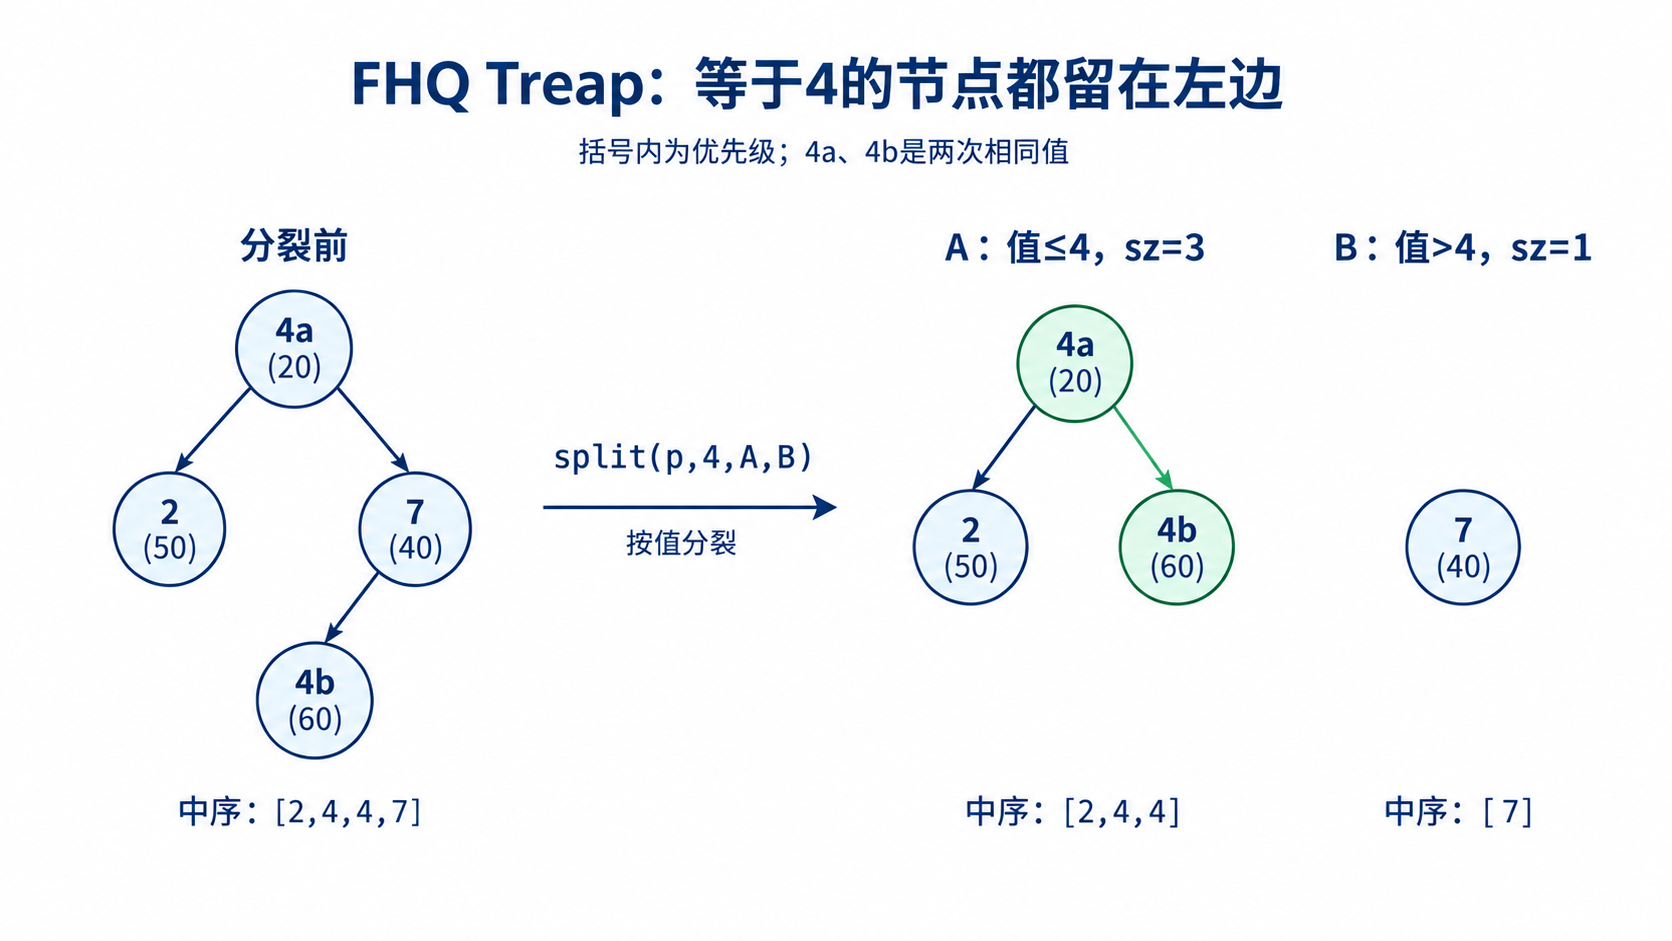
剥洋葱式拆解按
分裂: 根 4a留在左边;进入它的右子树,节点大于 ,所以要去右边;但 的左孩子 4b又不大于,应该留在左边。递归返回后, 4b接到了4a的右边,的左孩子变空。 最终左树是 [2, 4a, 4b],右树是[7]。尤其注意,等于分界值的两个都稳稳地去了左边,没有丢失。
四、第二步核心魔法:Merge(把树拼回去)
目标:merge(a, b) 把两棵树合并成一棵。
前提铁律:a 树中的所有值,必须统统 b 树中的所有值!它不是一个可以随意混合两棵树的函数,前提如果被破坏,中序顺序神仙难救。
物理推导(优先级说了算): 既然数值的左右顺序已经满足了,谁来当合并后的新根?比较两棵树根的优先级!
- 如果
pri[a] < pri[b]:a更有资格当根。它的左子树不用动,只要把a的右子树和整棵b树合并,然后挂回a的右边。 - 反之
pri[b] < pri[a]:b当根。把整棵a树和b的左子树合并后,挂回b的左边。
合并完成后,一定要 pull 重新计算新根的大小。
五、六大操作的降维拆解
有了 split 和 merge,回答这六个问题就像搭积木一样简单,这就是无旋平衡树的暴力美学!
设 A, B, C 为临时劈出来的子树。
1. 插入 x
按 x 分裂成 A(<=x) 和 B(>x),新建一个值为 x 的节点,按 A、新节点、B 的顺序依次 merge 合并起来。已有的相同值都在 A 树,新值排在后面,没有冲突。随机优先级自然会通过 merge 把它放到合适的高低位置,不需要去写任何旋转。
2. 删除一个 x
先按 x 把树劈成 A(<=x) 和 C(>x),再把 A 树按 x-1 劈成 A(<x) 和 B(=x)。
现在 B 树里装的全是等于 x 的节点。因为只要删一个,我们直接抛弃 B 的根,把它左右两棵子树 merge 起来顶替它的位置。最后把 A、新的 B 和 C 拼回去。
3. 求 x 的排名
按 x-1 分裂,左树 A 恰好是所有严格小于 x 的元素,答案显然是 sz[A] + 1。(注意:查完必须把树合并回去!不然集合少了一大半)。
4. 求第 k 小(唯一不需要劈树的操作)
这和普通 BST 一样,看当前根节点左子树大小
- 若
,去左子树找; - 若
,根自己就是答案; - 否则,目标在右侧,去右子树找第
小(别忘了减掉左树和根占据的名次)。 注:为了防止深链爆栈,我们直接用 while迭代向下走。
5. 严格前驱 (<x 的最大值)
按 x-1 分裂成 A 和 B。在 A 树里找最大的(也就是查询 A 树的第 sz[A] 小)。查完还原树。
6. 严格后继 (>x 的最小值)
按 x 分裂成 A 和 B。在 B 树里找最小的(也就是查询 B 树的第
六、核心模板代码实现 (洛谷 P3369 普通平衡树)
输入输出协议:
第一行操作数 op x,操作编号依次对应上面的六项。输出操作
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N = 100005; // 容量按累计插入次数预留,不要只按当前集合大小开

struct Node {
    int l, r, sz;
    int v;         // 值域可能较大,跟随宏定义为 long long
    uint32_t pri;  // 随机优先级
} t[N];

int rt, tot;
mt19937 rng(712367821);

// 灵魂维护:更新子树大小
inline void pull(int p) {
    t[p].sz = t[t[p].l].sz + t[t[p].r].sz + 1;
}

inline int newnode(int x) {
    int p = ++tot;
    t[p].v = x;
    t[p].sz = 1;
    t[p].pri = rng();
    return p;
}

// 核心魔法 1:分裂
void split(int p, int k, int &a, int &b) {
    if (!p) {
        a = b = 0;
        return;
    }
    if (t[p].v <= k) {
        a = p;
        split(t[p].r, k, t[p].r, b);
        pull(a); // 别忘了算!
    } else {
        b = p;
        split(t[p].l, k, a, t[p].l);
        pull(b); // 别忘了算!
    }
}

// 核心魔法 2:合并
int merge(int a, int b) {
    if (!a || !b) return a + b;
    if (t[a].pri < t[b].pri) {
        t[a].r = merge(t[a].r, b);
        pull(a);
        return a;
    }
    t[b].l = merge(a, t[b].l);
    pull(b);
    return b;
}

// 迭代求解第 k 小,防止极限情况递归爆栈
int kth(int p, int k) {
    while (p) {
        int s = t[t[p].l].sz;
        if (k <= s) {
            p = t[p].l;
        } else if (k == s + 1) {
            return t[p].v;
        } else {
            k -= (s + 1);
            p = t[p].r;
        }
    }
    return 0; // 合法的查询不会走到这里
}

void solve() {
    int q;
    cin >> q;
    while (q--) {
        int op, x, a, b, c;
        cin >> op >> x;
        if (op == 1) { // 插入 x
            split(rt, x, a, b);
            rt = merge(merge(a, newnode(x)), b);
        } else if (op == 2) { // 删除一个 x
            split(rt, x, a, c);
            split(a, x - 1, a, b);
            if (b) b = merge(t[b].l, t[b].r); // 删掉 b 的根
            rt = merge(merge(a, b), c);
        } else if (op == 3) { // 查询 x 的排名
            split(rt, x - 1, a, b);
            cout << t[a].sz + 1 << '\n';
            rt = merge(a, b); // 查完必须原样接回去!
        } else if (op == 4) { // 查询第 k 小
            cout << kth(rt, x) << '\n';
        } else if (op == 5) { // 前驱
            split(rt, x - 1, a, b);
            cout << kth(a, t[a].sz) << '\n';
            rt = merge(a, b);
        } else if (op == 6) { // 后继
            split(rt, x, a, b);
            cout << kth(b, 1) << '\n';
            rt = merge(a, b);
        }
    }
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
💡 自定义边界手推测试
把下面的数据丢进你的程序,测一测重复值边界是否正确: 输入:
12 1 4 1 2 1 4 1 7 3 4 4 3 5 4 6 4 2 4 3 5 4 2 2 9输出:
2
4
2
7
3
4
(解析:最后一次删除
时它并不存在,由于我们在代码里做好了判空,集合完好无损。前面的删除操作只拿掉了一个 ,因此后续查询第二小仍然能稳稳地拿到剩下的那个 。)
七、选学:维护重复值的另一种策略与子树统计
问题背景:前面我们采用“每个元素建一个新节点”来处理重复值,这是最符合物理直觉的暴力美学。如果某个元素被连续插入十万次(比如 [4, 4, 4, ...]),随机优先级下树高仍是期望 cnt 字段,表示“这个数值出现了几次”。
状态与统计:
我们在 Node 中加入 cnt。相应的,sz 的含义也要升级为子树中所有数值的总出现次数。
sz的推导 (Pull):sz[p] = sz[l[p]] + sz[r[p]] + cnt[p]。
同时,平衡树不仅仅能回答排名,还能维护子树统计信息(比如子树内的和 sum、最大值 max_v 等)。只需要在 pull 时顺手合并左右子树的信息即可:
sum[p] = sum[l[p]] + sum[r[p]] + v[p] * cnt[p]。
(注:如果采用这种写法,插入和删除时就不能无脑 merge 顶替,而是在拆出目标节点后,修改其 cnt 并重新计算。由于需要额外特判 cnt == 0,代码细节会变多。教练建议:如果不卡空间,默认使用前面的单节点策略。)
八、选学:按排名分裂的隐式 Treap
场景:有的问题完全不关心数字的大小顺序,比如“把数组第
物理降维(隐式键值):
我们抛弃节点里的 v 作为排序依据,而是强行规定:中序遍历的顺序,就是数组从左到右的顺序!
此时,树中没有任何显式的键值决定左右,决定一个节点位置的是它在子树中的排名(Rank / sz)。这就是“隐式 Treap”。
按排名劈开树 (Split by Rank):
目标:split(p, k, a, b),把树 p 的前 a 树,剩下的给 b 树。
剥洋葱式拆解按
- 左子树大小
时:前 个元素一定全在左子树里!根和右子树全部属于 b。我们只需要继续去左子树里切出前个,分出的左半边当 a,右半边接回根的左边。 - 左子树大小
时:左子树和根自己全部属于 a树(共个元素)。我们还需要去右子树再切出 个元素!分出的左半边接回根的右边,右半边当 b。
💡 直观例子与手推: 假设中序遍历代表字符串
[H, E, L, L, O]。每个字母对应一个节点。现在要切出前个字母(即 [H, E, L])。 假如当前根是L,左子树有个元素 [H, E]。 比较发现,左子树+根正好是个元素!所以左子树和根全部去 a树,继续切右子树时要求切个。最终完美分成 [H, E, L]和[L, O]。
九、选学:区间翻转的标记下传 (Pushdown)
问题:拿到了 [L, R] 区间对应的子树,怎么翻转它?
如果去遍历整棵子树,把所有左右儿子交换,那每次操作要花
懒标记 (Lazy Tag) 思想:
我们在根节点上打个欠条:rev[p] ^= 1,表示“以 p 为根的整棵树都需要翻转”,然后立刻打道回府!
下一次,当我们要访问 p 的孩子(比如在分裂、合并前必须经过它),我们再把这个翻转操作真正执行(也就是交换 p 的左右儿子),并且把欠条传给它的左右孩子。
注意,这份写法和前面线段树“当前节点的值已更新”的约定不同:rev 挂在 p 上时,p 的左右儿子还没有交换,要到 pushdown(p) 时才执行 swap。
铁律:先下传 (Pushdown),再干活 只要发生打乱树结构的操作(
split和merge),在往下走访问左右孩子之前,第一步永远是pushdown!如果你拿带着历史欠条的孩子去比较大小或者劈树,结构瞬间就会崩塌。
十、选学:隐式 Treap 维护区间翻转完整程序 (洛谷 P3391)
问题描述:初始序列依次为
输入输出协议:
输入第一行两个正整数
实现要点:
- 取出区间
:只需将树先按 分裂成 a, b,再把b按分裂成 b, c。此时b就是目标区间! - 在
b的根上打懒标记,然后把a, b, c依次merge拼回来。 - 最后输出时,只要中序遍历整棵树即可,但要注意中序遍历的过程也要
pushdown结算欠条!
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;

struct Node{
	int l,r,sz;
	int v;
	uint32_t pri;
	bool rev;
} t[N];

int rt,tot;
mt19937 rng(1337);

inline int newnode(int v){
	int p=++tot;
	t[p].v=v;
	t[p].sz=1;
	t[p].pri=rng();
	t[p].rev=0;
	return p;
}

inline void pull(int p){
	t[p].sz=t[t[p].l].sz+t[t[p].r].sz+1;
}

// 核心机制:下传懒标记,真实交换左右儿子
inline void pushdown(int p){
	if(t[p].rev){
		swap(t[p].l,t[p].r);
		if(t[p].l) t[t[p].l].rev^=1;
		if(t[p].r) t[t[p].r].rev^=1;
		t[p].rev=0; // 结清欠条
	}
}

// 隐式魔法:按子树大小(排名)分裂
void split(int p,int k,int &a,int &b){
	if(!p){
		a=b=0;
		return;
	}
	pushdown(p); // 铁律:先下传再干活

	int s=t[t[p].l].sz;
	if(s>=k){
		// 左子树足够凑齐 k 个
		b=p;
		split(t[p].l,k,a,t[p].l);
		pull(b);
	}else{
		// 去右子树凑剩下的
		a=p;
		split(t[p].r,k-s-1,t[p].r,b);
		pull(a);
	}
}

// 合并依然是看优先级
int merge(int a,int b){
	if(!a || !b) return a+b;
	// 铁律:访问谁就要下传谁
	if(t[a].pri<t[b].pri){
		pushdown(a);
		t[a].r=merge(t[a].r,b);
		pull(a);
		return a;
	}
	pushdown(b);
	t[b].l=merge(a,t[b].l);
	pull(b);
	return b;
}

// 中序遍历打印结果
void print_inorder(int p){
	if(!p) return;
	pushdown(p); // 遍历也要结算欠条
	print_inorder(t[p].l);
	cout<<t[p].v<<" ";
	print_inorder(t[p].r);
}

void solve(){
	int n,m;
	cin>>n>>m;
	for(int i=1;i<=n;i++){
		rt=merge(rt,newnode(i));
	}
	while(m--){
		int l,r,a,b,c;
		cin>>l>>r;
		// 提取区间 [l, r]
		split(rt,l-1,a,b);
		split(b,r-l+1,b,c);
		// 打标记并还原
		t[b].rev^=1;
		rt=merge(merge(a,b),c);
	}
	print_inorder(rt);
	cout<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
💡 自定义边界手推测试
拿一组小数据,在脑海中模拟一下按排名拆解与区间翻转的过程: 输入:
5 2 2 4 1 3输出:
3 4 1 2 5(解析:初始序列为
1 2 3 4 5。第一次翻转区间即翻转 2 3 4,变成1 4 3 2 5。第二次翻转区间即翻转 1 4 3,变成3 4 1 2 5。代码能精准地将每次圈出的子树打上懒标记并还原回去。)
十一、渐进式实战练习指引
洛谷 P3369 【模板】普通平衡树
- 训练指引:这是一道纯粹的机制默写题。第一次默写千万不必追求快!每写完一种查询操作,都请在心里默问一句:“我刚才拆过树吗?我是不是已经用
merge把它原样接回去了?” - 避坑提示:排名第一次查对、第二次突然跑偏?这往往不是排名公式算错了,而是你上一回合查询后忘了还原原树,导致整个右边的大于集合永久性丢失。多拿类似上面
[2, 4, 4, 7]这种包含重复值的小数据去测试前驱、后继和删除,往往比一长串大数更容易帮你暴露出漏洞。
洛谷 P3391 区间翻转(选学)
- 训练指引:对应第八至十节,把按值分裂换成按排名分裂。先用五个数手推两次相交区间的翻转,再默写
split、merge和中序输出。 - 避坑提示:要访问左右孩子时,先把当前节点的
rev下传;只在分裂时下传、输出时却忘了下传,最后的序列仍会错。
做有序集合问题时,用值决定怎么拆,用优先级决定怎么接,用子树大小定位第