一、引入:什么是树上背包?为什么它难?
在普通的背包问题中,物品是平等的,你想拿谁就拿谁。
但在“树上背包”中,物品之间存在严格的拓扑依赖(上下级)关系:
核心铁律:想要选择子节点(下属),就必须先选择父节点(上司)。就像游戏里的技能树,必须先点亮“火球术”,才能学习“大火球术”。
二、构建基础认知 —— 树上分组背包
这是最符合人类直觉的解法。我们把一棵树,强行看作是《动态规划基础》第六节学过的“分组背包”。
1. 物理视角的转换
假设现在我们在处理节点
- 物品组:每一个子节点
,就是一个“物品组”。 - 组内物品:我们决定分给这个子节点
个容量,这就相当于在这个“物品组”里,挑了一件代价为 ,收益为 的物品。 - 互斥性:对于某一个子节点
,我们最终只能给它敲定一个确定的容量 。这就完美对应了分组背包“每组最多选一件”的铁律。
2. 状态定义与转移方程
定义
转移过程(请牢记三重循环顺序):
- 外层:枚举子节点
(处理每一个物品组)。 - 中层:倒序枚举父节点
的当前总容量 (防止同组物品被重复叠加)。 - 内层:枚举分配给子节点
的容量 (遍历组内物品)。
这正是分组背包的“组号 → 容量倒序 → 组内物品”,只是把组号换成了子树。
(注:公式中的
3. 实战代码:洛谷 P2015 二叉苹果树
场景:给一棵树,保留
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=105;

struct Edge{int v,w;};
vector<Edge> node[N];
int dp[N][N];
int n,q;

void dfs(int u,int fa){
	// 1. 外层:遍历所有子节点 v (遍历物品组)
	for(int i=0;i<node[u].size();i++){
		int v=node[u][i].v;
		int w=node[u][i].w;
		if(v==fa) continue;

		dfs(v,u); // 必须先让子树算完,把 dp[v] 的表填好

		// 2. 中层:倒序枚举当前父节点拥有的容量 j
		for(int j=q;j>=1;j--){
			// 3. 内层:枚举分配给子树 v 的容量 k
			for(int k=0;k<j;k++){
				// 状态转移:保留边(u,v)消耗1个容量,产生w的收益
				dp[u][j]=max(dp[u][j],dp[u][j-k-1]+dp[v][k]+w);
			}
		}
	}
}

void solve(){
	cin>>n>>q;
	for(int i=1;i<n;i++){
		int u,v,w;
		cin>>u>>v>>w;
		node[u].push_back({v,w});
		node[v].push_back({u,w});
	}
	dfs(1,0);
	cout<<dp[1][q]<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
三、跨越性能瓶颈 —— 树上 01 背包与 DFS 序 (DFN)
1. 为什么需要降维?
回头看上面的代码,三重循环的复杂度是
在 P2015 中,容量就是保留边数,本来不会超过树的边数。可换成“每个点有自己的代价”的依赖背包,容量
先搭一座桥:前面把收益记在边上,后面把代价和收益记在点上。若要转换二叉苹果树,可把父子边的收益搬到子节点、代价设为 1,根节点代价和收益设为 0;选一条边就对应选择它下面的点。
2. DFS 序(DFN)的神奇魔法
树形结构难处理,是因为它分叉。
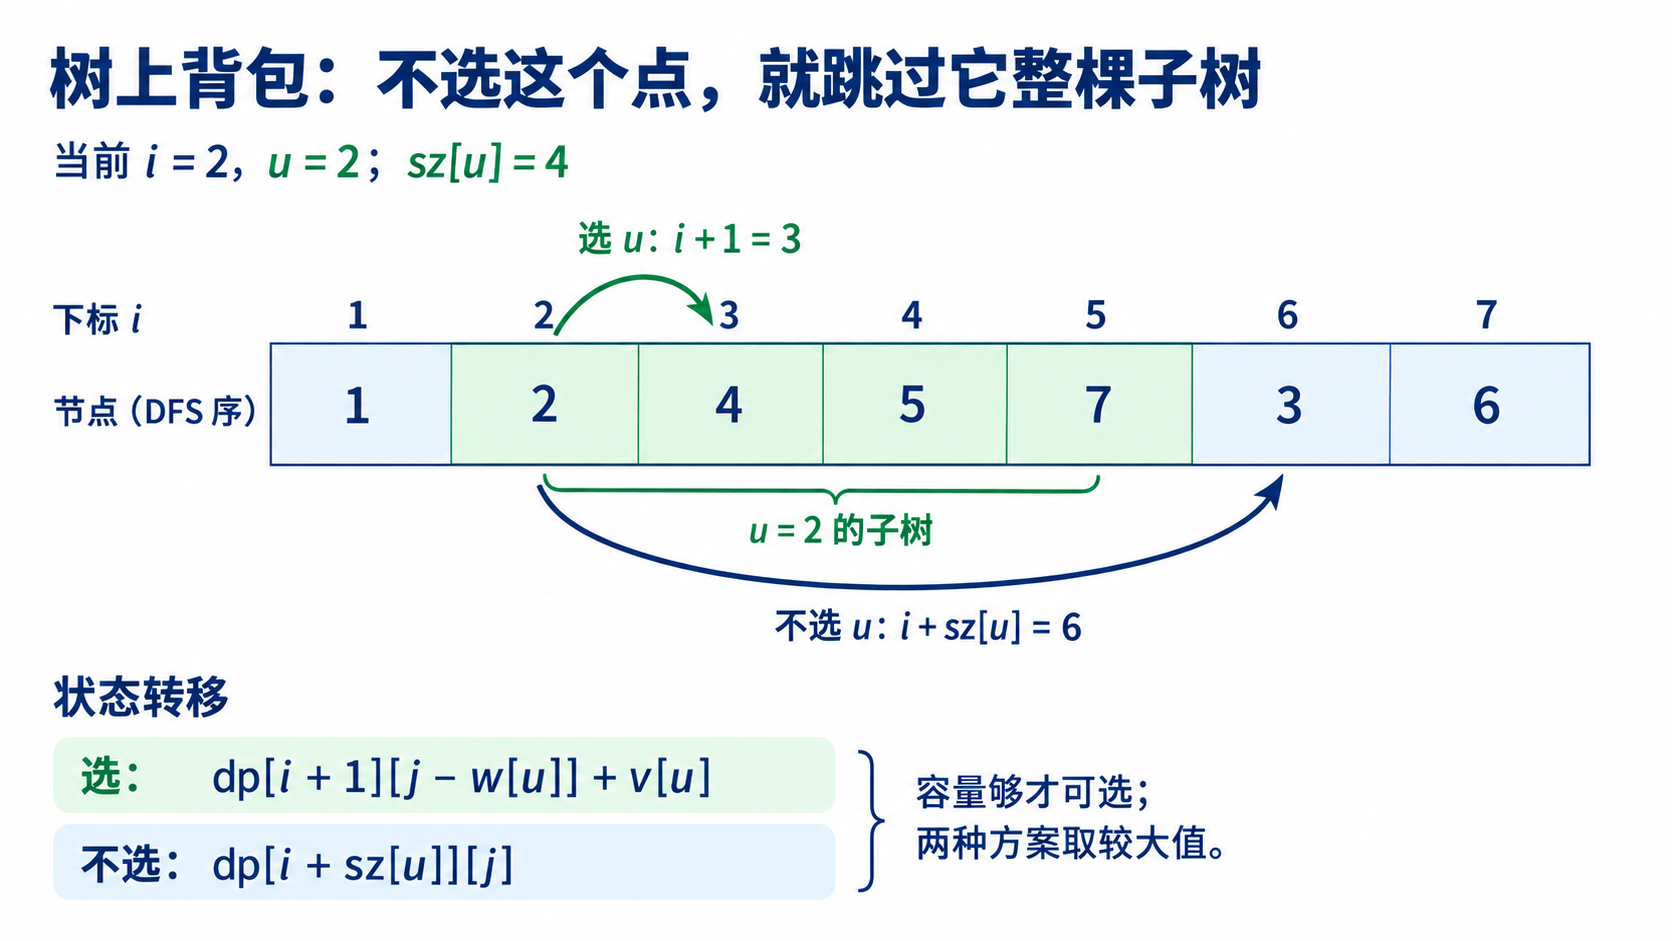
如果我们记录下 DFS 遍历每个节点的顺序(进入的顺序),就可以把这棵树拍扁成一个一维数组。
核心性质:在一棵树的 DFS 序数组中,任何一个节点
及其所有的子树节点,一定是连续的一段区间!区间的长度就是子树的大小 sz[u]。
3. 基于 DFN 的极简状态转移
把树拍扁成一维数组 seq 后,我们从数组的末尾(叶子)向前推导到开头(根)。
定义
现在面对第
| 你的选择 | 物理后果 | 状态转移方向 |
|---|---|---|
| 绝对不选 |
因为没选父节点,它的整棵子树都彻底失去了被选择的资格。 | 我们必须跨过整个子树的区间。下一个能考虑的节点在 dp[i][j] = dp[i + sz[u]][j] |
| 选了 |
支付了 |
继续考虑 DFS 序的下一个位置 dp[i][j] = dp[i+1][j - w[u]] + v[u] |
两者取最大值即可!我们彻底消灭了那层多余的
4. 实战代码:洛谷 P2014 选课(降维版)
场景:大学选修课,有先修课要求(形成树形依赖),选
下面为了统一转移,虚拟根 0 也消耗 1 个容量,但学分为 0。所以真正选 m 门课时,查询的是 m+1 个容量,别把这多出来的 1 当成多选了一门课。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=305;

vector<int> node[N];
int s[N],dfn[N],sz[N],seq[N];
int dp[N][N];
int n,m,timer;

// 1. 预处理出 DFS 序和子树大小
void dfs(int u){
	sz[u]=1;             // 自己占 1 个位置
	dfn[u]=++timer;      // 记录打卡时间戳
	seq[timer]=u;        // 把节点放进拍扁后的一维数组
	for(int i=0;i<node[u].size();i++){
		int v=node[u][i];
		dfs(v);
		sz[u]+=sz[v];    // 累加子树大小
	}
}

void solve(){
	cin>>n>>m;
	for(int i=1;i<=n;i++){
		int k;
		cin>>k>>s[i];
		node[k].push_back(i); // k 是 i 的先修课
	}
	dfs(0); // 0 号点作为虚拟总根节点

	// 2. 在拍扁的一维数组上逆序 DP
	for(int i=n+1;i>=1;i--){
		int u=seq[i];
		for(int j=0;j<=m+1;j++){
			// 策略A:绝对不选 u,直接跳过它整棵子树的范围
			dp[i][j]=dp[i+sz[u]][j];

			// 策略B:选了 u,解锁子树,走向下一个节点 i+1
			if(j>=1){
				dp[i][j]=max(dp[i][j],dp[i+1][j-1]+s[u]);
			}
		}
	}
	cout<<dp[1][m+1]<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
四、极致泛化 —— 树上完全背包(选学)
场景:在满足树形拓扑依赖的前提下,每个节点不再只能选 1 次,而是可以无限次选取。求容量
下面约定真实节点的代价 w[u]>0,只有虚拟根是 0 代价、0 收益。如果某个真实物品 0 代价却有正收益,还能无限拿,答案就已经无上限,不能套普通背包。
1. 逻辑推导:如何实现“无限次”?
回顾刚刚的 DFN 树上 01 背包:当我们决定“选
既然允许无限次选取,当我们在容量
2. 状态转移变体
| 你的选择 | 状态转移方程 | 解释 |
|---|---|---|
| 绝对不选 |
dp[i][j] = dp[i + sz[u]][j] |
同 01 背包,直接跳跃封闭子树 |
| 首次选取 |
dp[i][j] = max(..., dp[i+1][j - w[u]] + v[u]) |
支付代价,走向 |
| 后续重复选 |
dp[i][j] = max(..., dp[i][j - w[u]] + v[u]) |
停留在状态 |
3. 实战通用模板(可直接作为板书)
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=305,M=10005;

vector<int> node[N];
int w[N],v[N],dfn[N],sz[N],seq[N];
int dp[N][M];
int n,m,timer;

void dfs(int u){
	sz[u]=1;
	dfn[u]=++timer;
	seq[timer]=u;
	for(int i=0;i<node[u].size();i++){
		int child=node[u][i];
		dfs(child);
		sz[u]+=sz[child];
	}
}

void solve(){
	cin>>n>>m;
	w[0]=0,v[0]=0;
	for(int i=1;i<=n;i++){
		int fa;
		cin>>fa>>w[i]>>v[i];
		node[fa].push_back(i);
	}
	dfs(0);

	for(int i=n+1;i>=1;i--){
		int u=seq[i];
		// 1. 不选 u:跳过整棵子树
		for(int j=0;j<=m;j++) dp[i][j]=dp[i+sz[u]][j];

		// 2. 选 u:正序遍历容量,实现无限选取
		for(int j=w[u];j<=m;j++){
			// 首次选取:解锁子树,走向 i+1
			dp[i][j]=max(dp[i][j],dp[i+1][j-w[u]]+v[u]);
			// 重复选取:停留在 i,自我繁衍
			dp[i][j]=max(dp[i][j],dp[i][j-w[u]]+v[u]);
		}
	}
	cout<<dp[1][m]<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
五、实战进阶与必考细节防坑
前面我们完成了从基础分组背包到 DFS 序降维的跨越,但在真实考场上,树上背包还有几个极其容易让人翻车的隐藏陷阱。
1. 复杂度魔术:按子树大小限制容量(
在第二节的“树上分组背包”中,如果我们要选的容量 m 的三重循环复杂度似乎是可怕的
但只要我们在枚举容量时,严格套上子树当前大小的上限,它就能奇迹般地降到
代码片段对比(对应第二节的按边转移;sz[u] 是当前已合并的点数,sz[v] 是新子树的点数,因此各自的内部边数要减一):
// 暴力写法:毫无顾忌地跑满 m,复杂度 O(N^3)
for(int j = m; j >= 1; j--)
    for(int k = 0; k < j; k++)

// 降维打击写法:严格受限于当前的物理大小,复杂度 O(N^2)
for(int j = min(m, sz[u] + sz[v] - 1); j >= 1; j--)
    for(int k = max(0LL, j - sz[u]); k <= min(j - 1, sz[v] - 1); k++)
进入 dfs(u,fa) 时先设 sz[u]=1,每合并完一个孩子再加上 sz[v]。这里的 m 是第二节代码中的边数上限 q;片段只展示循环边界,内层仍接原来的按边转移。
为什么会变成
2. 物理换算:选点数与选边数的错位
在树形图中,有一个永远成立的连通块常识:点数 = 边数 + 1。
很多题目(比如前面的二叉苹果树)会问:“保留
3. 初始化陷阱:负权与“恰好装满”
前面的讲解中,我们默认“不选物品的收益是 0”,而且求的是“最多装 dp 数组全设为 0 就会酿成大错,节点价值可能为负数时尤其明显。
- 物理后果:系统会以为你凭空造出了一个“选了
个物品,收益却为 0”的合法状态,去和别人合并。这会让负权节点的亏损被 0 强行垫底掩盖。 - 正解操作:
必须把整个 DP 数组初始化为极小值(如
-1e18),仅仅把“空选”状态设为合法:dp[i][0] = 0(容量为 0 时收益为 0,代表整棵子树直接跳过)。在状态合并转移时,必须加一条判定:只有当左右半边都不是极小值时,才允许相加!
4. 避坑指南:DFS 序优化的适用边界
第三节里用 DFS 序把树拍扁,消灭了枚举子树容量的循环。但这招只适用于严苛的依赖模型!
请死死盯住 DFS 序状态转移的核心动作:绝对不选
绝对不能用的场景:如果题目允许“不选父亲,但可以跳过去选底下的儿子”(比如树上的最大独立集),或者“任意不含固定根的连通块”,DFS 序直接破产!因为你失去了直接“跨过”这棵子树的权利。 这时候,你必须老老实实退回去用“按子树合并”的树形 DP,并针对性地修改状态定义(比如加一维记录当前点是否被选)。树上合并的思想是通用的,但不要迷信任何单一模板能“包治百病”。
5. 实战例题:核心基建(选学,自拟练习)
💡 【实战例题:核心基建】 场景:给出一棵
个节点的树,根节点为 1。每个节点有一个权值 (可能为负数)。要求选出一个包含根节点 1 的连通块,并且节点数量恰好为 。求这 个节点权值之和的最大值。 数据范围: , 。 目的:完美融合 子树优化、必须包含根节点、以及负权初始化的所有痛点。
手算小例子:
设树有 3 个点,1 连 2,1 连 3。权值
- 起点:
dp[1..3][0] = 0(不选该子树代价为 0,合法!)。 dfs(2):强制选 2,dp[2][1] = -5。dfs(3):强制选 3,dp[3][1] = 20。- 合并阶段(在根节点 1):
1 和 2 合并,选 1 和 2 时容量为 2,收益为
。 再和 3 合并,如果我们只选 1 和 3(也就是抛弃 2 的子树,利用合法的 dp[2][0] = 0),容量为 2,收益为。 如果没有 dp[i][0] = 0这一关键的起步,或者负数用 0 掩盖,这里的转移就会彻底崩塌。
// 示例输入:
// 5 3
// 10 -5 20 4 -1
// 1 2
// 1 3
// 1 4
// 2 5
//
// 示例输出:
// 34
// 解释:选 1, 3, 4 号点。权值和:10 + 20 + 4 = 34。虽然 2 号点是负权,但我们可以用 dp[2][0] = 0 直接跳过它所在的整棵子树。

#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=2005;
const int INF=1e18;

vector<int> node[N];
int v[N], sz[N];
int dp[N][N];
int n, m;

void dfs(int u, int fa) {
	sz[u] = 1;
	dp[u][1] = v[u]; // 强制选自己,容量占 1

	for(int i=0; i<node[u].size(); i++) {
		int child = node[u][i];
		if(child == fa) continue;

		dfs(child, u); // 必须先让儿子算完

		// 临时数组备份,防止本轮刚算出的新状态被同轮的后续计算错误引用
		vector<int> tmp(m + 1, -INF);

		// 1. 复杂度魔术:严格按各自子树大小限制容量上限
		for(int j = 1; j <= min(m, sz[u]); j++) {
			// k=0 表示在这棵子树里一个点都不选 (合法,因为 dp[child][0] == 0)
			for(int k = 0; k <= min(m - j, sz[child]); k++) {
				// 3. 初始化陷阱:只有当两边都是合法状态时,才允许合并
				if(dp[u][j] != -INF && dp[child][k] != -INF) {
					tmp[j + k] = max(tmp[j + k], dp[u][j] + dp[child][k]);
				}
			}
		}

		// 更新子树大小,并将合并后的结果拷回当前节点的 DP 数组
		sz[u] += sz[child];
		for(int j = 1; j <= min(m, sz[u]); j++) {
			dp[u][j] = tmp[j];
		}
	}
}

void solve() {
	cin >> n >> m;
	for(int i=1; i<=n; i++) cin >> v[i];

	// 初始化为极小值,消灭所有非法状态的干扰
	for(int i=1; i<=n; i++) {
		for(int j=1; j<=m; j++) {
			dp[i][j] = -INF;
		}
		dp[i][0] = 0; // 极其重要的合法起点:容量为 0 时收益为 0,表示跳过这棵子树
	}

	for(int i=1; i<n; i++) {
		int x, y;
		cin >> x >> y;
		node[x].push_back(y);
		node[y].push_back(x);
	}

	dfs(1, 0);

	// 根节点必须包含,直接查表
	cout << dp[1][m] << '\n';
}

signed main() {
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}