在处理字符串问题时,我们最常面临的需求是:判等、去重、统计频次。很多时候,我们下意识会直接调用 C++ 标准库中的容器。但当数据量级上升,或者需要高频比对“子串”时,常规容器往往会成为性能瓶颈。
字符串哈希正是为了跨越这一瓶颈,将
一、引入:从 map 到 unordered_map 的底层局限
假设我们需要统计一堆长度为
1. 使用 std::map<string, int>
- 底层实现:红黑树(平衡二叉搜索树)。
- 时间复杂度:每次插入或查询,都需要在树中走
步。而在每个节点进行字符串比较大小的时间是 。因此单次操作的真实复杂度是 。 - 局限:非常安全,但由于频繁的字符串逐位比对,常数极大,极易被卡 TLE。
2. 使用 std::unordered_map<string, int>
- 底层实现:哈希表 (Hash Table)。
- 时间复杂度:它会在底层调用默认的哈希函数,将字符串算出一个特征值(整数),然后映射到桶中。单次查询的理论复杂度是
,但计算字符串哈希值的过程依然需要遍历整个字符串,耗时 。因此整体单次操作复杂度是 。 - 局限:比
map快,但面临两个致命问题:- 容易发生哈希冲突,最坏情况下会退化成链表导致
。 - 无法快速处理子串查询。如果我们需要知道
和 是否相等,必须先用 s.substr()截取子串(耗时),再进行哈希比对。如果这种查询有 次,总复杂度将高达 ,直接崩溃。
- 容易发生哈希冲突,最坏情况下会退化成链表导致
核心痛点:STL 容器只能处理“整个字符串”的映射。为了在长文本中实现任意局部子串的
二、核心原理与多项式状态转移
字符串哈希的核心逻辑是:设计一个严谨的数学函数,将一个字符串映射为一个相对唯一的整数。
为了保证哈希函数分布均匀,且能够快速利用前缀信息计算任意子串的哈希值,我们采用多项式滚动哈希 (Polynomial Rolling Hash)。
将一个字符串
提取任意子串的哈希值(状态转移公式):
如果我们预处理出了字符串所有前缀的哈希值数组
这相当于十进制中提取数字的某几位(将左侧多余的部分乘上对应的位权后减去):
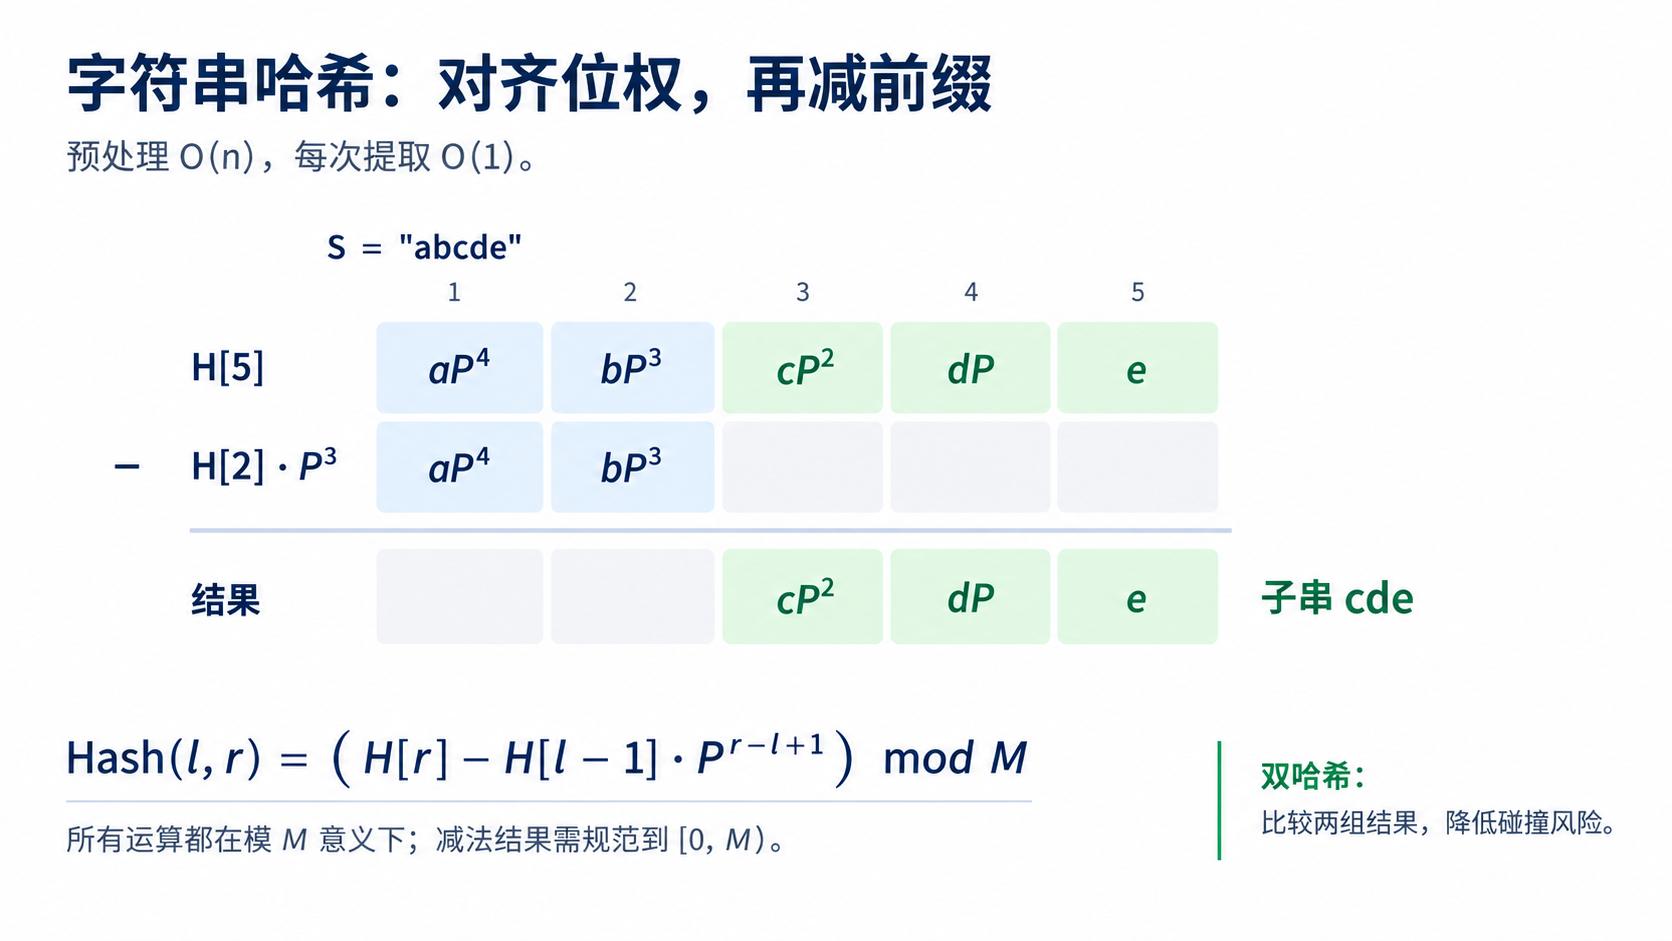
三、标准求解算法与多维模板
下面三种前缀模板任选一种使用,都约定字符串是 1-based:先读入 s,记下 n=s.size(),再执行 s=" "+s; init(s,n);。不要把没有补空格的字符串直接传进去。第四节的整串去重程序则直接遍历原串,不需要补空格。
在实际应用中,模数
1. 自然溢出法 (最简实现,常数极小)
利用 unsigned long long 的数据范围特性(自动对
注意:在极其严苛的比赛中,出题人可能会构造针对自然溢出的冲突数据(如特定的 a/b 序列)。
#include<bits/stdc++.h>
#define int long long
using namespace std;
typedef unsigned long long ull;

const int N = 1e6 + 5;
const int P = 13331;
ull h[N], p[N];

// 预处理前缀哈希和 P 的幂次
void init(string s, int n) {
    p[0] = 1;
    for (int i = 1; i <= n; i++) {
        h[i] = h[i - 1] * P + s[i];
        p[i] = p[i - 1] * P;
    }
}

// O(1) 提取子串哈希
inline ull get_hash(int l, int r) {
    return h[r] - h[l - 1] * p[r - l + 1];
}
2. 单模数法 (规避自然溢出构造)
手动定义大质数作为模数(如
需特别注意:减法运算中可能会产生负数。必须使用 (val % mod + mod) % mod 来保证结果为正。
const int N = 1e6 + 5;
const int P = 13331;
const int mod = 1e9 + 7;
int h[N], p[N];

void init(string s, int n) {
    p[0] = 1;
    for (int i = 1; i <= n; i++) {
        h[i] = (1LL * h[i - 1] * P + s[i]) % mod;
        p[i] = 1LL * p[i - 1] * P % mod;
    }
}

inline int get_hash(int l, int r) {
    return (h[r] - 1LL * h[l - 1] * p[r - l + 1] % mod + mod) % mod;
}
3. 双哈希法 (多加一道碰撞防线)
使用两组不同的底数和模数分别计算,两组哈希值都相等时才判作相等。下面选用两个十亿级质数,降低碰撞风险,适合子串判等、回文和 LCP 查询。记住:双哈希是多一道保险,不是绝对不会碰撞。
const int N = 1e6 + 5;
const int mod1 = 1000000007, mod2 = 1000000009;
const int p1 = 131, p2 = 13331;
int h1[N], h2[N], bas1[N], bas2[N];

void init(string s, int n) {
    bas1[0] = bas2[0] = 1;
    for (int i = 1; i <= n; i++) {
        bas1[i] = 1LL * bas1[i - 1] * p1 % mod1;
        bas2[i] = 1LL * bas2[i - 1] * p2 % mod2;
        h1[i] = (1LL * h1[i - 1] * p1 + s[i]) % mod1;
        h2[i] = (1LL * h2[i - 1] * p2 + s[i]) % mod2;
    }
}

inline pair<int, int> get_hash(int l, int r) {
    int v1 = ((h1[r] - 1LL * h1[l - 1] * bas1[r - l + 1]) % mod1 + mod1) % mod1;
    int v2 = ((h2[r] - 1LL * h2[l - 1] * bas2[r - l + 1]) % mod2 + mod2) % mod2;
    return {v1, v2};
}
四、核心应用与实战演练
除了简单的全串比对,字符串哈希配合二分查找,可以在对数时间内解决大量复杂的子串特征问题。
1. 💡 基础应用:哈希唯一性去重 (洛谷 P3370)
相较于直接使用 std::set<string> 的 sort + unique 去重,复杂度优化为
#include<bits/stdc++.h>
#define int long long
using namespace std;
typedef unsigned long long ull;

const int N = 10005;
const ull P = 131;
ull a[N];

inline ull get_str_hash(string s) {
    ull res = 0;
    for (int i = 0; i < s.length(); i++) res = res * P + s[i];
    return res;
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    int n; cin >> n;
    for (int i = 1; i <= n; i++) {
        string s; cin >> s;
        a[i] = get_str_hash(s);
    }
    sort(a + 1, a + 1 + n);
    int ans = unique(a + 1, a + 1 + n) - (a + 1);
    cout << ans << '\n';
    return 0;
}
2. 💡 进阶应用:最长公共前缀 (LCP) 的
公共前缀具有单调性。如果长度为
int get_lcp(int i, int j, int n) {
    int l = 1, r = min(n - i + 1, n - j + 1), ans = 0;
    while (l <= r) {
        int mid = (l + r) >> 1;
        if (get_hash(i, i + mid - 1) == get_hash(j, j + mid - 1)) {
            ans = mid;
            l = mid + 1;
        } else {
            r = mid - 1;
        }
    }
    return ans;
}
3. 💡 延展:
回文串具有中心对称性。若一个子串是回文串,则其正向哈希值必然等于反向哈希值。我们可以预处理出正反两套哈希,枚举每一个可能的回文中心,然后对扩展半径进行二分。
这一小节可与第六节连读,放在主课末尾或第二课时。数据到千万级,或题目要求线性时间时,使用《Manacher 算法》;这里重点练习哈希与二分的配合。
#include<bits/stdc++.h>
#define int long long
using namespace std;
typedef unsigned long long ull;

const int N = 2e6 + 5;
const ull P = 131;
char s[N];
ull h1[N], h2[N], p[N];

inline ull get_forward(int l, int r) {
    return h1[r] - h1[l - 1] * p[r - l + 1];
}

inline ull get_backward(int l, int r) {
    return h2[l] - h2[r + 1] * p[r - l + 1];
}

inline bool is_palindrome(int l, int r) {
    return get_forward(l, r) == get_backward(l, r);
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    string str; cin >> str;
    int n = str.length();
    for (int i = 1; i <= n; i++) s[i] = str[i - 1];

    p[0] = 1;
    for (int i = 1; i <= n; i++) {
        h1[i] = h1[i - 1] * P + s[i];
        p[i] = p[i - 1] * P;
    }
    for (int i = n; i >= 1; i--) h2[i] = h2[i + 1] * P + s[i];

    int ans = 1;
    // 奇数长度
    for (int i = 1; i <= n; i++) {
        int l = 0, r = min(i - 1, n - i), res = 0;
        while (l <= r) {
            int mid = (l + r) >> 1;
            if (is_palindrome(i - mid, i + mid)) {
                res = mid;
                l = mid + 1;
            } else r = mid - 1;
        }
        ans = max(ans, res * 2 + 1);
    }
    // 偶数长度
    for (int i = 1; i < n; i++) {
        int l = 1, r = min(i, n - i), res = 0;
        while (l <= r) {
            int mid = (l + r) >> 1;
            if (is_palindrome(i - mid + 1, i + mid)) {
                res = mid;
                l = mid + 1;
            } else r = mid - 1;
        }
        ans = max(ans, res * 2);
    }
    cout << ans << '\n';
    return 0;
}
五、进阶技巧:子串哈希的
有些题目不仅要求提取子串,还要求把两段不连续的子串“拼”在一起。例如:我们要在一个长度为
每次都用 s.erase() 重新生成字符串再求哈希,复杂度是
推导与十进制类比:
假设我们有两段独立的字符串
这就好比我们有两个十进制数字
在字符串哈希中,进制是
代码实现与应用:
inline ull concat_hash(ull hash_A, ull hash_B, int len_B) {
    // 自然溢出写法。注意乘的是 B 的长度对应的 P 的幂次,相当于给 A 腾出空间
    return hash_A * p[len_B] + hash_B;
}
回到刚才挖掉字符的问题,如果删掉原串第
ull res = concat_hash(get_hash(1, k - 1), get_hash(k + 1, n), n - k);
六、避坑指南:正反哈希的坐标映射与优雅实现
回看第四节第 3 小节求解最长回文子串的代码,我们在处理反向哈希时,做了一个非常巧妙的处理:直接从右向左构建 h2 数组,而不是把原串翻转成一个新串。
为什么不建议直接翻转原串?
很多初学者习惯做 string rev_s = s; reverse(rev_s.begin(), rev_s.end());,然后对 rev_s 求普通的前缀哈希。
这里的痛点在于:坐标映射极其容易算错。
假设原串 AB)的反向哈希。如果在翻转后的串
优雅解法的物理推导:
为了彻底避开坐标映射,原代码采用了逆向递推:
h2[i] = h2[i + 1] * P + s[i]
它的物理意义是:把字符串从末尾倒着读,当成一个多项式。h2[l] 内部实际上包含了原串从末尾
当我们需要提取
get_backward(l, r) = h2[l] - h2[r + 1] * p[r - l + 1]
此时提取出的哈希值,天然就是这截子串倒着读的哈希值。我们完全不需要改变
七、选学:哈希查重与精确比较的分工验证
在绝大多数信奥常规赛题中,自然溢出或双模数哈希已经足够拿到满分。但如果在真实的工业系统,或者遇到极其险恶的“哈希碰撞”构造数据时,我们该如何保证百分百的准确率?
核心思想:分工协作。
无论哈希函数分布多么均匀,只要将大范围数据映射到小范围,必然存在极小概率的碰撞(鸽巢原理)。因此,严谨的做法是不让哈希承担“绝对判等”的全部重任,而是把它降级为
- 第一步(粗筛):比较两者的哈希值。如果不等,这两段字符串绝对不同,立刻否定,省去这次逐字符比较。
- 第二步(精判):如果哈希值相等,此时存在微小的“假阳性”概率。我们直接动用底层的字符串逐位比较(
),进行最终的精确裁决。
下面是一份基于拉链法哈希表实现的严格字符串查重程序。它既享受了哈希表极速定位的快感,又通过底层的原始字符串比较,排除了哈希冲突导致的误判。
// 场景:统计独立不重复的字符串个数,要求百分百精确,不容忍任何哈希碰撞。
// 输入:第一行包含一个整数 n。接下来 n 行,每行一个长度不超过 10 的字符串 s。
// 输出:一个整数,表示不重复的字符串数量。
// 数据范围:1 <= n <= 10000。
#include<bits/stdc++.h>
#define int long long
using namespace std;

const int M = 1000003; // 取一个大质数作为哈希表的桶数
const int P = 131;
vector<string> hash_table[M]; // 拉链法:每个桶存放一个动态数组,解决冲突

// 计算字符串单次哈希
int get_hash(const string& s) {
    int res = 0;
    for (char c : s) {
        res = (res * P + c) % M;
    }
    return res;
}

void solve() {
    int n;
    if (!(cin >> n)) return;

    int unique_cnt = 0;
    for (int i = 1; i <= n; i++) {
        string s;
        cin >> s;

        int h = get_hash(s);
        bool found = false;

        // 分工机制:只有哈希值相等(落入同一个桶)时,才触发 O(L) 的精确比较
        for (const string& exist_str : hash_table[h]) {
            if (exist_str == s) { // 最终防线:底层逐字符核对
                found = true;
                break;
            }
        }

        // 如果在桶里没搜到精确匹配的串,说明是一个全新的字符串
        if (!found) {
            hash_table[h].push_back(s);
            unique_cnt++;
        }
    }
    cout << unique_cnt << '\n';
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
💡 【自拟样例验证】
输入:
5
apple
banana
apple
orange
banana
输出:
3
在这套架构下,即便出题人刻意构造了两个哈希值完全一样但字符不同的串,它们会被扔进同一个 hash_table 桶里,但在 exist_str == s 这一关原形毕露,从而保证逻辑的绝对严密。
八、哈希策略多维对比与适用指南
| 策略维度 | 自然溢出 (ull) | 单模数取模 | 双模数双哈希 |
|---|---|---|---|
| 运算速度 | 最快(底层截断,无除法) | 适中(包含取模指令) | 较慢(计算量翻倍) |
| 碰撞风险 | 常规数据下较低,但有构造风险 | 取决于模数,批量比较时更需注意 | 双重校验进一步降低风险,但不为零 |
| 代码编写 | 极低 | 低(需处理减法负数取模边界) | 稍高(双套数组维护) |
| 使用场景 | 绝大多数常规非构造题目 | 速度要求高,且出题人封禁溢出时 | 子串判等、回文、LCP 查询 |