看到两层循环,能不能把里面那层换成单调队列?不一定。看到一个平方,能不能直接套斜率优化?也不一定。
优化不是给代码换一个更高级的容器,而是剥开公式的洋葱皮,找到我们在反复计算的内容,并证明哪些工作可以合并、哪些候选人可以永远淘汰。本篇我们不再重讲单调队列的基础模板,而是解决如何从转移式子中认出窗口,实施真正的降维打击。
先修建议:《单调队列思想》第四节的滑动窗口模板、第九节的 DP 式子识别,以及《动态规划基础》第五节的多重背包。主课读一至五节,再读第八节收尾;第六、七节按需选学。
一、优化的心法:先写出“前驱什么时候可用”
很多同学学 DP 优化,喜欢直接背数据结构模板,这是本末倒置。
假设原式是 f[i] 的物理意义是什么?哪些 j 是合法的候选人?这些 f[j] 算好了吗?每次到底在重复计算什么?
如果连合法范围都没写清,数据结构维护得再漂亮,也可能把未算完的自己当成自己的前驱。优化应该保留原转移,只是更快地算它,而不是悄悄放宽条件。
二、第一层剥洋葱:重复的区间求和,用前缀和收起来
一个课堂小模型:从第 0 级台阶出发,每次能走 1 到 f[i] 为恰好走到第 i 级的方案数,f[0]=1,这 1 种是还没迈步的空走法。
最后一步可以从哪里来?只能是跨了不超过
痛点在哪里?如果 f[4] 是求 f[2]+f[3],计算 f[5] 是求 f[3]+f[4]。相邻两轮的求和区间几乎相同,没必要每次扫一遍!
这层的降维打击,靠的是把区间和拆成两个前缀。
定义灵魂数组 s[-1]=0。设左边界 f[i],再把它加入 s[i],总时间瞬间降为
(注:代码中 s[0] 初始化为 1,否则出发点的走法就全消失了。)
三、第二层降维:多重背包的枚举次数,怎样拍扁成滑动窗口?
已有二进制拆分能解决多重背包。现在试着不拆物品,直接处理一整种物品。
设当前物品价值 g[j] 是处理当前种类之前,总重量不超过 f[j] 是加入这一类后的结果。最朴素的转移是:
痛点:这看着一点都不像连续窗口,因为前驱每次隔了
1. 物理视角的转换:按余数分组
既然隔着
把当前容量写成
这下窗口出来了!外面的
2. 手推一次过期,体会数量限制的物理意义
假设有个物品 w=3, v=5, c=2。
我们在算容量 9 的时候(此时组内余数 r=0,容量 g[3]=4 的基础上,加上 2 件新物品(f[9]=14。
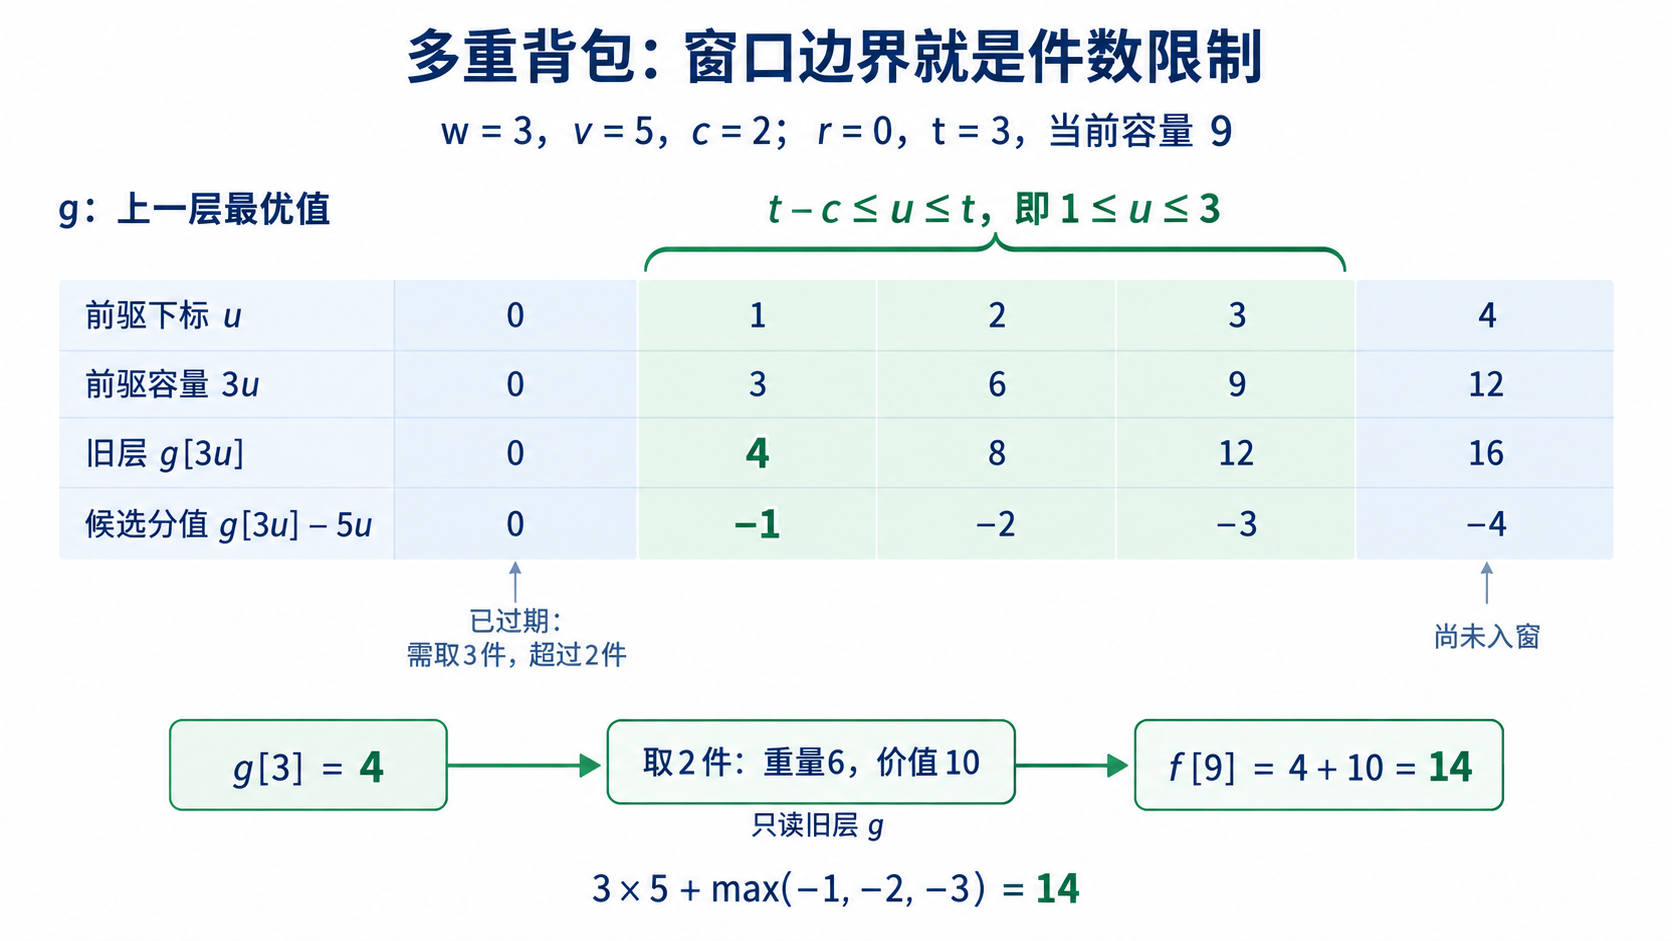
如果队首的
3. 为什么必须先入队,再取答案?
因为 g,不依赖正在计算的 f。
如果直接读取已经更新过的 f[r+uw],候选可能已经拿过当前物品了,这就相当于绕开了件数限制又拿一次。别把“每个容量只赋值一次”误当成不会重复取物品的保证。
物理意义与手算验证:假设只有一种物品,重量
- 算容量 2 时,拿一件得到
f[2]=3。 - 算容量 4 时,若误把已更新的
f[2]当作旧层前驱,再加 3 就得到 6;正确的旧层g[2]=0,所以最多仍只能得到 3。
这样错在绕过了件数上限。本篇用 g = f 保存历史快照,队列只从 g 提取候选,结果写进 f,把读层与写层隔开。若要省掉拷贝,也必须在覆盖某个位置前保存它的旧层候选值,不能把新值回灌进队列。
4. 完整程序一:单调队列优化多重背包
💡 【实战接口】 输入
,随后每行 ;输出不超载时的最大价值。 课堂范围 , , , 。允许什么都不选,不要求装满。(此代码接口可直通洛谷 P1776 宝物筛选)。
运行样例: 输入:
2 10
6 3 2
4 2 2
输出:
20
每种物品的各个余数组合起来,恰好遍历每个容量一次,时间
#include<bits/stdc++.h>
#define int long long
using namespace std;

void solve(){
	int n, W;
	if(!(cin >> n >> W)) return;
	vector<int> f(W + 1, 0); // f[0..W]全为0,对应“不超过容量”的初值

	for(int i = 1; i <= n; i++){
		int v, w, c;
		cin >> v >> w >> c;
		if(w > W || c == 0) continue;
		c = min(c, W / w); // 再多也装不下

		vector<int> g = f; // 必须复制一份旧层,保证拿取件数的物理意义
		for(int r = 0; r < w; r++){
			deque<pair<int, int>> q; // 存 {下标 t, 候选分值}
			for(int t = 0, j = r; j <= W; t++, j += w){
				// 1. 队首淘汰过期候选 (u < t-c)
				while(!q.empty() && q.front().first < t - c) {
					q.pop_front();
				}

				// 2. 当前前驱入场,队尾淘汰弱鸡
				int z = g[j] - t * v;
				while(!q.empty() && q.back().second <= z) {
					q.pop_back();
				}
				q.push_back({t, z});

				// 3. 队首就是窗口最大值,结算 f[j]
				f[j] = q.front().second + t * v;
			}
		}
	}
	cout << f[W] << '\n';
}

signed main(){
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
四、第三层降维:候选的好坏会随查询位置变化
普通单调队列比较的是固定分值。但如果候选 A 的得分是
这类候选是一条条直线,查询时问某个横坐标处谁最低。我们用有明确单调条件的玩具装箱来推一遍凸包优化(斜率优化)。
1. 状态和平方从哪里来?
💡 【实战例题:玩具装箱】 摆放
件玩具,长度为 。同箱相邻玩具间加 1 单位填充。实际箱长为 ,理想箱长为 时,费用是 。求最小总费用。
定义 f[i] 为装好前 i 件的最小总费用,f[0]=0。设
对于每个已完成的前驱
- 斜率
- 截距
当前的任务,就是在求 f[i] 时,查询这些直线在横坐标
2. 什么时候能用队列维护这些直线?
本题玩具长度
- 队首淘汰:前两条线在当前
处的值比对。如果第二条线已经不大于第一条线,由于第二条线斜率更小(下降更快),未来 继续增大时只会更占优势,第一条线就可以永久退出。 - 队尾淘汰:检查斜率递减的三条线
。若 的交点不早于 的交点,意味着 还没来得及胜过 ,就已经被 彻底接管,成了没用的备胎。
交点横坐标为
3. 时序逻辑的闭环:先查询,后加入
绝不能让尚未算好的自己来给自己报价!合法前驱要求 f[i],再把它转化为第
4. 完整程序二:单调凸包优化玩具装箱
输入
运行样例: 输入:
2 3
1
1
输出:
0
溢出警告:
虽然最终答案最优值不超过 long long 能存下),但中间过程的截距 __int128 承接中间运算,强转放在乘法之前,彻底消灭溢出隐患。这不是任意大整数模板,请放心使用。
#include<bits/stdc++.h>
#define int long long
using namespace std;

// 128位宽整数,降维打击防溢出
typedef __int128_t i128;

struct Line {
	int k;
	i128 b;
};

// 计算直线在 x 处的值
i128 get_val(const Line& a, int x){
	return (i128)a.k * x + a.b;
}

// 判断中间的线 b 是否成了无用的备胎
bool bad(const Line& a, const Line& b, const Line& c){
	return (b.b - a.b) * (b.k - c.k) >= (c.b - b.b) * (a.k - b.k);
}

const int N = 50005;
Line q[N];
int head = 1, tail = 0;

void solve(){
	int n, L;
	if(!(cin >> n >> L)) return;

	int s = 0, f = 0;

	// 初始化前驱 0:j=0 时,f[0]=s[0]=0,对应直线 k=0, b=0
	q[++tail] = {0, 0};

	for(int i = 1; i <= n; i++){
		int c;
		cin >> c;
		s += c + 1;
		int x = s - L - 1;

		// 1. 队首淘汰:若第二条线在 x 处已不差于第一条,第一条永久退出
		while(head < tail && get_val(q[head], x) >= get_val(q[head+1], x)){
			head++;
		}

		// 2. 取最优直线结算 f[i]
		f = (int)((i128)x * x + get_val(q[head], x));

		// 3. 把算好的状态封装成直线准备入队
		Line cur = {-2 * s, (i128)f + (i128)s * s};

		// 若斜率相同,保留截距更小的,防止除数为0
		if(head <= tail && q[tail].k == cur.k){
			if(q[tail].b <= cur.b) continue;
			tail--;
		}

		// 4. 队尾淘汰:如果新线让队尾变成备胎,弹掉队尾
		while(head < tail && bad(q[tail-1], q[tail], cur)){
			tail--;
		}

		// 5. 正式入队
		q[++tail] = cur;
	}
	cout << f << '\n';
}

signed main(){
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
五、滚动数组与转移层隔离
读哪个层、写哪个层,要先按原转移式分清。
01 背包靠容量倒序保护旧值;本篇多重背包用 g = f 隔离读写。
具体的件数反例已放在第三节第 3 小节,忘了就回头手推容量 2 和 4。
六、当斜率或查询不再单调:换工具的衔接(选学)
先修提示:需掌握二分查找,或了解基础的平衡树/分治思想。
在玩具装箱问题中,玩具长度都是正数,这给了我们极其完美的单调性:加入的直线斜率单调递减,查询的横坐标
1. 查询位置
场景:如果查询位置
解决策略:保留完整的凸包。因为凸包上的直线斜率依然是有序的,它们各自成为最优解的
代码片段(替换玩具装箱中的队首淘汰和取值部分,依赖原有的队列 q 和有效区间 [head, tail]):
int l = head, r = tail, best_idx = tail;
while (l <= r) {
	int mid = l + (r - l) / 2;
	// 如果 mid 处的线在 x 处不如 mid+1 的线优秀,说明最优切点还在右侧
	if (mid < tail && get_val(q[mid], x) >= get_val(q[mid+1], x)) {
		l = mid + 1;
	} else {
		best_idx = mid;
		r = mid - 1;
	}
}
f = (int)((i128)x * x + get_val(q[best_idx], x));
2. 新加入的斜率
场景:如果物品存在负数,导致计算出的斜率忽大忽小,我们就不能简单地在队尾淘汰备胎了。新来的直线可能直接插进凸包的中间,摧毁了队列的单调性。
解决策略:这就需要动态维护凸包。我们必须果断丢弃单调队列,切换到以下工具:
- 李超线段树 (Li Chao Tree):专门用于维护多条直线,支持任意位置插入和查询最值,代码比手写平衡树短得多。
- CDQ 分治:把动态加线的问题,离线转化为先按斜率排序好的静态加线问题。
小结:看到带有乘积项的转移方程,推导出直线方程后,不要立刻默写双端队列。先确认斜率
七、决策单调性的适用条件与反例意识(选学)
先修提示:需熟练掌握经典的
区间 DP。
很多同学在做区间 DP 时,听说过一个神仙优化:原本
什么是决策单调性?
假设状态
1. 手算真假判定:石子合并 VS 矩阵连乘
正例:非负重量石子合并的最小代价版本
代价函数
致命反例:矩阵连乘
在求矩阵连乘的最小运算次数时,假如矩阵维度是 A: 10x100, B: 100x5, C: 5x50, D: 50x1。
- 只看
: 的代价是 ; 的代价是 。所以最佳分割点是 。 - 加入右边的
后: 的代价是 。最外层按 分割,总代价为 ;按 分割为 ,按 分割为 。所以 。
区间变长了,最佳分割点却从 2 退回 1!矩阵连乘的合并代价是
考场避坑法则:
决策单调性不是免费的常数优化!如果你不确定题目满不满足四边形不等式,先写个朴素的
八、灵魂拷问:优化到底省掉了什么?
最后,我们回头看看:优化前后,哪些东西不能偷偷换掉?
不要看代码都用了一个 while 和队列,就以为它们是同一种套路。
- 前缀和:维护的是已算好的方案数之和。它省掉了每次求和的扫描。
- 单调队列(多重背包):维护的是旧层扣掉线性项后的窗口最大值。它省掉了枚举“当前物品选几件”。
- 斜率优化(凸包):维护的是不同斜率候选直线在查询位置的最小值。它省掉了枚举“最后一箱的起点在哪”。
外层的状态,依然乖乖按照它原本的物理依赖顺序在计算。如果你优化完,连状态含义、可选范围都解释不清了,请立刻退回到朴素转移,而不是继续给数据结构打补丁。解释不了的时候,先别把正确的慢程序换成一个跑得飞快的错误答案。
练习顺序:先做 P1776《宝物筛选》,练习从件数限制推出余数组窗口;再做 P3195《玩具装箱》,练习展开平方、认出直线并检查两种单调性。两题的输入接口分别见第三、四节。