一、卡特兰数 (Catalan Number):不可逾越的对角线
1. 概念引入:从栈到出栈序列
回忆我们之前学过的数据结构“栈”。
问题:假设有
- 前几项数值(强烈建议背诵,方便考场打表找规律):
- 考场上暴力 DFS 跑出这串熟悉的数字,就该想到卡特兰数了!再对照下面的模型,确认限制能对应上,别只凭前几项就硬套。
2. 核心公式与推导(折线法)
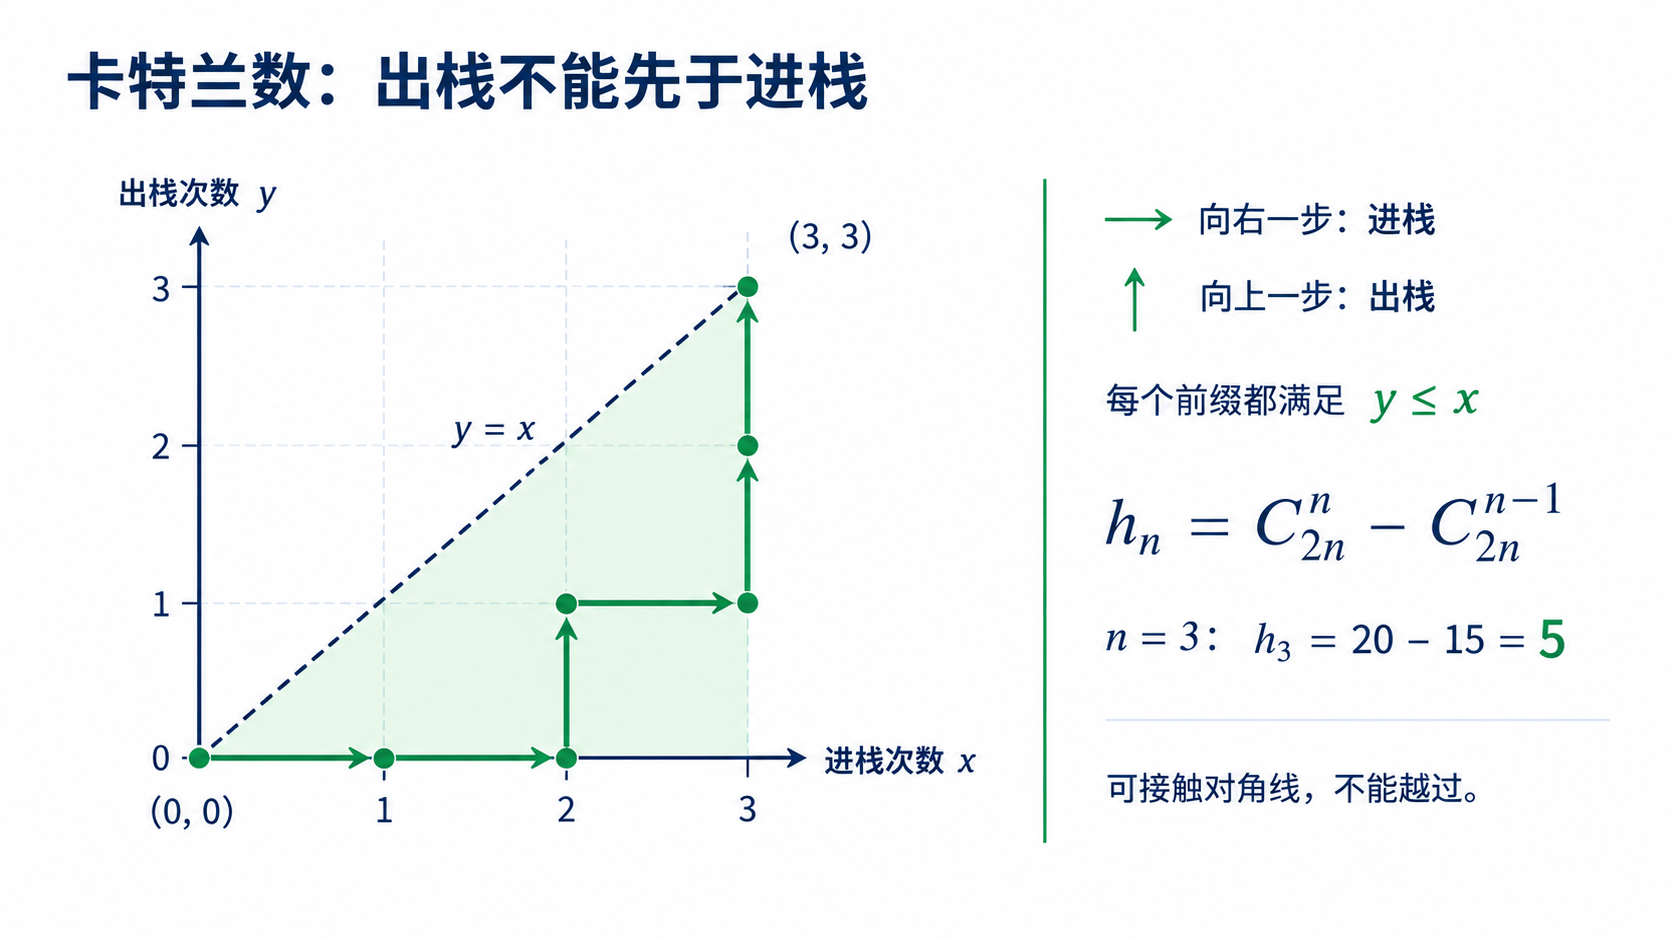
把进栈看作向右走一步,出栈看作向上走一步。总共需要进栈
在二维坐标系中,这等价于从
合法条件:任意时刻,出栈次数不能超过进栈次数。即路径绝不能越过
- 总路径数:一共走
步,挑 步向右,方案数为 。 - 非法路径数:任何触碰或越过
这条线的路径都是非法的。我们将非法路径从第一个触碰点开始,沿着 做对称翻折,终点 必然会被翻折到 。也就是说,所有从 到 的路径,一一对应了所有的非法路径。非法路径数为 。
卡特兰数通项公式:
3. 卡特兰数的 DP 定义(寻找伪装的卡特兰数)
除了组合数公式,卡特兰数还有一个极其重要的递推定义:
物理意义(以有序二叉树为例):我们要构建一个
等价高频模型:“匹配、且不能交叉/越界”是发现卡特兰数的重要线索,下面两类就是经典对应。
- 合法括号匹配:
对括号的嵌套排列(左括号数必须随时 右括号数)。 - 多边形划分:凸
边形通过不相交的对角线划分为三角形,方案数也是 。
4. 常见模型:先看清谁是
考场上最容易错的不是推不出递推式,而是把
- 进出栈序列:
个元素进栈出栈。 即为元素个数。 - 合法括号序列:
对括号(共 个字符)。左括号看作向右走,右括号看作向上走,随时保证左边(横坐标)大于等于右边(纵坐标)。 - 二叉树形态:
个节点构成的不同二叉树形态。 - 多边形三角划分:凸
边形,划分为 个三角形。注意这里的 比边数少 2! - 网格路径:在
的网格中,从 走到 且不越过对角线的合法路径数。
实战防坑:如果题目说的是“凸
二、错排问题 (Derangement):别人占了我的坑
1. 模型定义
有
- 前几项数值:
其中
2. 递推公式推导(故事记忆法)
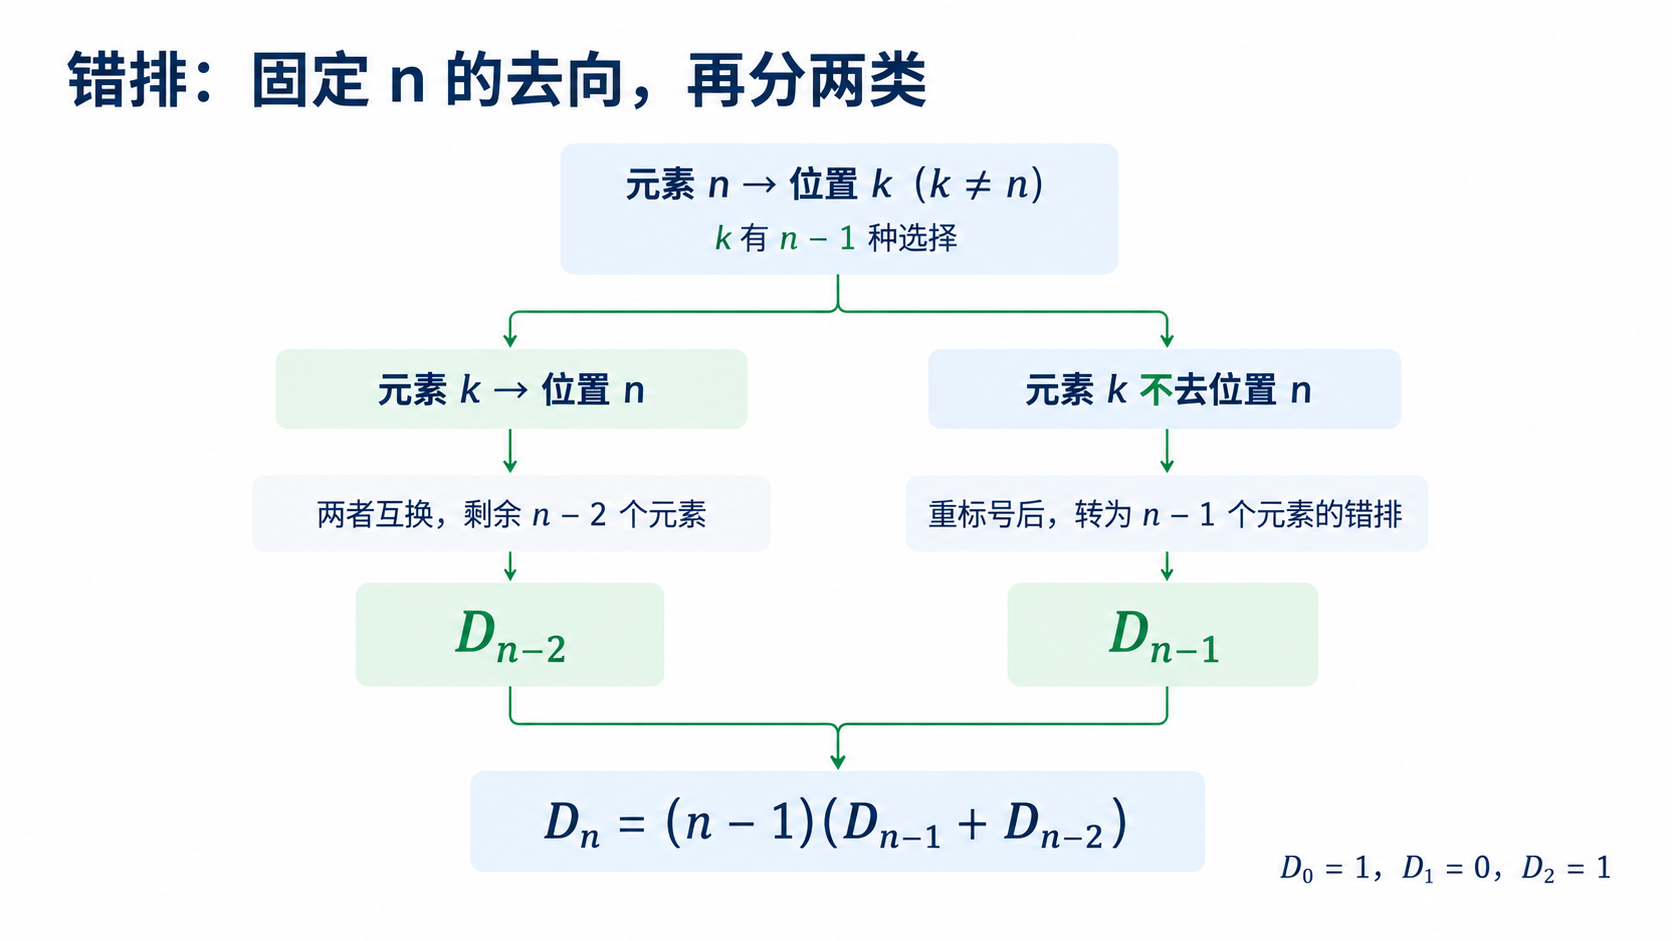
假设我们要放置第
现在轮到元素
- 命运 A(互相成全):元素
刚好去了位置 。两人互相占了对方的坑,完美抵消。剩下的 个元素去抢剩下的 个位置,这就是一个纯粹的 错排问题。 - 命运 B(死磕到底):元素
没有去位置 。此时,我们把剩下的 个位置和 个元素对应起来。元素 有一个绝对不能去的“禁区”(即位置 ),这和其他 个元素不能去自己原位的性质是完全等价的。这是一个规模为 的错排问题,方案数为 。
错排递推公式:
(注:代码预处理非常简单,和斐波那契类似,注意取模即可)
3. 高频变种:部分错排
在竞赛题中,错排通常会与组合数、容斥或其他限制条件结合出现,常见变种是“部分错排”。
题目:求长度为
降维打击:分两步走。第一步,选出哪
终极公式:C(n,m)!)
4. 别把“指定”“恰好”和“至少”混在一起
前文已经讲过“恰好
1. “指定”
场景:班主任明确点名班长和学习委员(这
2. “至少”
场景:班主任只要求,全班至少有
三、容斥原理 (PIE):把交并集翻译成代码
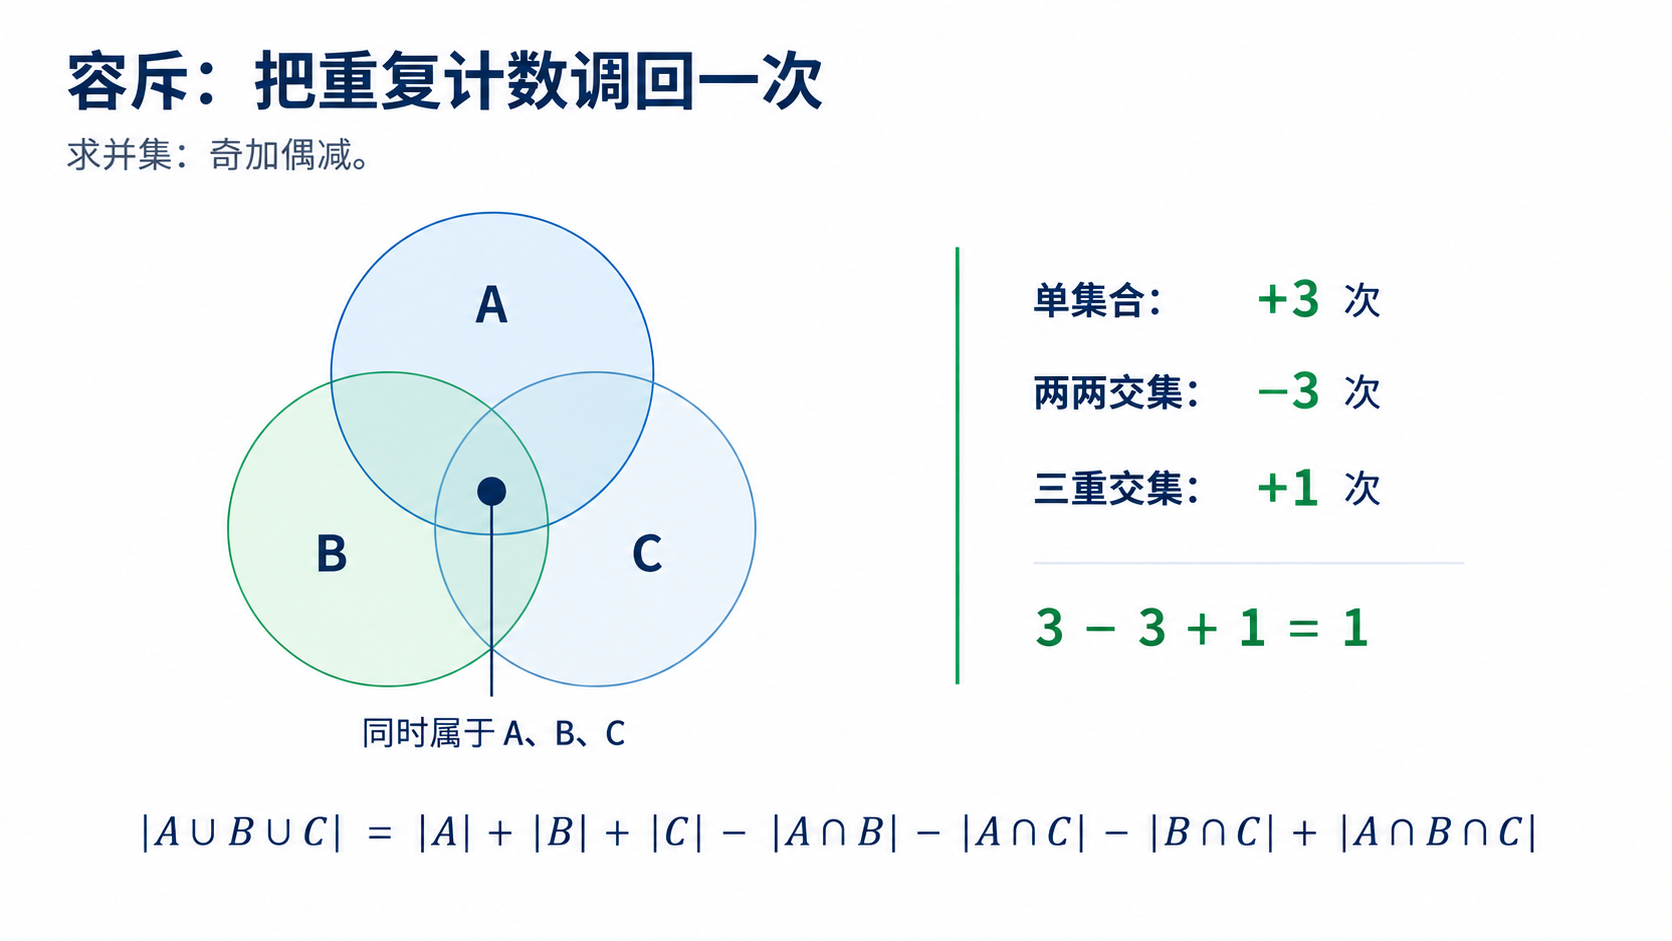
1. 核心思想:“奇加偶减”法则
遇到“恰好、至少、至多、所有都不”等字眼时,立刻条件反射开启容斥模式。
物理规律:包含 1 个条件的集合前是正号,包含 2 个条件的是负号,3 个条件是正号……这就是算法竞赛中著名的“奇加偶减”。
2. 容斥巅峰实战模型:球盒问题
我们直接用一道最经典的题来展示容斥如何翻译成代码。
题目:把
思路破局(正难则反):
正面硬算是算不出的。我们反过来想:
总方案数(随便放)
接下来减去有盒子为空的情况:
- 先选出 1 个盒子强制为空,累加所有选法:
,把这一项减掉。 - 两个空盒子的情况被重复减了,所以选出 2 个盒子强制为空,把
加回来。 - 接着选出 3 个盒子强制为空,再减去
,如此交替。
每一项统计的是“选定这些盒子为空”的方案数之和;其余盒子仍然可以空,因此会发生重复计数,这正是容斥要修正的地方。
总结出极其优美的通项公式:
3. 标准化代码模板(背熟这个结构)
容斥原理在代码中,就是写一个 for 循环,用 sign 变量控制符号翻转,里面调用组合数和快速幂。
代码前置条件:下面的函数接在《数学基础》·组合数
查询的 C(n,m)、qpow()和init()之后使用,入口先调用init()。这里要求mod为质数、m<mod,组合数表覆盖到m;幂、组合数和答案的中间结果使用long long,并及时取模。
int solve_balls_in_boxes(int n, int m) {
    int ans = 0;
    int sign = 1; // 1 表示加,-1 表示减

    // i 表示强制有 i 个盒子为空
    for (int i = 0; i <= m; i++) {
        // 当前情况的方案数 = C(M, i) * (M-i)^N
        int ways = 1LL * C(m, i) * qpow(m - i, n) % mod;

        if (sign == 1) {
            ans = (ans + ways) % mod;
        } else {
            ans = (ans - ways + mod) % mod; // 必须使用安全减法!
        }

        sign = -sign; // 从 i=0 的总方案开始:偶数加、奇数减
    }

    return ans;
}
四、区间互质计数与 lcm 提前截断(选学)
先修要求:熟练掌握唯一分解定理,了解容斥原理的交并集概念。
容斥原理在数论中最经典的降维打击,就是解决“统计某个区间内与
问题模型:给定整数
1. 物理意义的转换
正向去找“谁跟它互质”很难,因为互质的组合没有明显规律。我们再次正难则反:
- 只要一个数
和 含有至少一个相同的质因子,它们就不互质。 - 我们先对
进行质因数分解,找出它所有的独立质因子 。 - 题目变成了:在
中,剔除掉 的倍数、剔除掉 的倍数……
这就是最标准的容斥场景!
- 总数:
- 减去 1 个质因子的倍数:
- 加上 2 个质因子乘积的倍数:
(多个不同质数的最小公倍数 lcm 就是它们的乘积) - 以此类推,严格遵循“奇加偶减”。
2. 代码实现与 lcm 提前截断技巧
在利用 DFS 搜索各种质因子的组合时,如果当前组合出的乘积(lcm)已经大于了
💡 【实战例题】:给定
和 ,求 中与 互质的数的个数。( )
#include<bits/stdc++.h>
#define int long long
using namespace std;

vector<int> primes;

// 预处理:分解质因数,找出 N 的所有独立质因子
void get_prime_factors(int n) {
    primes.clear();
    for (int i = 2; i * i <= n; i++) {
        if (n % i == 0) {
            primes.push_back(i);
            while (n % i == 0) n /= i;
        }
    }
    if (n > 1) primes.push_back(n); // 最后一个大质因子
}

// DFS 实现容斥
// u: 当前考虑到第几个质因子
// current_lcm: 当前选中质因子的乘积
// sign: 符号,1 或 -1
// r: 区间上限
int dfs(int u, int current_lcm, int sign, int r) {
    // 越界提前截断:如果当前乘积已经大于 r,它以及它的子树贡献一定是 0
    if (current_lcm > r) return 0;

    // 如果已经考虑完了所有质因子,返回当前组合对答案的贡献
    if (u == primes.size()) {
        return sign * (r / current_lcm);
    }

    int res = 0;
    // 分支 1:不选当前的质因子 primes[u],lcm 和 符号 都不变
    res += dfs(u + 1, current_lcm, sign, r);

    // 分支 2:选当前的质因子 primes[u]
    // 因为都是不同的质数,lcm 直接乘以 primes[u]。多选了一个条件,符号取反
    res += dfs(u + 1, current_lcm * primes[u], -sign, r);

    return res;
}

void solve() {
    int n, r;
    if (!(cin >> n >> r)) return;

    get_prime_factors(n);

    // 从第 0 个质因子开始,初始 lcm=1,初始符号为 1 (代表加上区间总数 R)
    int ans = dfs(0, 1, 1, r);

    cout << ans << '\n';
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    // 可处理多组数据
    // 示例输入:12 20  (含义: N=12, R=20)
    // 12 的质因子有 2, 3。
    // [1, 20] 中与 12 互质的数有:1, 5, 7, 11, 13, 17, 19 (共 7 个)
    // 示例输出:7
    int T = 1;
    // cin >> T;
    while (T--) solve();
    return 0;
}
小结:当前公倍数已经大于区间上限时,这条分支往下也不会再产生贡献,可以直接剪掉。若区间恰好是