在之前的学习中,我们接触过冒泡排序、选择排序和插入排序。它们的共同点是:无论是找最值还是两两交换,时间复杂度都被困在了
今天,我们要利用分治法(Divide and Conquer)打破这堵墙,将排序的时间复杂度压缩到极速的
分治的核心思想是:把一个大问题,拆分成两个规模减半的小问题。只要小问题解决了,大问题也就迎刃而解。
归并排序 (Merge Sort) 和 快速排序 (Quick Sort) 是分治法的两位绝顶高手,但它们“拆分”和“解决”的哲学却截然相反:
- 归并排序: “先无脑切分,再精细合并”。
- 快速排序: “先精细拆分,再无脑合并”。
图示:左边是归并排序的“先分到底,再一路合并”;右边是快速排序的“先用基准值划分阵营,再递归处理左右两侧”。
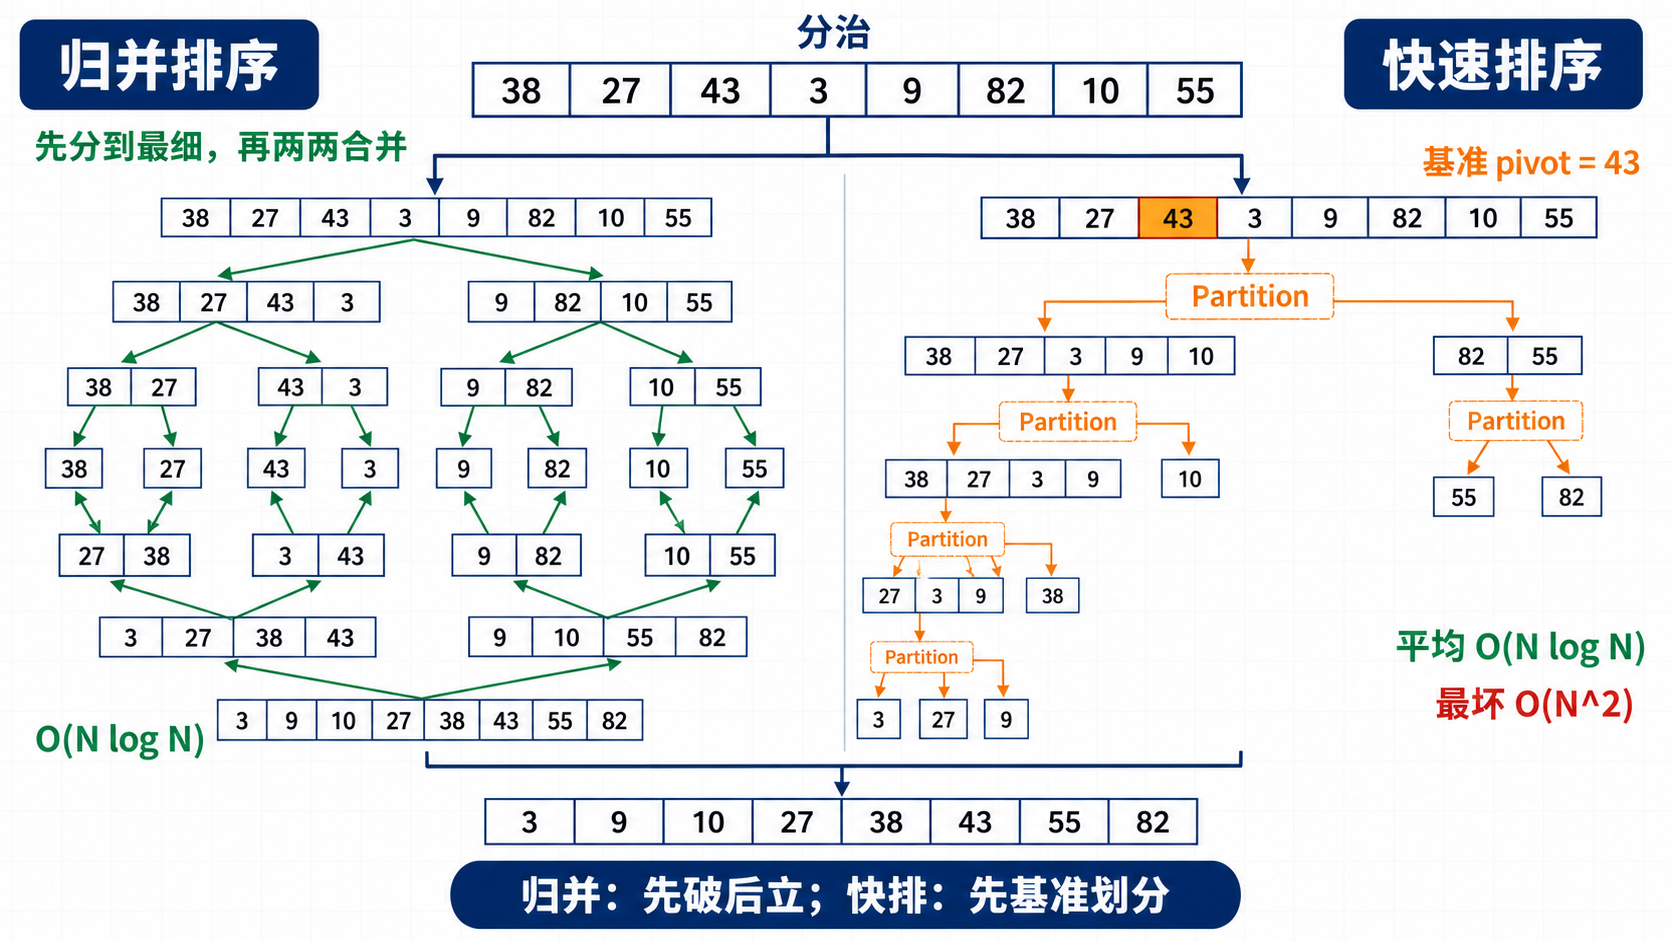
一、归并排序 (Merge Sort):先破后立的合并艺术
1. 核心定义与运行轨迹
归并排序的哲学是“绝对的公平对半切”。
它不在乎数组里装的是什么,闭着眼睛从正中间一刀切开。一直切,直到切成每个小块只有一个元素(一个元素天然是有序的)。然后,再把这些有序的小块,两两“拉链式”合并成更大的有序块,最终拼成完整的有序数组。
通俗理解: “两叠扑克牌的完美穿插”。
假设你有两叠已经排好序的扑克牌,每叠都翻开最上面的一张。你只需比较这两张牌,谁小就把谁拿走放到结果堆里。一直拿,直到有一叠牌被拿空,剩下的直接全扔过去即可。
合并时只需要盯住两个有序区间的“队头”。每次取更小的那个放入
tmp,最后再把tmp覆盖回原数组。
2. 深度原理:合并操作(Merge)
归并排序的核心不在“分”,而在“合”。
合并操作需要借助一个临时数组(辅助数组)。这就是归并排序唯一的缺点:空间复杂度为
#include <bits/stdc++.h>
using namespace std;

const int N = 500005; // 覆盖下文 P1908 的 5×10^5 个元素
int a[N], tmp[N]; // 必须开一个和原数组一样大的临时数组

void merge_sort(int l, int r) {
    if (l >= r) return; // 递归边界:区间内只有一个数字或没有数字,天然有序

    // 1. 无脑对半切
    int mid = (l + r) >> 1;

    // 2. 递归解决左半边和右半边
    merge_sort(l, mid);
    merge_sort(mid + 1, r);

    // 3. 核心:精细合并(将左右两个已经有序的区间,合并到 tmp 数组里)
    int i = l, j = mid + 1, k = l; // i 指向左半区起点,j 指向右半区起点,k 是 tmp 的游标

    while (i <= mid && j <= r) {
        // 谁小拿谁(如果相等,优先拿左边的,保证稳定性)
        if (a[i] <= a[j]) tmp[k++] = a[i++];
        else tmp[k++] = a[j++];
    }

    // 4. 扫尾:肯定有一个区间没拿完,剩下的全搬过去
    while (i <= mid) tmp[k++] = a[i++];
    while (j <= r) tmp[k++] = a[j++];

    // 5. 归位:把排好序的临时数组覆盖回原数组
    for (int p = l; p <= r; p++) a[p] = tmp[p];
}
3. 归并排序的隐藏杀招:求逆序对
归并排序在 OI 中极少直接考裸的排序,它最大的作用是:在
原理推导:
在合并左右两个有序区间时,我们有指针 i(左半区)和 j(右半区)。
如果当前 a[i] > a[j],这就意味着我们发现了一个逆序对!
因为左半区内部是升序的,既然 a[i] 已经大于 a[j] 了,那么 i 后面的所有元素(即 a[i] 到 a[mid])必定也都大于 a[j]!
我们只需要在合并时加上一行统计代码:ans += mid - i + 1;,就能瞬间揪出一大批逆序对。
💡 【实战例题 1:逆序对经典模板】 P1908 逆序对
- 题目大意:求一个给定序列中逆序对(前面的数大于后面的数)的数量。
- 破局点:数据量
。直接双重循环暴力找必死。直接默写归并排序,只需在 a[i] > a[j]的分支里加一行累加代码。注意:逆序对总数可能超过int上限,ans必须开long long!
完整的归并计数程序见《分治与折半搜索》;想对照“离散化 + 树状数组”的做法,可看《离散化》。
二、快速排序 (Quick Sort):基准划分的阵地战
1. 核心定义与运行轨迹
快速排序的哲学是“根据基准点进行阶级划分”。
它在一开始就非常“精细”。它会在数组里挑一个数作为“基准值(Pivot)”。然后扫描数组,把小于基准值的数尽量换到左边,大于基准值的数尽量换到右边。
经过这一轮折腾,数组会被划分成“左侧不大于基准、右侧不小于基准”的两块。注意:在下面这份双指针写法里,pivot 更像一个分界值,不一定代表某个元素已经被钉死在最终位置;真正重要的是左右阵营已经划开,后续只需分别递归。
通俗理解: “班级按身高排队”。
随便拉出一个身高作为分界线,比它矮的尽量站左边,比它高的尽量站右边。左边和右边各自再重复这个过程。
快排的关键不是“排好全部”,而是先把数组按
pivot分成两个阵营:左侧更小,右侧更大,再递归处理。
2. 深度原理:划分操作(Partition)
快排的核心在于“分”。
划分过程不需要额外的数组,完全在原数组上通过双指针交换完成,所以额外数组空间是
void quick_sort(int l, int r) {
    if (l >= r) return; // 递归边界:区间内只有一个元素

    // 1. 精细拆分:确立基准并划分左右阵营
    int i = l, j = r;
    int pivot = a[(l + r) >> 1]; // ⚠️ 考场防坑:基准点强烈建议取中间位置的值,不要取 a[l]

    while (i <= j) {
        while (a[i] < pivot) i++; // 在左边找一个“不该在左边”的大个子
        while (a[j] > pivot) j--; // 在右边找一个“不该在右边”的小个子
        if (i <= j) {
            swap(a[i], a[j]); // 抓到了,互换位置
            i++;
            j--;
        }
    }

    // 2. 无脑合并:对划分好的左右阵营继续递归
    // 此时 j 停在左半阵营的末尾,i 停在右半阵营的开头
    quick_sort(l, j);
    quick_sort(i, r);
}
3. 快排的考场死穴:复杂度退化
快排之所以叫“快”排,是因为在大多数随机数据下,它的表现非常优秀,常数极小。
但它有一个致命弱点:遇到极端数据时,复杂度会退化到和冒泡排序一个量级!
退化原理推演:
如果数组本来就是倒序的(如 9 8 7 6 5),而你偏偏每次取最左边的数字作为基准点。
第一轮,9 是基准,你会发现所有数字都比 9 小,全部扔到了 9 的左边。右边是空的!
一轮
这样递归下去,树的深度会达到 #include <algorithm> 里的 sort(其内部是高度优化的内省排序),而不愿意手写快排的原因。
考场防坑策略:
不要总取最左边或最右边的数当基准。取中间位置的值能避开简单有序数据的坑,但也不是防卡护身符;随机选基准通常更稳,考场只需要排序时直接用 sort。
三、第 k 小的数字:快排分治的降维打击
这是快排在 OI 中的一个神级应用。
💡 【实战例题 2:线性时间找第 K 小】 P1923 【深基9.例4】求第 k 小的数
题目大意:给定
个无序的数( ),求其中第 小的数。时间限制 1.0s。 思路引导:如果直接调用
sort然后输出a[k],复杂度是。对于 的数据,不仅容易超时,而且常数稍大就会被卡。 降维破局: 我们只需要知道第
小是谁,不需要对所有人排序! 接上前面的双指针写法:一轮划分后,左段是
[l,j],右段是[i,r]。目标下标k若满足k<=j,就只去左段;若满足k>=i,就只去右段;夹在中间时直接取a[k]。别把pivot的位置误当成已经固定好的排名。理想或平均情况下,每轮都能丢掉一大块不可能含答案的数据,整体复杂度就能降到
级别。
求第
K小时,目标不是“全排好”,而是不断丢弃不可能含有答案的一侧,只保留K可能落入的区间。
在 C++ STL 中,这个操作已经被封装为了 nth_element。P1923 明确规定最小数是第 0 小,因此把数组存成 a[0..n-1],调用 nth_element(a, a+k, a+n),输出 a[k] 就行。注意本题有
四、排序实战避坑:严格弱序与多关键字
在考场上,我们绝大多数时候直接调用 #include <algorithm> 中的 sort。但用好这个自带的核武器,需要避开几个致命陷阱。
1. 严格弱序:一个等号引发的血案
我们在对结构体或复杂数据进行排序时,经常需要自定义比较函数 cmp。
致命陷阱:在 cmp 函数中写了 <= 或 >=。
// 💥 错误示范:未定义行为,可能崩溃或排错,数据少时往往不暴露
bool cmp(int a, int b) {
    return a <= b; // 绝对不能写等于号!
}
物理推导:C++ 的 sort 在划分左右阵营时,通过 cmp(a, b) 和 cmp(b, a) 的组合来判断元素是否相等(如果都不成立,说明相等)。如果加了等号,遇到两个相等的元素时,sort 会认为它们彼此都严格小于对方,导致底层的双指针无法在相等时停下,疯狂移动并越界访问未分配的内存。
铁律:cmp 函数必须满足“严格弱序”。简单来说,false。永远只用 < 或 > 来定义谁排在前面。
2. 多关键字排序与稳定排序
当面对多个维度的比较(例如:先按总分降序,总分相同按语文成绩降序,再相同按学号升序)时,如何在 cmp 里表达?
代码逻辑拆解:像“剥洋葱”一样一层层判断。不相等的直接决出胜负,相等的才进入下一层比较。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N = 100005;

struct Student {
    int id, score, chinese;
} a[N];

bool cmp(const Student& x, const Student& y) {
    if (x.score != y.score) return x.score > y.score;         // 第一关键字:总分降序
    if (x.chinese != y.chinese) return x.chinese > y.chinese; // 第二关键字:语文降序
    return x.id < y.id;                                       // 第三关键字:学号升序
}

void solve() {
    int n = 3;
    a[1] = {1, 200, 90};
    a[2] = {2, 200, 95};
    a[3] = {3, 210, 80};

    sort(a + 1, a + 1 + n, cmp);

    for (int i = 1; i <= n; i++) {
        cout << "ID: " << a[i].id << " 总分: " << a[i].score << '\n';
    }
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
稳定排序 (stable_sort)(选学)
普通的 sort 是不稳定的(相等的元素相对顺序可能会被打乱)。如果题目明确要求“若各项指标相同,则保持原输入顺序”,且我们没有把“原输入顺序”作为最后一个关键字存进结构体,此时可以直接使用 stable_sort(a+1, a+n+1, cmp)。它的底层实现正是我们讲过的归并排序,能够完美保持相同元素的原始相对位置。
五、深挖第 K 小:期望复杂度与 STL 范围语义
在原有的“第 K 小”解法基础上,我们需要彻底理清它的复杂度和 STL 工具的真正语义。
1. 随机快速选择:为什么不能叫“最坏线性”?
前面提到,利用快排的划分逻辑,每次只去包含目标排名的一侧递归,复杂度可以降到
物理推导:
如果在快速选择(Quickselect)中,遇到极其针对的极端数据,且基准点总是选得很差(比如总是选到该区间内最大或最小的数字),每次划分只能丢掉 1 个无用元素。
原本的递推式
因此,严谨的说法是:随机选取基准点的快速选择算法,其“期望”时间复杂度为
2. nth_element 的作用与范围语义
C++ STL 提供了现成的求第 K 小神器 nth_element。许多同学用错是因为没搞懂它的“半排半不排”特性和区间边界。
语法结构:
nth_element(first, nth, last);
操作的区间是典型的左闭右开 [first, last)。
核心作用与内存状态: 执行后,它做了两件精准的事:
- 把整个区间在假想排序后,本该落在
nth这个位置的元素,真实地安放到了nth的内存位置上。 - 保证了在
nth左边的元素都不大于它,在nth右边的元素都不小于它。
千万注意的坑:
它没有对整个数组进行完全排序!左半区和右半区内部是完全无序的。
比如对 [5, 4, 3, 2, 1] 求第 3 小(放到正中间位置):
执行后数组可能变成 [2, 1, 3, 5, 4]。3 归位了,但前面的 [2, 1] 和后面的 [5, 4] 依然是乱的。如果你妄想直接遍历输出前 K 小的所有数字,必定会得到错误的乱序结果!
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N = 105;

int a[N];

void solve() {
    int n = 9;
    int init_a[] = {0, 9, 2, 7, 3, 1, 8, 4, 6, 5};
    for (int i = 1; i <= n; i++) a[i] = init_a[i];

    // 我们想找出第 4 小的元素,并让它安放在原数组下标为 4 的位置
    // 操作区间左闭右开:a+1 到 a+1+n,目标位置是指针 a+4
    nth_element(a + 1, a + 4, a + 1 + n);

    cout << "第 4 小的数是: " << a[4] << '\n'; // 必然输出 4

    cout << "此时的数组状态: ";
    for (int i = 1; i <= n; i++) {
        cout << a[i] << (i == n ? "" : " ");
    }
    cout << '\n';
    // 可能输出如:3 2 1 4 8 7 9 6 5 (4 的左右两侧内部依然无序)
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
六、核心算法横向对比
| 比较维度 | 归并排序 (Merge Sort) | 快速排序 (Quick Sort) |
|---|---|---|
| 分治哲学 | 先破后立(无脑切分,精细合并) | 步步为营(精细划分,无脑合并) |
| 时间复杂度 | 绝对稳定的 |
平均 |
| 空间复杂度 | 原地交换;递归栈平均 |
|
| 稳定性 | 稳定(相等的数字相对位置不改变) | 不稳定(相等的数字在交换时可能被打乱) |
| OI 核心应用 | 求逆序对 | 平均 |
| 考场易错点 | 数组边界,while 扫尾容易忘 |
基准点选择不当导致退化 TLE |