一、暴力枚举的痛点:最优解为何难以直接构造?
在信奥赛题中,有一大类问题被冠以“求最大值的最小值”或“求满足条件的最大值”。初学者拿到题目,第一反应往往是尝试直接“构造”出那个最优解:
- “我要怎样切木头,才能刚好凑出最长的长度?”
- “我要在哪些位置把数组切开,才能让每一段的和最均匀?”
这种思路往往会迅速撞墙。因为状态空间极其庞大,贪心不知道往哪个方向走,动态规划状态维度过高,直接枚举答案更是如同大海捞针。
解决此类问题的降维打击思路,叫做“把最优化问题转化为判定性问题”。
与其直接苦思冥想“最优的数值是多少”,不如把问题退一步:“如果我直接给你一个指定的数值
- 问:“能切出
根长度为 的木头吗?”——只需每根木料除以 累加一下,答案显而易见。 - 问:“能不能把数组分成最多
段,且每段的和不超过 ?”——从左往右贪心扫一遍,装不下就切一刀,立刻就能出结果。
直接算最优值可能毫无头绪,但验证一个具体数值的合法性,往往只需极低复杂度的简单扫描。二分答案的核心魔法,正是利用这道验证门槛,在一串排好序的可能值中,用对半砍的效率揪出那个临界值。
二、二分答案的灵魂:单调性与“首真末真”模型
并不是任何题目写个 check() 函数就能二分。二分答案能成立的关键,是解空间关于合法性的单调性。
如果你的判定结果随着测试数值的变化呈现出“真、假、真、假”反复横跳(例如判断
在实际算法模型中,判定结果的单调性纯粹地分为两类互逆形态:
1. 形态 A:末真模型(越小越容易满足)
- 物理情境:资源充足度问题(如木材加工、做题时间)。指标定得越低,越容易达标;指标定得越高,限制越严苛。
- 真假排列:
[真, 真, 真, ..., 真, 假, 假, 假] - 目标:在所有满足条件的“真”中,寻找数值最大的那一个,即最后一个真(末真)。
2. 形态 B:首真模型(越大越容易满足)
- 物理情境:容量/代价承载问题(如分段容量、搬运载重)。容量给得越小越容易爆仓(假);容量给得越宽裕越能轻松装下(真)。
- 真假排列:
[假, 假, 假, ..., 假, 真, 真, 真] - 目标:在所有满足条件的“真”中,寻找代价最小的那一个,即第一个真(首真)。
我们可以把这两套截然相反的演化规律直观地放在一起对比:
以木材加工
反过来,考察非负数组
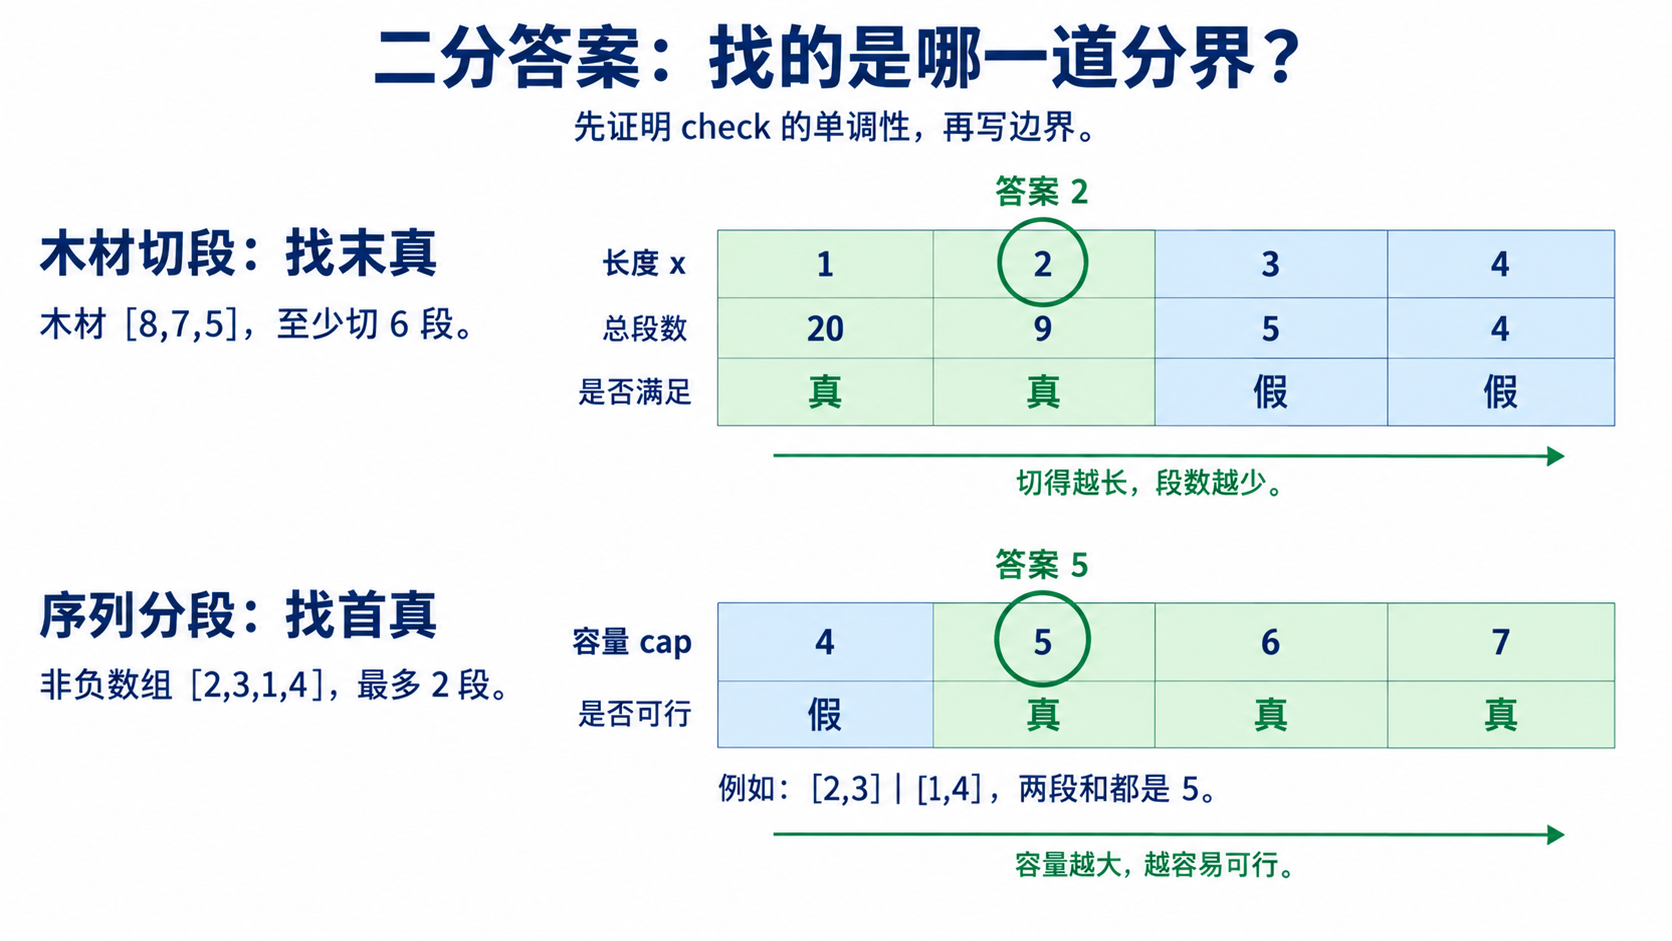
弄清所求是“首真”还是“末真”,是编写二分程序前最关键的第一步。这一步定反了,后面的指针更新与中点计算必将彻底错位。
三、指针与中点计算的法则:彻底消灭死循环
很多同学在考场上写二分,思路全对,代码交上去却 TLE 爆零——原因无他,区间死锁导致的死循环。
我们统一使用闭区间
两套模型的指针更新法则与中点取整方式有着严格的数学绑定,绝不能混用。
1. 寻找“首真”:左下取整,右界紧贴
- 逻辑推导:
- 如果
check(mid)为真,说明本身是一个合法解,但左侧可能还有更小的值满足要求。因此答案可能是 ,也可能在 的左侧。我们不能把 扔掉,更新为: r = mid;。 - 如果
check(mid)为假,说明以及它左边所有更苛刻的取值统统不可行。答案必然严格在右侧,更新为: l = mid + 1;。
- 如果
- 中点公式:
- 防死锁推导:当区间只剩两个数(如
)时,由于向下取整, 。若为真, r = 2,区间瞬间变为,循环正常退出;若为假, l = 3,区间同样变为。区间绝不原地踏步。
2. 寻找“末真”:右上取整,左界紧贴
- 逻辑推导:
- 如果
check(mid)为真,说明已经达标,但我们还想试探右侧有没有更大的可行解。 必须保留在候选池内,更新为: l = mid;。 - 如果
check(mid)为假,说明已经超标不可行,其右侧更大的值更加不可行。更新为: r = mid - 1;。
- 如果
- 中点公式:
- 防死锁推导(极其重要):当区间只剩两个数(如
)时,如果依旧用向下取整,算出的 将是 。假设此时 为真,执行 l = mid,区间依然是!计算机将在原地无限空转,直接 TLE! 而加上分子上的 + 1后,除以实现了向上取整, 。若为真, l = 3,区间收缩为;若为假, r = 2,区间收缩为。死锁被瞬间粉碎。
四、完整实战模型一:木材加工(极大化可行解,末真模型)
1. 物理模型与避坑推导
有
判定函数设计:
给定待试探长度
⚠️ 新手常见致命陷阱: 有同学偷懒写出
sum / len >= k(把所有木料长度加在一起再除以)。 比如两根长为 的木头,想切长度为 的木条。实际上每根木头切 连一段都切不出,总段数是 ;但如果你算总长度 ,这相当于偷偷在考场上把两根废料粘了起来!必须对每根木头分别整除。
2. 边界设计
- 下界
:若连长度为 都切不出 段,答案为 。将 初始化为 充当保底安全哨兵。 - 上界
:单段木条的最长极限不可能超过最长的那根原木。 - 安全性:若全为
,初始 ,循环不进直接输出 ;若存在正数,向上取整的 至少为 ,永远不会出现模零或除零运行时错误(SIGFPE)。
3. 输入输出协议与数据范围
- 输入:第一行包含两个整数
。第二行包含 个整数,表示各根木料长度 。 - 数据范围:
, , 。 - 输出:输出一个整数,表示木条的最大长度;若无法切出至少
段,则输出 。
4. 紧凑竞赛标程实现
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=200005;

int n,k;
int a[N];

// 判定函数:以 len 为长度,能否切出至少 k 段
bool check(int len){
	int cnt=0;
	for(int i=1;i<=n;i++){
		cnt+=a[i]/len;
		// 剪枝:一旦段数达标提前返回,防止 cnt 溢出并加速判定
		if(cnt>=k) return true;
	}
	return cnt>=k;
}

void solve(){
	cin>>n>>k;
	int l=0,r=0;
	for(int i=1;i<=n;i++){
		cin>>a[i];
		r=max(r,a[i]);
	}

	// 末真模型:向上取整计算 mid,向右试探边界
	while(l<r){
		int mid=l+(r-l+1)/2;
		if(check(mid)){
			l=mid;     // mid 可行,保留并向右冲刺
		}else{
			r=mid-1;   // mid 不行,左移收缩
		}
	}
	cout<<l<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
5. 算法跟踪与手推验证
以
。 check(4):(假)。执行 。区间收缩为 。 。 check(2):(真)。执行 。区间收缩为 。 。 check(3):(假)。执行 。区间收缩为 。 - 退出循环,输出
。
时空复杂度:每次 check 耗时
五、完整实战模型二:序列分段(极小化最大值,首真模型)
1. 物理模型与贪心本质
给定一个长度为
判定函数设计:
给定单段最大允许容量
- 如果单个元素
,说明无论如何分段,哪怕该元素独立成段也会爆仓,直接判定非法。 - 只要
,就毫不犹豫地将 塞进当前段(贪心塞满)。 - 一旦塞不下(
),被迫在 前面切上一刀,段数计数器 cnt++,并将重置为 。 - 扫描完毕后,检查所用段数是否满足
。
💡 深度思考:这里的贪心策略为什么是绝对严谨的? 很多同学心里发虚:“凭什么塞得下就一定要塞?留给下一段会不会更优?” 反证法证明无后效性:假设存在某种最优解,在当前段还能装下
时主动切了一刀,把 留给了下一段。那么我们将这一刀向后推迟到贪心的位置,使得当前段覆盖更长的前缀。由于所有元素均为非负数,第二段乃至后续各段的负担只会减轻或保持不变,绝不会变重! 因此,“贪心尽量往右扩”所消耗的总段数,是承载整个前缀所能达到的理论最小段数。如果贪心策略都耗费了超过 段,任何提前切开的策略都绝不可能达标。
⚠️ 前置前提:为什么非负性不可撼动? 如果数组中含有负数,“多加一个数”可能导致和减少。可能前面塞不下,但连着后面的负数一起看反而能塞下!贪心单调性瞬间崩塌,本题算法不再成立。这也说明:模型前置条件的物理意义不是摆设,而是算法正确性的基石。
2. “最多
题目要求划分成“最多
3. 边界设计
- 下界
:哪怕分成 段,每一段只有一个数,最大段和也至少是数组中的最大单体元素。 - 上界
:若整列只用 段全部打包,段和就是总和,此时必然满足段数 。
4. 输入输出协议与数据范围
- 输入:第一行包含两个整数
。第二行包含 个非负整数 。 - 数据范围:
, 。 - 输出:输出一个整数,表示划分出的最大子段和的最小值。
5. 紧凑竞赛标程实现
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=200005;

int n,m;
int a[N];

// 判定函数:单段容量上限为 cap 时,能否在 m 段内装完
bool check(int cap){
	int cnt=1,sum=0;
	for(int i=1;i<=n;i++){
		if(a[i]>cap) return false; // 单个元素已超标,绝对不可行

		if(sum+a[i]>cap){
			cnt++;       // 逼迫新开一段
			sum=a[i];    // 新段从 a[i] 开始累加
			if(cnt>m) return false; // 段数超标,提前剪枝
		}else{
			sum+=a[i];   // 贪心装入当前段
		}
	}
	return true;
}

void solve(){
	cin>>n>>m;
	int l=0,r=0;
	for(int i=1;i<=n;i++){
		cin>>a[i];
		l=max(l,a[i]); // 下界:最大单个元素
		r+=a[i];       // 上界:所有元素总和
	}

	// 首真模型:向下取整计算 mid,向左挤压边界
	while(l<r){
		int mid=l+(r-l)/2;
		if(check(mid)){
			r=mid;     // mid 可行,答案可能是 mid 或更小
		}else{
			l=mid+1;   // mid 装不下,答案必须更大
		}
	}
	cout<<l<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
6. 算法跟踪与手推验证
考察测试数据
- 初始下界
,上界 。
。 check(7):,用 段 (真)。更新 ,区间收缩至 。 。 check(5):,用 段 (真)。更新 ,区间收缩至 。 。 check(4):,需 段 (假)。更新 ,区间收缩至 。 - 退出循环,输出
。
时空复杂度:元素总和上界为
六、间距极值模型:最大化最小间距
1. 物理问题与贪心判定逻辑
在信奥赛题中,“最大化最小值”是出现频率极高的经典题型。典型场景如:一条平直的数轴上有
单调性与模型归属:
设待检验的相邻间距下限为
- 若
极小(如 ),点与点完全不排斥,即便坐标重合也能轻松挑出 个点(判定为真)。 - 随着
逐渐增大,每个被选点周围都需要划出更宽的“隔离带”,数轴上能容纳的点数单调递减;一旦 超出两极跨度极限,连 个点都凑不齐(判定为假)。 - 解空间关于可行性的排布呈现出
[真, 真, ..., 真, 假, 假]的形态。这是标准的末真模型,目标是寻找最后一个能成功选出个点的间距 。
判定函数贪心推导(交换论证):
首先将所有坐标按升序排序:
- 第一个点必选
:假设存在某种合法方案首个选取的点是 ( ),若我们将其平移替换为最左侧的 ,由于 ,它与后续所有选点的距离只会拉大而绝不会缩短,合法性丝毫不受损。因此首点选 具有绝对无后效性。 - 后续点贪心紧贴:确定前一个选点
后,向右线性扫描,找到第一个满足 的点立刻将其选下,并更新 。选得越紧凑,给后方未选区域留下的空间就越开阔。 - 扫描结束后,检查选出的总点数是否满足
。
2. 手算推演与单调性分析
给定坐标集合
- 测试
: 首选 ; 下一目标需 ,命中 ,选入; 下一目标需 ,命中 ,选入; 成功选出 3 个点( ),满足 , check(3)为真。 - 测试
: 首选 ; 下一目标需 ,跳过 ,命中 ,选入; 下一目标需 ,后方仅剩 ,无点可选; 总共仅选出 2 个点,无法达标, check(4)为假。 临界跃迁发生于与 之间,最大最小间距的理论最优值确认为 。
3. 输入输出协议与数据范围
- 输入:第一行包含两个整数
。第二行包含 个整数,表示各点坐标 。 - 数据范围:
, 。 - 输出:输出一个整数,表示相邻两点之间最小距离的最大可能值。
- 对应样例:
输入:输出:
5 3 1 8 4 9 23
4. 紧凑竞赛标程实现
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;

int n,c;
int x[N];

// 判定函数:间距设为 d 时,能否在数轴上选出至少 c 个点
bool check(int d){
	int cnt=1,last=x[1];
	for(int i=2;i<=n;i++){
		if(x[i]-last>=d){
			cnt++;
			last=x[i];
			if(cnt>=c) return true; // 贪心达标提前剪枝
		}
	}
	return cnt>=c;
}

void solve(){
	cin>>n>>c;
	for(int i=1;i<=n;i++) cin>>x[i];
	sort(x+1,x+n+1);

	// 末真模型:左闭右闭,向上取整防止死锁
	// 注意:坐标可能重复,最小合法间距可能是 0,下界必须为 0
	int l=0,r=x[n]-x[1];
	while(l<r){
		int mid=l+(r-l+1)/2;
		if(check(mid)){
			l=mid;     // 间距可行,保留并向右试探更大值
		}else{
			r=mid-1;   // 间距过大装不下,左移收紧
		}
	}
	cout<<l<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
七、浮点二分:固定迭代轮数与精度保护(选学)
1. 浮点比较的陷阱
在求解几何交点、实数方程根或实数极值问题时,解空间转移为连续实数域。不少同学习惯写出如下循环:
while(r - l > 1e-7){
	double mid = (l + r) / 2.0;
	if(check(mid)) l = mid;
	else r = mid;
}
这段代码在某些极端数据下可能引发 TLE。原因在于 double 类型的精度存在物理极限。当搜索区间较大时,相邻可表示浮点数的物理间隔可能已经大于你设定的 1e-7。此时 mid 会因为四舍五入直接等于 l 或 r,导致 1e-7 之上,循环死锁。
2. 固定轮数的策略
一种实用且能有效避免 eps 死循环的替代方案是:采用固定迭代轮数(For Loop)。
每次执行 mid = (l + r) / 2.0,区间长度都会折半。迭代 60 到 100 轮后,区间跨度通常会缩小到极小级别,这在常规数据范围内已经能够逼平 double 的有效精度极限。
// 浮点二分范式:固定迭代 60~100 轮
double l = 0.0, r = 1e9;
for(int iter = 0; iter < 80; iter++){
	double mid = l + (r - l) / 2.0;
	if(check(mid)){
		l = mid;
	}else{
		r = mid;
	}
}
cout << fixed << setprecision(6) << l << '\n';
注意:虽然固定轮数能解决死锁问题,但最终结果的真实精度仍然受限于 double 自身的物理精度限制以及 check() 内部运算的误差累积。遇到高精度要求题目时,核心仍是保证 check 过程不出现大数吃小数。
八、最优解的方案还原:从可行性判定到具体构造(选学)
💡 选学提示:本节探讨多约束条件下的反向贪心构造,先修要求为充分理解序列分段模型的贪心扫描机制。
1. 构造思路:将最优值反哺为硬约束
部分赛题不仅要求计算“最大段和的最小值”,还要求“输出每一段的具体划分切点”。
二分输出的最优值
2. 前段极小化与段数补齐
在序列分段中输出具体方案,往往伴随两个严苛附加规则:
- 前段和最小化(字典序偏好):若存在多种切分方案,要求使前面的子段和尽可能小。
- 破局核心:从右往左倒序贪心! 让靠后的段尽量吃满
的容量,自然而然将较小的负担留给前方。
- 破局核心:从右往左倒序贪心! 让靠后的段尽量吃满
- 恰好分成
段: 处于宽松状态时,贪心切分可能只用了 段。 - 破局核心:段数强制保底! 倒序扫描到位置
时,若未分配的元素个数已经等于后续必须切出的剩余段数(即 ),则后面的每个元素都必须独立成段,强制下刀切开。
- 破局核心:段数强制保底! 倒序扫描到位置
3. 序列分段方案还原代码
下述代码接在求得序列分段极值
// 方案还原:接在求出最优值 ans 之后运行
bool cut[N]; // cut[i] 为 true 表示在 a[i] 后面切上一刀

void reconstruct(int ans){
	memset(cut, 0, sizeof(cut));
	int cur = 0, rem_seg = m; // rem_seg 包含当前正在填充的段,以及左侧待分的段

	// 从后往前倒序贪心装入
	for(int i = n; i >= 1; i--){
		// 若前方元素数恰好等于还需切出的段数,必须每步独立成段
		if(i == rem_seg - 1){
			cut[i] = true;
			rem_seg--;
			cur = 0;
			continue;
		}

		if(cur + a[i] > ans){
			cut[i] = true;   // 逼迫在 a[i] 与 a[i+1] 之间切开
			rem_seg--;
			cur = a[i];
		}else{
			cur += a[i];
		}
	}

	for(int i = 1; i <= n; i++){
		cout << a[i] << (i == n ? "" : " ");
		if(cut[i]) cout << "/ ";
	}
	cout << '\n';
}
九、边界保护与无解判定
1. 哨兵边界法
当题目增加约束“若无合法方案输出 -1”时,由于闭区间二分始终会收敛至单点
哨兵设防:
- 末真模型(求最大合法值):将搜索下界设为合法值域左侧的哨兵(例如
或 )。若值域内所有候选解经 check判定均为假,指针将一路右缩至哨兵位置不动。循环结束后,若仍等于初始哨兵,即可直接输出无解标记 -1。 - 首真模型(求最小合法值):将搜索上界设为合法值域右侧的哨兵(例如
)。若所有值均不可行,左指针将一路向右推进至哨兵位置。判断 即可判定无解。
如果
2. 终态复查法
有时候把 check(mid) 内部发生数组越界。此时最稳健的做法是终态复查法:二分严格在合法区间运行;结束后,对最终收敛点进行强制二次验证:
// 二分得出候选结果 l 之后:
if(!check(l)){
	cout << -1 << '\n';
}else{
	cout << l << '\n';
}
终态复查不侵入二分内部逻辑,既保护了 check() 输入值域的安全,又解决了无解拦截问题。
十、考场调试心法:边界验证与对拍抓漏
考场上写二分答案,如何快速验证自己的程序万无一失?千万不要一上来就拿百万级随机数据盲测。
1. 灵魂反问:解的临界点两侧是否严丝合缝?
二分输出的结果
- 若为末真问题(求最大):不仅要肉眼验证
为真,更必须代入 验证其绝对为假! - 若为首真问题(求最小):不仅要肉眼验证
为真,更必须代入 验证其绝对为假!
2. 极端小数据边界自测清单
的极限场景:木材只有一根;数组只有 个元素。 - 目标阈值处于极值:
或 远大于总木料和;序列分段中 (答案必须等于全数组和)以及 (答案必须等于单元素最大值)。 - 全零元测试:所有木材长度为
(输出 );数组所有元素为 (输出 )。 - 单一大数主导:例如数组中某一个数极大(如
),其他数极小。检查代码是否在下界初始化时正确纳入了单体极大值。
3. 极速对拍思路
写一份绝对不会错的暴力代码作为对拍标尺:
- 木材加工暴力:从
到 循环枚举长度,找到最后一个可行的长度。 - 序列分段暴力:在
极小(如 )时,利用位运算枚举所有切分位置组合,计算各组段和的最大值并取全局最小值。 运行对拍脚本,若对拍在某组小数据挂掉,打印出每一步的 与 check(mid)的布尔值,死循环或边界偏移问题一秒即可定位。
十一、阶梯式实战迁移练习
掌握了“判定单调性”与“首真末真模板”,我们来看如何将这套思想迁移至更广阔的赛题中:
1. 练习 1:伐木工人(木料截断保留问题)
- 题意:有
棵树,高度分别为 。伐木机将锯片升到高度 ,所有高度大于 的树木高出部分都会被锯下,高度不超过 的树木则不受影响。为了满足生态指标,总共需要收集至少 米长的木材。求在满足要求的前提下,锯片能抬升的最大整数高度 。若总高度不足 ,则输出 。 - 样例:树高
,需求 ,答案输出 (锯下高度为 )。 - 数据范围:
, , 。 - 破题引导:
- 锯片高度
定得越高,锯下来的木材总和越少。 的物理意义是: 。 - 真假排列为
[真, ..., 真, 假, ..., 假],典型的末真模型。注意计算斩获木材总和时用long long累加,一旦及时剪枝防爆。
- 锯片高度
2. 练习 2:运载货物(按序装箱天数限制)
- 题意:有
件货物需要依序运送,重量分别为 。货物不可拆卸,必须严格按照给定的先后顺序装运。运输团队最多只能使用 天时间将所有货物运完,每天只能运送连续的一批货物。求货车每天的运载重量上限最小可以是多少。 - 样例:货物重量
,天数限制 ,答案输出 。 - 数据范围:
, 。 - 破题引导:
- 将“天数”直接映射为“分段数
”,将“每日载重上限”直接映射为“单段容量上限 ”。 - 判定逻辑与本讲模型二完全一致。做这道题的意义在于训练自己在赛场上穿透题面包装、迅速提炼出底层数学模型的能力。
- 将“天数”直接映射为“分段数
3. 练习 3:基站覆盖(最大跨度最小化)
- 题意:数轴上有
个居民点,坐标已经按升序排好为 。现在计划建立最多 个服务网格(每个网格覆盖一段连续的居民点)。定义一个网格的成本为该网格内“最远居民点坐标减最近居民点坐标”。请设计方案,使得所有网格中成本的最大值尽可能小。 - 样例:坐标
,网格数 ,输出 (划分为 与 ,各自跨度均为 )。 - 数据范围:
, 。 - 破题引导:
- 答案猜的是:单个网格允许的最大跨度
。 - 贪心判定策略:固定当前网格的左端点为段内第一个居民点
,只要后续点满足 ,就不断往里吸纳;一旦超出限制,必须新开网格,重置起点。 - 思考它与模型二的区别:这里限制的是区间两端之差而非区间元素之和,但贪心覆盖前缀的无后效性完全相同。此为首真模型。
- 答案猜的是:单个网格允许的最大跨度