一、暴力匹配的痛点:主串的无效回溯
场景:在主串
暴力解法 (
物理劣势:主串指针
二、KMP 的核心思想:主串永不回头
KMP 算法的唯一目标:主串指针
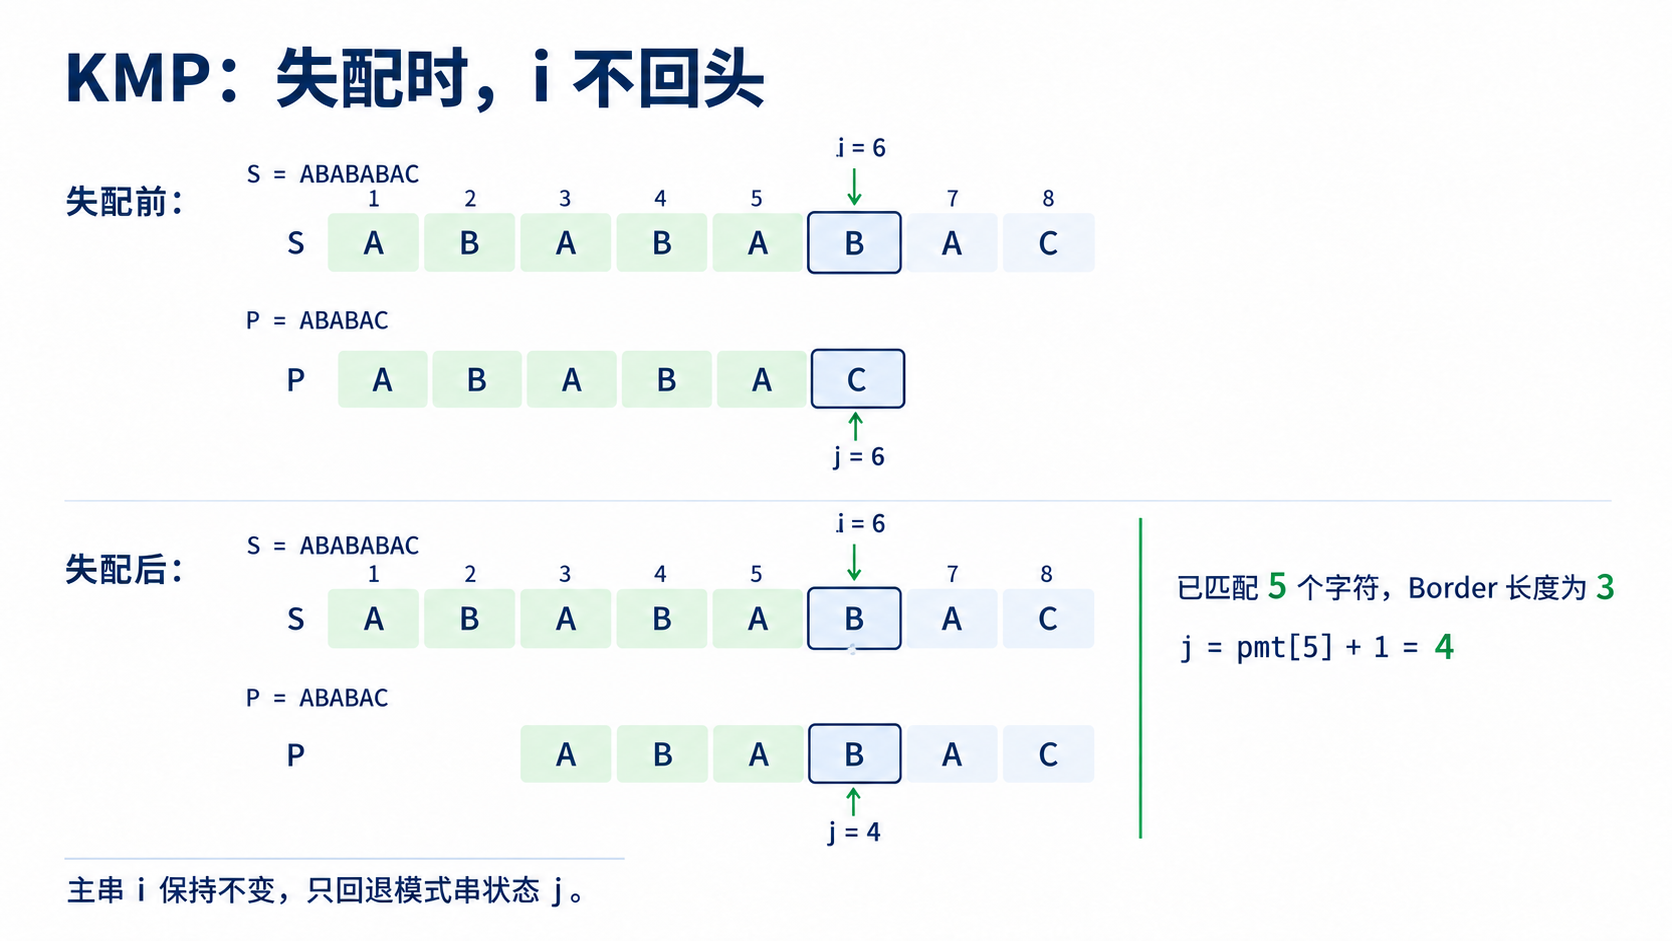
1. 什么是“最合适的位置”?(Border 理论)
假设我们在模式串的第
为了不让
直观例子:模式串 A B A B A C
假设我们在考察第 6 个字符 C 时失配(即 A B A B A 是完全匹配成功的。
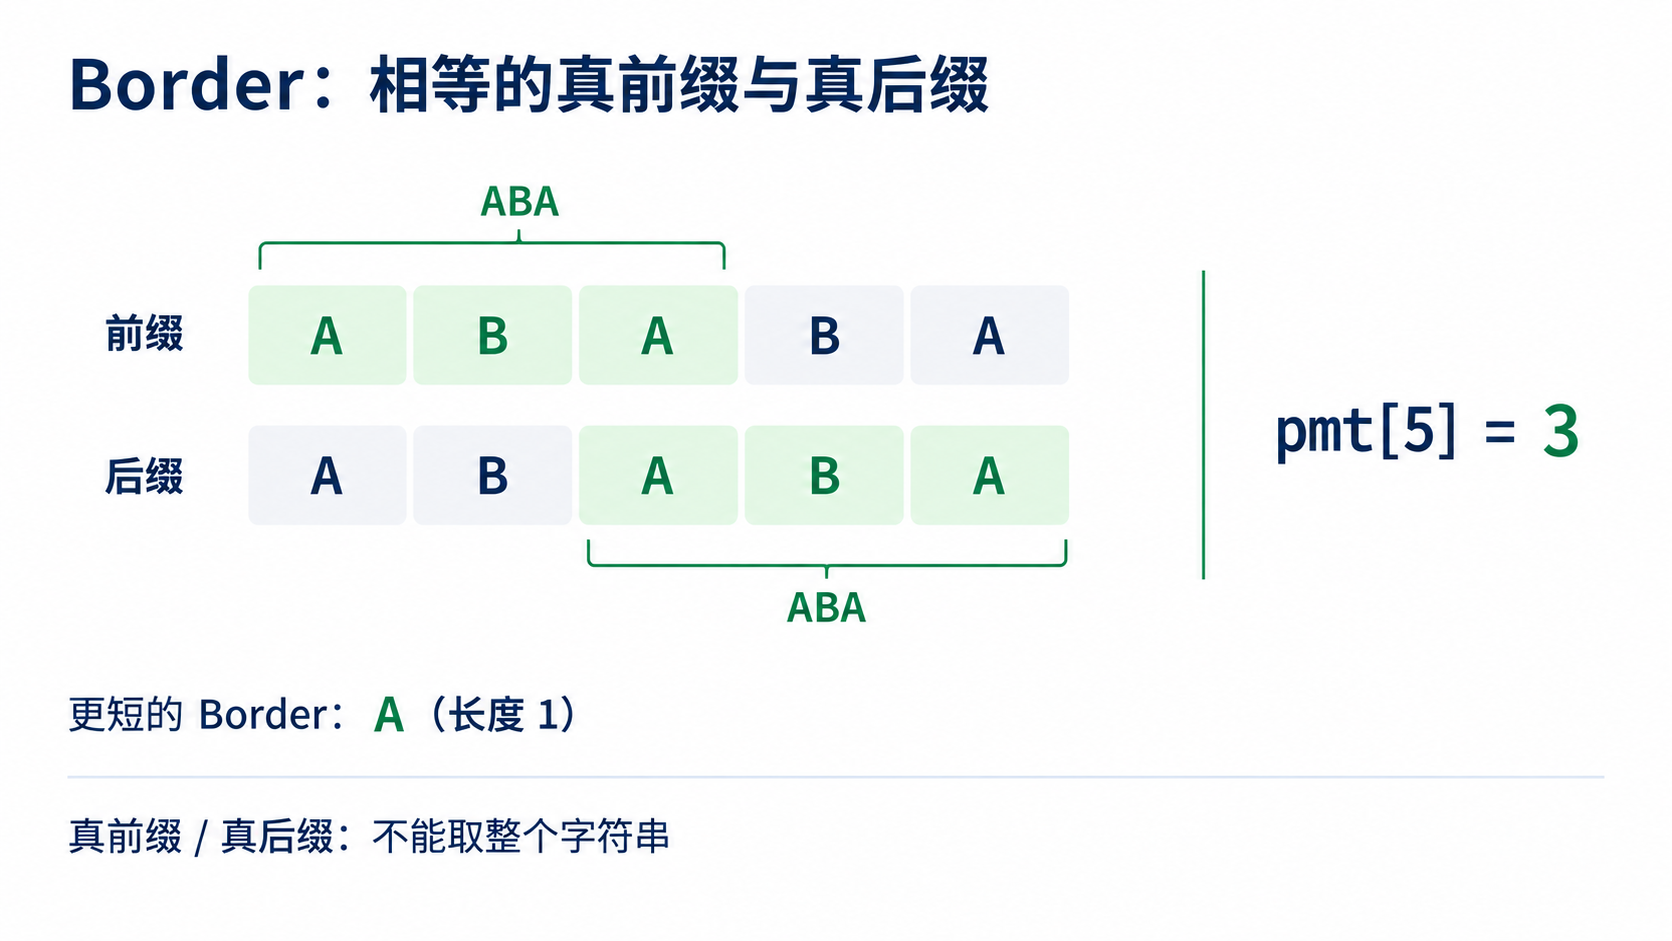
观察已成功的 A B A B A:
-
它的真前缀有:
A,AB,ABA,ABAB -
它的真后缀有:
A,BA,ABA,BABA公共的且最长的前后缀(Border)是
ABA,长度为 3。
降维打击:因为后缀 ABA 刚刚和主串匹配成功过,所以前缀 ABA 绝对也能和主串对得上!我们直接让模式串整体向右滑动,让指针 ABA 的下一个位置(也就是位置
三、灵魂数组:PMT (Partial Match Table)
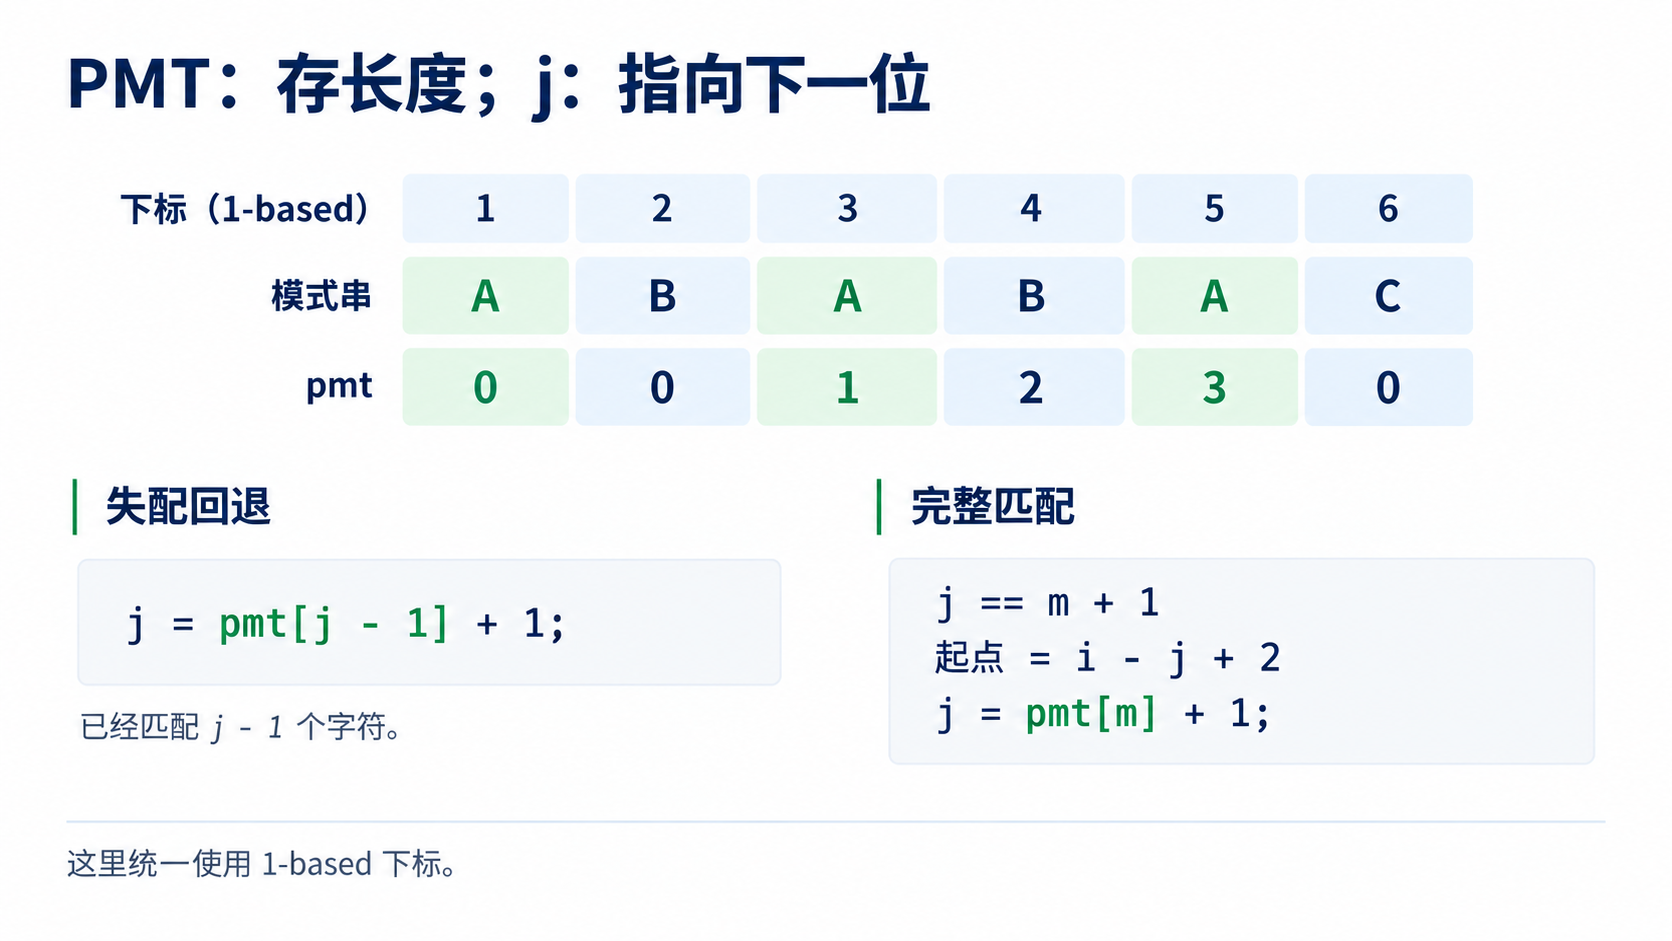
我们需要一个数组 pmt[i],它的物理意义是:子串
1. 代码逻辑拆解:把
在这套代码模板中,
1. 失配时的智能回退
while (j>1 && s[i] != s[j]) j = pmt[j-1] + 1;
- 物理推导:当前考核的字符
s[j]和主串s[i]对不上! - 此时我们已经成功匹配了
个字符。我们去查表 pmt[j-1],得知这段成功序列的最长 Border 长度。 - 既然 Border 长度是
pmt[j-1],说明前pmt[j-1]个字符是不需要再比对的。下一个该去比对的字符位置,自然就是pmt[j-1] + 1。
2. 匹配成功的推进与记录
if (s[i] == s[j]) j++;
pmt[i] = j - 1;
- 物理推导:如果考核通过(字符相等),进度往前推一格(
j++),准备去考察下一个。 - 当前状态
的最长 Border 是多长?既然 已经指向了“下一个”,那当前成功的总长度显然就是 。
3. 终局条件判断与输出
if (j == m + 1) {
    cout << i - j + 2 << '\n';
    j = pmt[j-1] + 1;
}
- 物理推导:模式串总长是
。如果 一路披荆斩棘走到了 ,说明第 1 到第 个字符全部考核通过,完全匹配成功! - 坐标计算:当前主串走到
,总共匹配了 个字符(此时 ,所以匹配长度就是 )。起始坐标本应是 ,去括号化简后就是极其优雅的 i - j + 2。
四、核心模板代码实现 (洛谷 P3375)
我们使用 1-based 索引,在读入字符串后拼接一个空格 ' ',让代码下标与前面的推导直接对应。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1000005;

int pmt[N];

// 核心模板 1:构建 PMT 数组(模式串自己匹配自己)
void get_pmt(const string& s) {
	int n=s.length()-1;
	// j 代表下一个待匹配的位置,因为前 0 个算成功,所以下一个查第 1 个
	for(int i=2,j=1;i<=n;i++){
		// 失配:查询已匹配部分 (j-1) 的 Border,并 +1 得到下一个考核位置
		while(j>1 && s[i]!=s[j]) j=pmt[j-1]+1;

		// 匹配成功:考核进度推进
		if(s[i]==s[j]) j++;

		// 记录当前状态的最长 Border 长度
		pmt[i]=j-1;
	}
}

// 核心模板 2:KMP 匹配过程
void kmp(const string& s, const string& p) {
	int n=s.length()-1, m=p.length()-1;
	for(int i=1,j=1;i<=n;i++){
		// 失配回退逻辑与 get_pmt 完全一致
		while(j>1 && s[i]!=p[j]) j=pmt[j-1]+1;

		if(s[i]==p[j]) j++;

		// 走到 m+1,说明 1~m 全部匹配成功
		if(j==m+1){
			cout<<i-j+2<<'\n'; // 输出起始位置
			j=pmt[j-1]+1;      // 强行回退,继续寻找下一次出现的位置
		}
	}
}

void solve(){
	string s,p;
	cin>>s>>p;

	// 强制转化为 1-based 索引
	s=" "+s;
	p=" "+p;

	get_pmt(p);
	kmp(s,p);

	// 输出 PMT 数组
	int m=p.length()-1;
	for(int i=1;i<=m;i++){
		cout<<pmt[i]<<(i==m?"":" ");
	}
	cout<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
五、KMP 的进阶降维:字符串周期律
KMP 的 PMT 数组不仅仅用于匹配,它揭示了字符串内部的循环周期规律,这是提高组和省选的常考点。
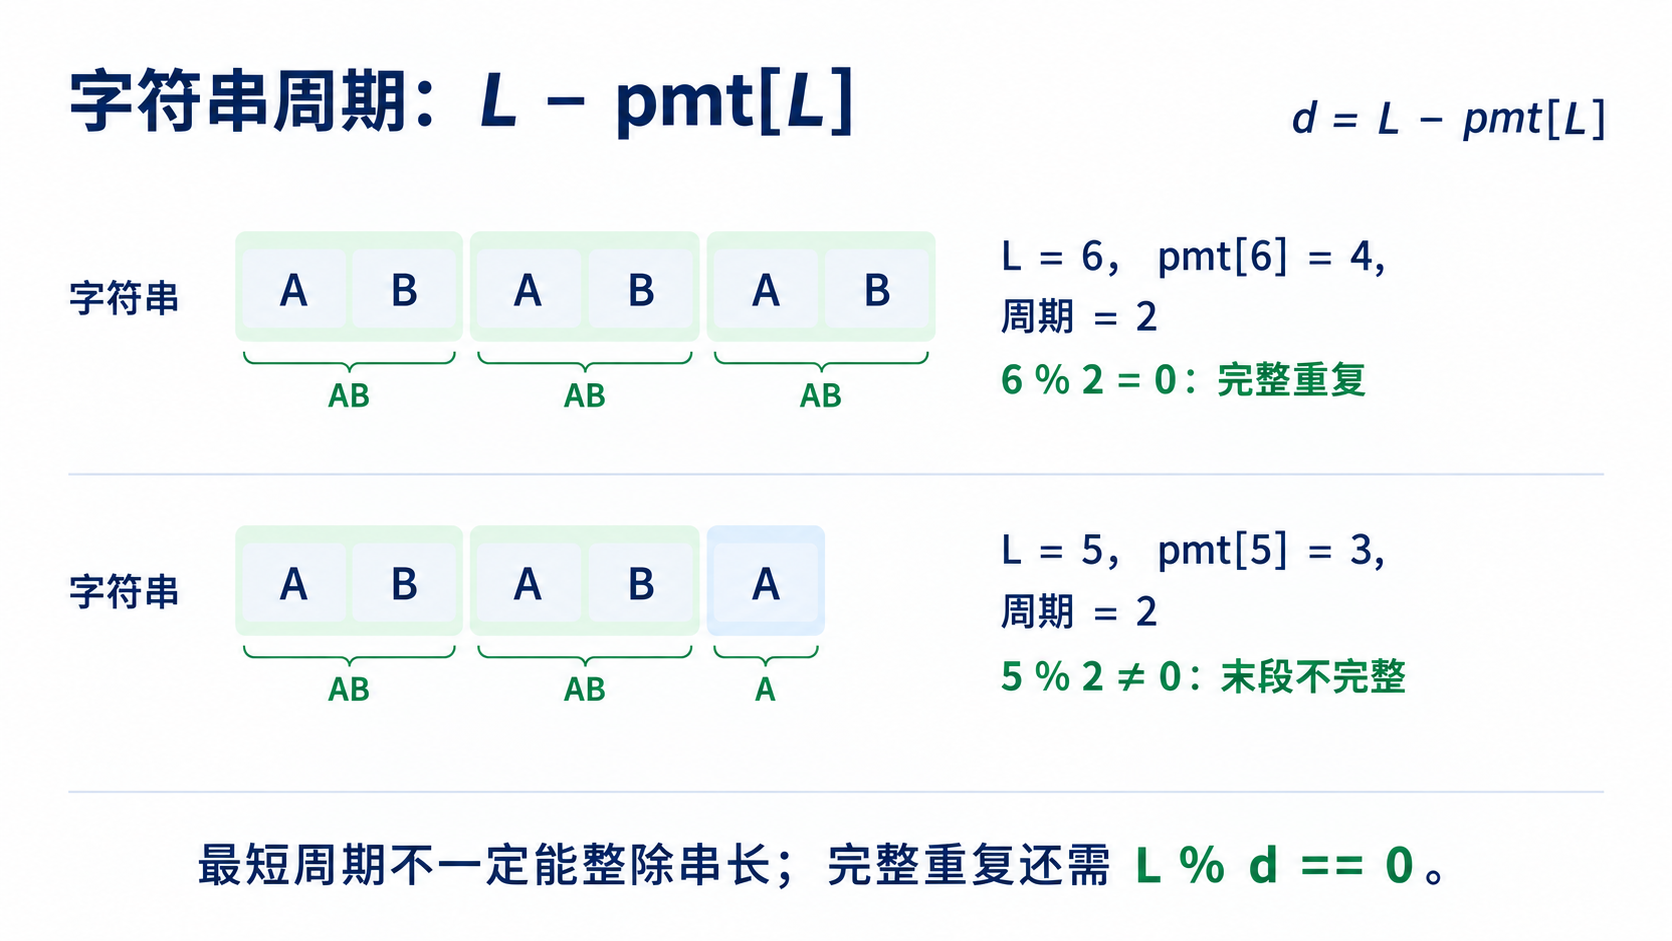
核心定理(必须死记硬背):
对于一个长度为
- 如果
,则说明该字符串可以被这个最小循环节完美整除并完全覆盖。 - 如果不能整除,说明该字符串是由循环节重复若干次后,还多出了一截“不完整的循环节”。
六、进阶模型:Border 链、前缀统计与 Border 树
在掌握了 KMP 的基础跳跃和周期律之后,我们来看看 Border 理论能怎样解决更复杂的字符串统计问题。
1. 剥洋葱:枚举全部 Border 链
pmt[i] 记录的是前缀
物理推导:既然 Border 是一段完全相等的前后缀,那么“Border 的 Border”,必然也是原串的 Border。这就像剥洋葱一样,最长 Border 包含次长 Border。
手算小例子:设前缀 S = "a b a b a b a"(长度为 7)
- 它的最长 Border 是
a b a b a(长度为 5),即pmt[7] = 5。 - 要求次长 Border,其实就是求
a b a b a的最长 Border,即pmt[5] = 3(a b a)。 - 依此类推,再求
a b a的最长 Border,即pmt[3] = 1(a)。
所以,我们只需要顺藤摸瓜,不断执行 j = pmt[j],就能按长度从大到小枚举出前缀
2.
问题场景:给定一个长度为
暴力去数的话必然超时。利用 Border 链,我们可以做到
物理推导:
如果前缀 pmt[i] 保存了最长的 Border,所以每当出现了一个长度为 pmt[i] 也在这里出现了一次。
我们只需要:
- 给每个前缀自己算作出现 1 次(打底)。
- 从后往前遍历,把长前缀的“出现次数”接力累加给它的最长 Border。
// 假设 pmt 数组已求出,cnt 数组用于统计前缀出现的总次数
for(int i=1; i<=n; i++) cnt[i] = 1; // 每个前缀本身算一次

// 从后往前倒推,传递出现次数
for(int i=n; i>=1; i--) {
    if(pmt[i] > 0) {
        cnt[pmt[i]] += cnt[i];
    }
}
💡 为什么必须倒序遍历? 因为长前缀的 Border 一定比它自身短。从大到小遍历,才能保证长前缀把次数完全累加给次长前缀,次长前缀再带着这些次数继续往更短的前缀传递。
下面给出完整的可验证代码:
// 输入一个字符串 S,统计其每个前缀在 S 中出现的总次数
// 输入格式:一行一个由小写字母组成的字符串 S (长度 <= 10^5)
// 输出格式:输出 N 行,第 i 行表示长度为 i 的前缀出现的次数
// 样例输入:ababab
// 样例输出:
// 3
// 3
// 2
// 2
// 1
// 1

#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=100005;

int pmt[N], cnt[N];

void solve(){
	string s;
	if(!(cin>>s)) return;
	int n=s.length();
	s=" "+s;

	// 1. 求 PMT 数组
	for(int i=2,j=1;i<=n;i++){
		while(j>1 && s[i]!=s[j]) j=pmt[j-1]+1;
		if(s[i]==s[j]) j++;
		pmt[i]=j-1;
	}

	// 2. 初始自身出现 1 次
	for(int i=1;i<=n;i++) cnt[i]=1;

	// 3. 倒序累加次数
	for(int i=n;i>=1;i--){
		if(pmt[i]>0){
			cnt[pmt[i]] += cnt[i];
		}
	}

	// 输出
	for(int i=1;i<=n;i++){
		cout<<cnt[i]<<'\n';
	}
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
3. 选学:终极视角——Border 树 (Fail 树)
如果我们把 pmt[i] 认作 pmt[i] 指向 pmt[i] < i,这必然会形成一棵以 0 为根的树,我们称之为 Border 树(或 Fail 树)。
物理意义的惊人统一:
- 祖先路径:从
pmt[i]开始沿父亲走到根节点 0,经过的节点恰好就是前缀的所有 Border(含长度为 0 的空 Border)。节点 自己不是真 Border。 - 子树大小:我们在上一步用倒序求出来的
cnt[i],在树的视角下,恰好就是以为根的子树的所有节点权值和(每个节点初始自身权值为 1)! - LCA (最近公共祖先):如果想求前缀
和前缀 的“最长公共 Border”,先求节点 和节点 的 LCA;若它恰好等于 或 ,答案应取 pmt[LCA],因为 Border 必须比两个原前缀都短。例如S=aaa、、 ,LCA 是 2,但最长公共 Border 的长度是 1。LCA 的具体写法见《树上路径处理》第二节。
把字符串问题降维转化为树上问题,这是字符串高级算法中极其核心的思维跳跃。掌握了 Border 树,你就拿到了通往省选字符串结构(如 AC 自动机、后缀自动机)的钥匙。
七、渐进式实战练习题单
第一阶段:模板肌肉记忆
- 洛谷 P3375 【模板】KMP字符串匹配
- 训练指引:反复默写上述模板,做到条件反射式地写出
j = pmt[j-1] + 1和i - j + 2。
- 训练指引:反复默写上述模板,做到条件反射式地写出
第二阶段:周期律的降维打击
- 洛谷 P4391 [BOI2009] Radio Transmission
- 训练指引:KMP 周期理论的入门试金石。求最短的覆盖子串,代码核心只需一行:
cout << n - pmt[n] << '\n';。
- 洛谷 P3435 [POI2006] OKR-Periods of Words
- 训练指引:这一题要找每个前缀的最短非零 Border,再用前缀长度减掉它。别对每个前缀都从头沿 Border 链跳到底:遇到
aaaa…会退化成。 - 怎么省掉重复工作? 令
mn[i]表示前缀i的最短非零 Border。若pmt[i]==0,本前缀没有非零 Border;否则先看j=pmt[i]:它自己还有更短的 Border,就直接接上已经算好的mn[j],没有就取j。按i递增算,一次,整段 。
- 训练指引:这一题要找每个前缀的最短非零 Border,再用前缀长度减掉它。别对每个前缀都从头沿 Border 链跳到底:遇到
// 已调用 get_pmt(s),s 为 1-based;mn[N] 初始为 0
long long ans = 0;
for (int i = 1; i <= n; i++) {
    int j = pmt[i];
    if (j) {
        mn[i] = mn[j] ? mn[j] : j;
        ans += i - mn[i];
    }
}
cout << ans << '\n';
第三阶段:综合变种(省选级)
- 洛谷 P2375 [NOI2014] 动物园
- 训练指引:求长度不超过当前字符串一半的公共前后缀数量。需要在求 PMT 的同时,再维护一个指针进行类似 KMP 的自匹配,限制匹配长度
。这是检验 KMP 底层逻辑最顶级的题目。