一、暴力扩展的痛点:为什么每次都要“从零起步”?
场景:给定一个长度为
直觉解法(中心扩展法): 回文串是左右对称的。既然对称,最自然的思路就是枚举“对称中心”,然后双指针向两侧同时伸手比对字符:如果左右字符相等,回文长度就加 2,继续往外扩;一旦遇到字符不同或撞到边界就停下。
但只要一写代码,你马上就会撞上两个令人极其头疼的痛点:
1. 奇偶回文的物理断层
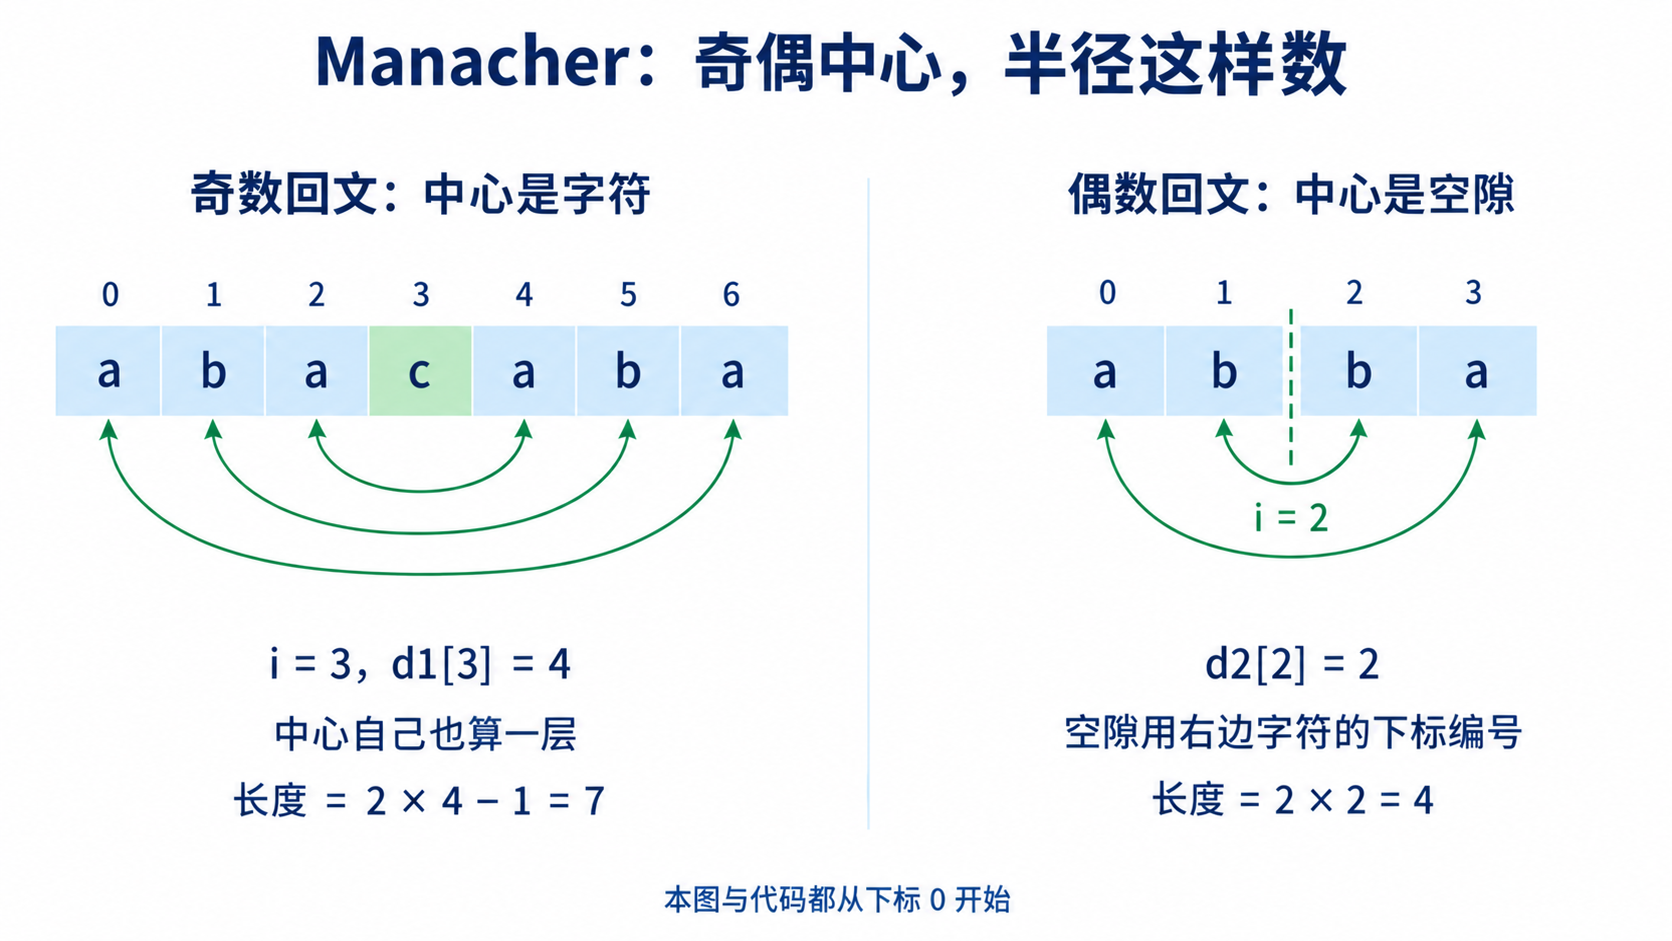
- 观察奇数回文
a b a c a b a:它的对称中心非常明确,正好落在正中间的字符c上。 - 但再看偶数回文
a b b a:它的对称中心在哪里?它根本不在任何一个字符上,而是悬在中间两个b之间的“空隙”里! - 如果你只枚举字符作为中心,所有的偶数长度回文将被全部漏掉。
2. 暴力扩展的时间灾难(
在长串上,中心虽然只有
拿极端串 a a a a a a 来说:每一个位置作为中心都能向外扩很远。在前面的中心辛辛苦苦比对过的字符,换到下一个中心时,暴力算法却彻底失忆,不得不把相同的字符重新比对一遍。最坏情况下总比对次数会迅速退化为
降维设问:回文具有完美的对称性。我们在左边已经探测过的信息,能不能直接“翻个面”借给右边,省去重复比对的无效劳动?
这正是 Manacher 算法的核心灵魂。插入 # 等分隔符也能统一处理奇偶回文;本讲选择直接记录两种半径,沿用原串的 0-based 下标,方便后面用区间坐标查询。
二、物理意义明确:两种回文半径(奇数中心与偶数空隙)
为了让计算机记录下每个中心的能力上限,我们定义两个核心的“灵魂数组”。全文严格采用 0-based 索引,区间
1. 奇数回文的灵魂数组:d1[i]
- 物理意义:以字符
s[i]为中心,向外扩展出的最大奇数回文的半径(中心字符本身算作第 1 层)。 - 底线:单个字符本身就是一个长度为 1 的合法奇回文,因此每个位置的天然半径至少为
。 - 区间与长度推导:
若
d1[i] = k,表示以为中心左右各伸出了 步。 - 覆盖区间:
- 回文长度:
- 覆盖区间:
手推验证:对字符串 a b a c a b a(长度为 7):
| 下标 |
0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| 字符 | a | b | a | c | a | b | a |
d1[i] |
1 | 2 | 1 | 4 | 1 | 2 | 1 |
- 在
处(字符 b):向外扩 1 层得到a b a,半径为,长度为 。 - 在
处(字符 c):向外扩 3 层直接通关整个字符串,半径为,长度为 。
2. 偶数回文的灵魂数组:d2[i]
- 物理意义:以字符
s[i-1]与s[i]之间的空隙为中心,向外最多能成功配对的字符对数。 - 坐标规约:空隙不是字符,怎么用下标存储?我们规定:用空隙右侧字符的下标
来代表该空隙! - 底线:如果左右相邻两个字符根本不相等,配对对数就是
。特别地,字符串最左侧外面没有字符,定义 d2[0] = 0。 - 区间与长度推导:
若
d2[i] = k,表示以空隙为中心成功配对了对字符。 - 覆盖区间:
- 回文长度:
- 覆盖区间:
手推验证:对字符串 a b b a:
- 在空隙
处(即 s[1]='b'与s[2]='b'之间的缝隙):- 第一层:
s[1]与s[2]匹配成功(配对数 1); - 第二层:
s[0]与s[3]匹配成功(配对数 2)。 - 因此
d2[2] = 2,覆盖区间为,回文长度为 。 - 其余位置均无法配对,故
d2数组为[0, 0, 2, 0]。
- 第一层:
三、核心魔法:把已知大回文当作“镜子”
现在我们明确了成绩单的定义。Manacher 算法的威力,就在于它从左向右扫描每个中心时,会随身维护一把“具有庇护能力的巨伞”。
1. 领地守护者:最右回文区间
在算法推进过程中,我们时刻维护一个已经探测到的回文区间
核心心法:
记录的不是当前最长的回文串,而是右端点 伸得最远的回文串! 为什么?因为我们是从左往右扫描的,只有把右边界 推得越远,后面的新中心才越有可能被罩在 内部,从而白借信息。
2. 奇数中心的信息继承与“安全红线”
假设当前我们要计算中心 d1[i]:
场景 A:当前中心
当前中心已经超出了目前所有探明回文的右边界
- 动作:从底线
开始,老老实实执行 while循环向两边逐个字符暴力比对。
场景 B:当前中心
此时
因为 d1[j] 已算好)。大回文
但能直接无脑写 k = d1[j] 吗?绝对不能! 这里存在一条生死攸关的“安全红线”:
为什么必须用
强行截断?(物理安全底线)
处的回文花朵可能开得非常大,它的左花瓣甚至一直延伸到了区间左界 的外面。 - 但是,母体大回文
仅仅保证了自己在 范围之内的字符是完全对称的! - 一旦超出边界,右侧
以外的字符世界究竟长成什么样,母体根本一无所知! - 从中心
到右边界 包含中心在内,最多只有 个字符。因此,只有 步之内的信息是 100% 免检合法的。超出 的未知领地,必须停下来,交给接下来的 while循环去真正比对。
手推验证:abacaba 中的信息借用
当中心处理完
- 移到
:镜像为 。已知 ,右边界剩余 。取 。直接继承 ,向外比对 与 (即 c与b),不相等,扩展立即终止! - 移到
:镜像为 。已知 。右边界剩余 。取 。直接白嫖 ,连字符都不用比,就继承了半径 2!继续向外比对已越界,最终 d1[5]=2。
3. 偶数空隙的镜像计算(半格位移的精妙修正)
偶数空隙也是同样的镜像借力思想,但所有初学者在这里都会栽跟头:空隙的镜像坐标究竟怎么算?
- 我们对空隙的编号用的是它右侧字符的下标。因此,编号为
的空隙,它的物理真实坐标在 处。 - 整个大区间
的物理中心在 处。 - 设它翻过去的镜像空隙物理坐标为
,则有: - 按照规约,空隙编号取其右侧字符下标(即物理坐标加
):
教练敲黑板:这就是偶数回文镜像公式中那个看似诡异的
+1的物理来源!少了这个+1,你的对称镜子在物理空间上就照偏了整整半格,直接全盘皆输。
偶数扩展步骤:
- 若
,没有庇护,从 开始; - 若
,安全继承: ; while逐层考察待配对字符:左边为,右边为 ; - 扩展结束后更新右边界:当前回文覆盖
,若 ,则令 。
4. 纯 aaaaaa 手推:彻底看清常数跳步机制
拿最能卡死暴力的全相同字符串 a a a a a a,单看奇数回文的处理过程:
| 中心 |
继承方式与初始值 | 实际比对情况 | 最终 d1[i] |
此时维护的 |
|---|---|---|---|---|
| 0 | 比较失败(左出界) | 1 | ||
| 1 | 成功比对 1 对 | 2 | ||
| 2 | 成功比对 2 对,推开右边界 | 3 | ||
| 3 | 成功比对 1 对,推开右边界 | 3 | ||
| 4 | 比较下一层时右出界 | 2 | 保持 |
|
| 5 | 比较下一层时右出界 | 1 | 保持 |
关键细节剖析:
- 在中心 3:直接白嫖了半径 2,从下一层(下标 1 与 5)直接开比起,避免了从中心从头扩展。
- 在中心 4:镜像 2 的半径虽然高达 3,但此时
。安全红线死死拉住了它,防止它狂妄越界。正是这个取 ,从逻辑层面确保了算法 100% 的正确性。
四、复杂度证明:为什么套了 while 依然是严格
初看代码,外层 for 循环里面赫然嵌套着一个 while 循环,许多同学会下意识认为这是
物理视角的“单向开荒模型”:
我们要把目光聚焦在右边界 while 内部的比对尝试,只有两种命运:
- 比对失败:当前中心碰到了不相等的字符或撞到边界,
while循环立即终止。既然每个中心只会终止一次,那么在整个算法生命周期中,所有比对失败的总次数加起来最多只有次。 - 比对成功:只有当继承的初始半径已经触及或越过了已知的右边界
(即 )时,才有可能比对成功并执行 k++。而每一次成功的k++,都实打实地将右边界向右拓宽至少 1 格! 由于字符串长度只有 , 只能单调向右推进,最多从 0 推进到 ,永远不可能回头。因此,比对成功的总次数绝对不会超过 次。
成功最多
五、核心模板与实战代码:洛谷 P3805 最长回文子串
💡 【实战例题:洛谷 P3805 【模板】manacher】
- 输入格式:输入一行由小写英文字母组成的字符串
。 - 输出格式:输出一个整数,表示
中最长回文子串的长度。 - 数据范围:
。
1. 竞赛常数与空间极限优化
在 P3805 中,数据范围高达惊人的
- 内存考量:在 32 位 signed
int下,数组每个元素占 4 字节,一个千万级数组大约占用。如果盲目使用 #define int long long,数组直接翻倍飙升到近。由于题目中回文长度和下标绝对在 以内,这里刻意保持 32 位 int,以压榨出极致的内存与 CPU 缓存性能。 - 空间复用黑科技:既然我们只求全局最大的回文长度,奇数回文半径在跑完第一轮后就不再需要保留。我们可以让奇数与偶数扫描完全共用同一个全局数组
d[N]!- 为什么偶数扫描不会读到残存的奇数数据?
- 因为偶数扫描查镜像时,
。镜像位置 一定在当前中心 的左侧,在跑偶数这一轮时,位置 早已被写入了最新的偶数半径!
#include<bits/stdc++.h>
using namespace std;
const int N=11000005;

string s;
int d[N];
int n,ans;

void solve(){
	cin>>s;
	n=s.size();

	// 1. 第一遍:处理所有奇数回文中心
	int l=0,r=-1;
	for(int i=0;i<n;i++){
		// 处于已知回文内则取镜像与右边界的交集,否则初始半径为 1
		int k=(i>r?1:min(d[l+r-i],r-i+1));

		// 暴力尝试向外扩展
		while(i-k>=0 && i+k<n && s[i-k]==s[i+k]) k++;

		d[i]=k;
		ans=max(ans,2*k-1); // 奇数长度为 2k - 1

		// 若右端点进一步被推开,则更新维护区间
		if(i+k-1>r){
			l=i-k+1;
			r=i+k-1;
		}
	}

	// 2. 第二遍:处理所有偶数空隙中心(直接复用 d 数组)
	l=0,r=-1;
	for(int i=0;i<n;i++){
		// 偶数镜像注意带上 +1;无庇护时初始配对数为 0
		int k=(i>r?0:min(d[l+r-i+1],r-i+1));

		// 考察左右两侧对称字符
		while(i-k-1>=0 && i+k<n && s[i-k-1]==s[i+k]) k++;

		d[i]=k;
		ans=max(ans,2*k); // 偶数长度为 2k

		if(i+k-1>r){
			l=i-k;
			r=i+k-1;
		}
	}

	cout<<ans<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
提取具体子串技巧:若题目要求输出最长回文子串本身,只需在
ans被更新时顺便记录最长子串的起始下标:
- 奇数回文的起点为
i - k + 1;- 偶数回文的起点为
i - k。 扫描完毕后,直接调用s.substr(start_pos, ans)即可,严禁在循环内做字符串拷贝!
六、进阶模型:
💡 【实战例题:静态子串回文在线查询】
- 输入格式:
- 第一行输入一个字符串
; - 第二行输入一个整数
,表示询问次数; - 接下来
行,每行给出两个整数 (0-based 索引,保证 )。 - 输出格式:对于每次询问,如果子串
是回文串输出 Yes,否则输出No。- 数据范围:
, 。
1. 破题引导:中心与半径的几何包容性
不要试图对每次询问去走一遍比较,那将是
注意到区间
- 它的几何中心位置是绝对固定死的。
- 只要判断该几何中心所能达到的最大回文半径,能否把区间
完整罩住!
-
若
为奇数: - 几何中心在字符上:
(等价于 )。 - 该区间从中心往单侧需要辐射
步,加上中心自己,需要的最小半径是 。 - 判定标准:
。
- 几何中心在字符上:
-
若
为偶数: - 几何中心在空隙上:空隙右侧字符下标正好也是
(等价于 )。 - 该区间需要成功配对
对字符。 - 判定标准:
。
- 几何中心在空隙上:空隙右侧字符下标正好也是
物理意义点睛:为什么这里用
>=而不是==? 因为一个大的回文串,以其中心向内收缩出来的所有同心子串,全部必然都是合法回文串!所以只要最大半径能够“覆盖”询问区间即可。
这次因为随时需要应对奇偶查询,我们需要完整保留两个半径数组 d1 与 d2。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1000005;

string s;
int d1[N],d2[N];
int n,q;

void solve(){
	cin>>s;
	n=s.size();

	// 预处理奇数回文半径
	int l=0,r=-1;
	for(int i=0;i<n;i++){
		int k=(i>r?1:min(d1[l+r-i],r-i+1));
		while(i-k>=0 && i+k<n && s[i-k]==s[i+k]) k++;
		d1[i]=k;
		if(i+k-1>r){
			l=i-k+1;
			r=i+k-1;
		}
	}

	// 预处理偶数回文半径
	l=0,r=-1;
	for(int i=0;i<n;i++){
		int k=(i>r?0:min(d2[l+r-i+1],r-i+1));
		while(i-k-1>=0 && i+k<n && s[i-k-1]==s[i+k]) k++;
		d2[i]=k;
		if(i+k-1>r){
			l=i-k;
			r=i+k-1;
		}
	}

	// O(1) 在线回答每次询问
	cin>>q;
	while(q--){
		int L,R;
		cin>>L>>R;
		int len=R-L+1;
		bool ok=false;

		int c=L+len/2; // 极其优美的统一下标计算
		if(len%2==1){
			ok=(d1[c]>=len/2+1);
		}else{
			ok=(d2[c]>=len/2);
		}

		cout<<(ok?"Yes":"No")<<'\n';
	}
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
2. 样例验证
输入数据:
abba
4
0 3
1 2
0 2
3 3
输出数据:
Yes
Yes
No
Yes
单测拆解:
[0, 3]:偶数长 4,中心,查 d2[2] = 2 >= 2,判定为Yes。[1, 2]:偶数长 2,中心,查 d2[2] = 2 >= 1,判定为Yes。[0, 2]:奇数长 3,中心,查 d1[1] = 1 < 2,判定为No。[3, 3]:单字符长 1,中心,查 d1[3] = 1 >= 1,判定为Yes。
《字符串哈希》第四节第 3 小节与第六节也用正反哈希判断回文;这里预处理半径后同样能
七、进阶模型:基于半径的回文子串计数
问题场景:给定一个字符串,求出其中包含的所有合法回文子串的总数量。注意:位置不同但内容相同的回文串算作独立的多个。
状态含义与推导:
回文串在结构上是层层嵌套的。如果在某个中心位置剥开了一朵半径为 3 的回文花朵(例如长度为 5 的奇数回文 ababa),那么随着半径的收缩,内部的 bab 和单字符 a 也必然是合法的回文串。
这意味着,对于任意一个中心
- 它的最大奇数半径为
d1[i],也就代表着以它为中心,能恰好套出d1[i]个不同的奇数回文串。 - 同理,以它的空隙为中心的最大偶数半径(即配对对数)为
d2[i],说明能套出d2[i]个偶数回文串。
关键结论:整个字符串包含的回文子串总数,就是所有中心能辐射出的同心回文数量之和,即
手推小例子:
以字符串 aba 为例。
- 考察奇数半径
d1:i=0(字符a):半径 1,贡献 1 个(a)i=1(字符b):半径 2,贡献 2 个(b,aba)i=2(字符a):半径 1,贡献 1 个(a)- 奇数回文总计:
个。
- 考察偶数半径
d2:- 相邻无相同字符,所有空隙扩展配对数均为 0。
- 偶数回文总计:0 个。 因此总共有 4 个回文子串。
实现要点:
只需在跑完 Manacher 获取 d1 和 d2 后直接累加。
long long ans=0;
for(int i=0;i<n;i++) ans+=1LL*d1[i]+d2[i];
全 a 串的回文子串总数是 long long,不能只看半径数组的范围。
八、选学:前缀/后缀回文判定与最少末尾补齐
场景:
给定一个字符串
先修提示:本模型需要你已经完全掌握
d1和d2数组区间端点的坐标计算。
破题与推导:
设原串长度为
- 结论:添加的最少字符数 = 多余前缀的长度 =
= 总长度 - 最长回文后缀长度。
如何用 Manacher 判定回文后缀(或前缀)?
回文后缀的本质,就是这个回文区间的右端点必须刚好顶到原串的最后一个字符(即坐标
- 奇数回文:半径为
k = d1[i],它的右端点落在。 - 若
,它就是一个回文后缀,长度为 。
- 若
- 偶数回文:半径为
k = d2[i],它的右端点同样落在。 - 若
,它也是一个回文后缀,长度为 。
- 若
同理延伸:如果是要求解“最长回文前缀”或“在头部最少补字符”,只需要检查回文的左端点是否刚好顶到下标
0即可。奇数左端点为,偶数左端点为 。
💡 【自拟实战:末尾补全回文】
- 输入格式:输入一行由小写英文字母组成的字符串
。 - 输出格式:输出最少需要在末尾添加的字符数。
- 数据范围:
。 - 样例输入:
abac- 样例输出:
3
代码实现细节:
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=1000005;

string s;
int d1[N], d2[N];
int n;

void solve(){
	cin>>s;
	n=s.size();

	// 1. 跑奇数 Manacher
	int l=0, r=-1;
	for(int i=0;i<n;i++){
		int k=(i>r?1:min(d1[l+r-i],r-i+1));
		while(i-k>=0 && i+k<n && s[i-k]==s[i+k]) k++;
		d1[i]=k;
		if(i+k-1>r){ l=i-k+1; r=i+k-1; }
	}

	// 2. 跑偶数 Manacher
	l=0, r=-1;
	for(int i=0;i<n;i++){
		int k=(i>r?0:min(d2[l+r-i+1],r-i+1));
		while(i-k-1>=0 && i+k<n && s[i-k-1]==s[i+k]) k++;
		d2[i]=k;
		if(i+k-1>r){ l=i-k; r=i+k-1; }
	}

	// 3. 寻找最长回文后缀
	int max_suffix_len = 1; // 至少最后一个字符本身是回文后缀

	for(int i=0;i<n;i++){
		// 检查奇数回文是否是后缀
		if(i + d1[i] - 1 == n - 1){
			max_suffix_len = max(max_suffix_len, 2 * d1[i] - 1);
		}
		// 检查偶数回文是否是后缀
		if(i + d2[i] - 1 == n - 1){
			max_suffix_len = max(max_suffix_len, 2 * d2[i]);
		}
	}

	// 最少添加字符数 = 总长度 - 最长回文后缀长度
	cout << n - max_suffix_len << '\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
手推验证样例(abac):
- 对于奇数中心
(字符 a),d1[2] = 1。右端点为,不是后缀。 - 对于奇数中心
(字符 c),d1[3] = 1。右端点为,刚好触底!这是一个长度为 的回文后缀。 - 偶数中心均无法配对形成更长的后缀。
所以
max_suffix_len = 1。 我们需要补齐的字符数为(即将前缀 aba逆序翻转后拼在最后,最终串变为abacaba)。
九、考场避坑指南与教练提点
-
手造极端小样自检: 写完代码后,绝对不要直接拿千行长串盲测。立刻在纸上自测这 4 个微型测试串:
"a":单字符奇半径必为 1,偶半径全为 0,最长回文长度为 1;"aa":检验偶数中心是否生效,,最长回文长度为 2; "ab":相邻不同字符,奇半径均为 1,偶半径全为 0,最长回文长度为 1;"abba":检验偶数中心扩展多层,,最长回文长度为 4。
-
偶数镜像的
+1严防漏写: 再提醒一次:奇数镜像是l + r - i,偶数镜像是l + r - i + 1!漏了加 1,镜子就照偏了,不仅答案算错,还可能引发越界访问。 -
1-based 与 0-based 的协调转换: 本讲采用 0-based,是为了让原串下标和
的中心公式直接对应。如果题目输入是 1-based,在读入询问后做一步 L--, R--即可接入。补空格的 1-based 写法也可以用,但半径和区间公式要一起保持一致,不要混用两套下标。 -
回文子串计数:半径求和及
long long累加见第七节;这是按出现位置计数,不能直接用来求本质不同的回文串数。