一、暴力的绝望与分治的灵魂:拆开容易,凭什么接回来?
很多同学在初学搜索和递归时,经常会陷入一种盲目的乐观:“不就是选与不选吗?写个 DFS 搜到底不就完了?”
我们来看一个最直观的场景:手头有
这时大家最本能的灵感往往是:“那我把它拦腰斩断成两半行不行?”
左边放
先别高兴得太早。把问题切成两半毫无门槛,真正的死穴在于:你怎么把两半的答案拼回全局答案?
如果你把左边的
分治的核心命题: 拆开只需要一刀,并不值钱;分治的真正智慧在于:两半各自交出什么样的“半成品”,才能让我们绕开笨拙的穷举,以极低的时间代价把全局答案“光速接回来”?
本篇我们就从最经典的归并分治(逆序对统计)出发,参透有序性在合并中的妙用;随后杀入折半搜索(Meet-in-the-Middle),看看二分查找是如何把两半方案的笛卡尔积直接拍扁的。
二、归并分治:排序为什么能白捡逆序对?
1. 物理视角的转换:跨越分界线的相对位置
给定序列 3, 1, 2, 2,开头的 3 分别压制后面的 1, 2, 2,构成 3 个逆序对;而两个相等的 2 并不算。
直接双重循环暴力统计是 mid 划开:
- 左半段:
- 右半段:
在物理意义上,整个区间内的任意一个逆序对
- 纯左侧对:
- 纯右侧对:
- 跨分界线对:
且
前两种情况是规模减半的子问题,直接扔给递归去搞定;当前这层递归的核心职责,就是在合并时统计所有第三类(跨界)逆序对。
请盯紧这个美妙的天然性质:因为划分是以原始下标为基准的,所以左半段任意元素的原下标,天生就严格小于右半段任意元素的原下标! 换言之,只要一个元素来自左边、另一个来自右边,“左边位置在前、右边位置在后”这一位置条件已经被上帝视角锁死了。我们要关心的,只剩下纯粹的数值大小关系。
2. 为什么排序不会捣乱?——让有序性成为加速器
很多同学在这里会产生巨大的心理障碍:“归并排序会改变元素的位置,我把数组排好序了,原题的逆序对不就被我洗乱了吗?”
答案是:绝对不会!
- 内部顺序改变了吗?改变了。但左半段内部、右半段内部的逆序对,子函数在排序前就已经统统结算清了!
- 跨界关系改变了吗?没有!左半段不论怎么内部折腾,它们依然全体排在右半段的前面。
最绝的地方来了:正因为左右两半各自变得单调递增,我们才拥有了一次性“批量结算”逆序对的特权!
3. 双指针合并时的“批量收割”
假设合并过程中,左半段排好序后还剩 [2, 5, 7],右半段当前扫到的最小值是 4。
我们拿左指针 i 指向 5,右指针 j 指向 4 进行比较:
左半段(有序):  [ 2 ,  5 ,  7 ]   (区间 [l, mid))
                        ^ (指针 i)
右半段(有序):  [ 4 , ... ]        (区间 [mid, r))
                    ^ (指针 j)
发现
我们还需要傻傻地一个个去问“你大不大”吗?完全不需要!
这一瞬间,与右侧这个数字 4 形成的所有跨界逆序对数量,就是左半段当前还剩下来的元素总数:
4 塞进临时数组,右指针前进一步。这个 4 已经把它这辈子的跨界逆序对结清了,永不重复计算。
边界铁律:如果
怎么办? 逆序对要求严格大于,相等绝不算!因此当数值相等时,必须先移动左指针放左边元素,此时贡献为 0。代码中请严格书写 if (a[i] <= a[j]),漏掉等号就会把相等元素误判为逆序对!
4. 步步手推样例:3, 1, 2, 2
我们把样例从底向上彻底拆开推一遍:
- 拆分为
[3, 1]和[2, 2]。 - 左边
[3, 1]递归:拆成[3]和[1],合并时发现,产生 1 个逆序对,排成 [1, 3]。 - 右边
[2, 2]递归:拆成[2]和[2],合并时先放左边,产生 0 个逆序对,维持 [2, 2]。 - 顶层合并:左边
[1, 3],右边[2, 2]。- 比对
1与2:,放 1,左指针移到3(无逆序对)。 - 比对
3与首个2:,右边小!左边剩下 3这 1 个数,累加贡献,放首个 2。 - 比对
3与次个2:,右边小!左边依然剩下 3这 1 个数,累加贡献,放次个 2。 - 右边耗尽,左边剩下的
3依次拷入临时数组。
- 比对
- 最终总逆序对数 = 内部贡献
跨界贡献 对。精准无误。
三、核心程序一:归并分治求逆序对
本篇程序使用左闭右开区间 mid-i;《排序算法进阶》的左闭右闭模板则写 mid-i+1,不要混用边界。
1. 输入输出协议与数据范围
- 输入格式:第一行一个整数
,第二行 个整数。 - 输出格式:一个整数,表示序列中的逆序对总数。
- 数据范围:
, 。支持 (此时输出 0)。 - 空间与溢出:极端倒序情况下,逆序对数量为
,早已冲爆 32 位整型,累加器与答案必须全程使用 long long。
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=500005;

// a 为原始数据数组,b 为归并合并时使用的全局临时缓冲数组
int a[N],b[N];
int n;

// 左闭右开区间 [l, r) 的归并求解
int solve_merge(int l, int r){
	// 边界:区间长度 <= 1,天然有序,内部不可能存在逆序对
	if(r-l<=1) return 0;

	int mid=(l+r)/2;
	// 1. 递归解决两半,收集子问题内部的逆序对
	int ans=solve_merge(l,mid)+solve_merge(mid,r);

	// 2. 双指针线性合并,批量捕获跨界逆序对
	int i=l,j=mid,k=l;
	while(i<mid && j<r){
		if(a[i]<=a[j]){
			// 相等或左小:先放左边,不能计入逆序对
			b[k++]=a[i++];
		}else{
			// 左大:由于左半段有序,从 i 到 mid-1 的所有元素都大于 a[j]
			ans+=mid-i;
			b[k++]=a[j++];
		}
	}
	// 收尾工作:剩下的元素直接平移,不再产生跨界贡献
	while(i<mid) b[k++]=a[i++];
	while(j<r) b[k++]=a[j++];

	// 把排好序的结果写回原数组 a,为上一层合并提供单调性保障
	for(int p=l;p<r;p++) a[p]=b[p];

	return ans;
}

void solve(){
	if(!(cin>>n)) return;
	for(int i=0;i<n;i++) cin>>a[i];
	cout<<solve_merge(0,n)<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
四、为什么复杂度是
初学者常常看见“每次砍半”就脱口而出“对数复杂度
- 树的高度确实是对数:长度为
的区间每次对半切,切到单元素总共只需要切 层。 - 但每一层的工作量都是满的:
- 第 1 层:1 个长度为
的区间合并,耗时 。 - 第 2 层:2 个长度为
的区间合并,耗时 。 - 第
层: 个区间合并,总元素数依然是 ,合并依然要处理 个数,耗时还是 。
- 第 1 层:1 个长度为
每一层都在扎扎实实地做 b 全局共用,空间复杂度为
五、折半搜索 (Meet-in-the-Middle):用二分斩断笛卡尔积
1. 核心模型:子集和上限问题
现在我们直面最棘手的问题:给定
- 左半边建表:取前
个数(最多 20 个),穷举所有可能的选取方案,把所有子集和收集到数组 中。 - 右半边建表:取剩下的
个数(最多 20 个),穷举所有可能的选取方案,把所有子集和收集到数组 中。
两个数组各自最多只有
如果右半边的数组 upper_bound(B.begin(), B.end(), M - x),它返回第一个严格大于 B.begin(),就是合法元素的总个数!
每一次查询只需
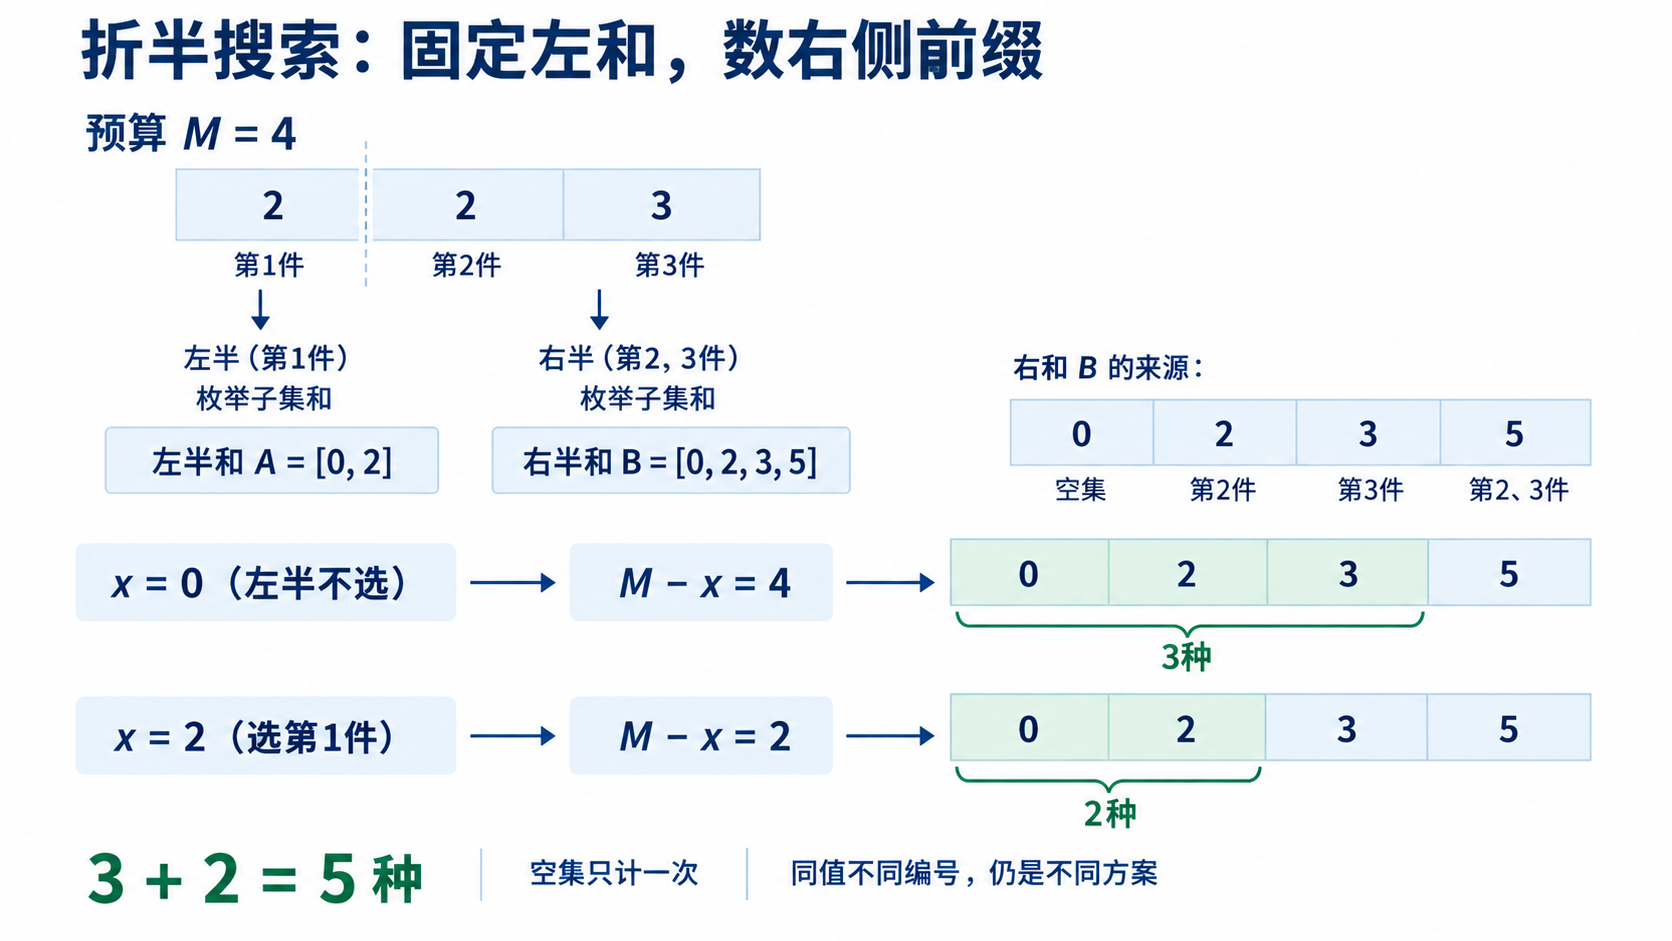
2. 手推微型样例:物品 2, 2, 3,预算
为了让逻辑毫无破绽,我们把 3 个物品按编号拆开推演:
- 数组划分:左半边取第 1 个数
[2];右半边取第 2、3 个数[2, 3]。 - 左侧子集和表:
- 什么都不选(空集):和为
- 选第 1 个数:和为
- 左侧表得到:
{0, 2}
- 什么都不选(空集):和为
- 右侧子集和表:
- 什么都不选(空集):和为
- 只选第 2 个数:和为
- 只选第 3 个数:和为
- 两个都选:和为
- 右侧表排序后为:
{0, 2, 3, 5}
- 什么都不选(空集):和为
现在拿着左边的每一种可能,去右边二分查询:
- 左侧选 0(消耗 0):右侧预算余额为
。 - 在
{0, 2, 3, 5}中查找的数,匹配到 0, 2, 3,共有 3 种方案。
- 在
- 左侧选 2(消耗 2):右侧预算余额为
。 - 在
{0, 2, 3, 5}中查找的数,匹配到 0, 2,共有 2 种方案。
- 在
- 全局总方案数 =
种方案。 (这 5 种物理方案分别是:空集、只选第1个物品、只选第2个物品、只选第3个物品、选第1和第2个物品)。
3. 避坑指南:三个最容易丢分的致命陷阱
雷区一:绝对不能做 unique 去重!
有的同学写顺手了,看到排序后面就想接个去重。
请牢记:题目统计的是“方案数”,方案是由物品编号定义的,而不是由数值定义的!
在右侧表中,选第 2 个数和为
雷区二:空集不是平白无故多出来的一种
子集和为 0 的空集本身就是一个合法子集。
在我们的算法设计中,左右两张表初始都塞入了一个 0:
- 左边选
0、右边选0,正好对应全局空集,此时总和为 0。 - 只要预算
,全局空集就会自然而然地被二分匹配算进去,代码末尾绝对不要画蛇添足写 ans++! - 如果预算
,空集连合法都谈不上,更不能额外硬加。
雷区三:滚动生成时先锁住旧长度
生成 {0}。每读入一个新元素 int old_sz = s.size();,只遍历前 old_sz 个元素!如果把循环终点动态写成 s.size(),循环会永远追赶刚插入的尾巴,导致死循环或内存耗尽。
六、核心程序二:折半搜索子集和计数
1. 输入输出协议与数据范围
- 输入格式:第一行包含两个整数
;第二行包含 个整数。若 ,仅读入第一行。 - 输出格式:一个整数,表示和不超过
的子集方案数。 - 数据范围:
, , 。支持正数、负数、零及重复元素;空集参与统计。 - 极值说明:半边和的极值不超过
,差值 在 ,方案数最大为 ,全部安全容纳于 long long。
#include<bits/stdc++.h>
#define int long long
using namespace std;

vector<int> a;
int n,m;

// 迭代生成半边区间 [l, r) 的所有子集和
vector<int> gen(int l, int r){
	vector<int> s;
	// 提前预分配内存,杜绝多次扩容造成的性能抖动
	s.reserve(1ULL<<(r-l));
	// 基础状态:放入空集(和为 0)
	s.push_back(0);

	for(int i=l;i<r;i++){
		int old_sz=s.size();
		// 严密限制仅扫描旧状态,每个旧状态衍生出一个新状态
		for(int j=0;j<old_sz;j++){
			s.push_back(s[j]+a[i]);
		}
	}
	return s;
}

void solve(){
	if(!(cin>>n>>m)) return;
	a.resize(n);
	for(int i=0;i<n;i++) cin>>a[i];

	// 1. 将 n 个物品拦腰斩断为两半
	vector<int> left=gen(0,n/2);
	vector<int> right=gen(n/2,n);

	// 2. 将右半边排序,构建单调性
	sort(right.begin(),right.end());

	// 3. 遍历左半边每个子集和 x,在右半边二分查找合法上限 m - x
	int ans=0;
	for(int x:left){
		// upper_bound 找到第一个 > m - x 的位置,减去 begin 即为 <= m - x 的方案数
		ans+=upper_bound(right.begin(),right.end(),m-x)-right.begin();
	}

	cout<<ans<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
七、分治复杂度的逐层账本:在草稿纸上算清每一笔递归开销
很多同学在分析递归算法时总喜欢凭玄学直觉,只要看到“砍一半”就脱口而出对数,看到两层循环就猜平方。一旦题目出现非对称划分、合并时附带额外二分、或者树分治中带有奇怪的剪枝,脑子立刻陷入混乱。
在考场上,最稳妥、最不依赖高深数学公式的方法,就是在草稿纸上拉一张逐层流水账本(递归树分析法)。
1. 递归树的三栏对账法
我们把任何一个分治函数的开销,严格拆成三栏进行逐层登记:
- 层号
:根节点为第 层,向下递归层数递增。 - 节点个数与子问题规模:第
层有多少个独立子问题,每个子问题的规模 是多少。 - 单节点合并代价与本层总账:当前层每个节点在“拆开”与“接回来”时耗费的时间,所有节点汇总后本层的总运算量。
我们以归并分治统计逆序对(
| 层号 |
本层子问题数 | 单个子问题规模 |
单节点合并开销 | 当前层总开销(行汇总) |
|---|---|---|---|---|
| 整单结算 | 总层数 |
— | — | 每一层总账都是 |
你看,账本把一切障眼法剥得干干净净:虽然底层节点密密麻麻,但每个节点处理的区间极短;虽然顶层只有 1 个节点,但它合并了全量数据。每一层发生的总运算量是完全守恒的! 守恒的单层开销乘以
2. 常见分治形态的账本结算规律
掌握了拉账本的方法,我们再来看另外两种极易混淆的分治变体:
形态 A:合并带额外开销(账本逐层递增)
如果我们在合并两个区间时,不是线性双指针,而是每个元素都在另一个有序区间里做了一次二分查找,或者对合并后的数组重新排序,此时单节点开销变为
形态 B:几何衰减型(顶层或底层统治)
考虑理想情况下的分治(如假设每次恰好砍掉一半的划分操作):
- 第 0 层:
- 第 1 层:
- 第 2 层:
总开销为公比为 的等比数列求和: 的代价,能够在线性时间内稳稳收官。(注意:普通的随机快速选择是期望线性时间,最坏可能退化为平方级;此处仅作理想几何衰减的模型演示。)
八、多维候选的支配删除:在同一约束下剔除无用解
折半搜索在处理“方案计数”时,只要左右配对合法就必须算上一笔。但在面对最优化问题(如超大背包求最大价值)时,情况发生了根本性的变化。
假设我们面对
1. 什么是支配?——劣质候选的无情出局
在右半边生成的上百万个候选方案中,往往充斥着大量“又笨又重”的废状态。 假设右边有两个候选方案:
- 方案
:消耗重量 ,提供价值 。 - 方案
:消耗重量 ,提供价值 。
请大家站在上帝视角思考:在未来的任何一次配对中,方案
绝对不可能!
因为方案
支配(Domination)准则: 若状态
与状态 满足: 则我们称状态 被状态 严格支配。在同一背包约束下,被支配的状态毫无生存空间,必须立刻将其彻底删除!
2. 单调化清洗:一次扫描构建 Pareto 前沿
怎么以最低的代价把所有被支配的状态一次性清洗干净? 利用双属性的偏序关系,标准流程分两步:
- 基准排序:将右侧所有方案按重量
升序排序;若重量相同,按价值 降序排序。 - 单调栈/前缀最大值清洗:从头到尾线性扫描排序后的序列,维护已经保留的候选方案中出现过的最大价值
max_v。- 如果当前候选的价值
:说明它更重(或等重),但价值反而更低(或相等),直接扔掉! - 如果当前候选的价值
:说明它虽然变重了,但价值实现了真正的突破,将其保留并更新 max_v = v。
- 如果当前候选的价值
清洗完毕后,留下的集合拥有极其纯粹的数学性质: 重量严格递增,价值也严格递增! 这就是运筹学中经典的 Pareto 最优边界。
3. 手算小例子:5 个二元组的洗牌全过程
假设右半边生成了 5 个二元组
我们按步骤推演:
- 排序规则:重量升序,重量相同按价值降序。排序后为:
。 - 初始最大价值
max_v = -1,清洗集合为空。 - 扫到
: ,保留! max_v刷新为。保留表: [(2, 5)]。 - 扫到
:重量变重为 3,价值却只有 。被前面的 支配,删除! - 扫到
: ,重量虽增至 4,但价值跃升,保留! max_v刷新为。保留表: [(2, 5), (4, 8)]。 - 扫到
: ,重量增至 5,价值冲破前高,保留! max_v刷新为。保留表: [(2, 5), (4, 8), (5, 9)]。 - 扫到
: 。重量相同为 5,但价值不及前面的 ,被支配,删除!
最终仅留下 [(2, 5), (4, 8), (5, 9)]。在重量单调递增的同时,价值实现了绝对单调递增!后续二分只要找到重量上限
九、折半搜索求最优值与方案恢复:超大背包的完整落地
很多同学能把最优值求出来,但题目一旦加上一句:“请输出具体选取了哪几件物品”,就彻底不会写了。有人甚至想在搜完后重新暴力回溯——这是完全没有必要的。
1. 为什么不需要存长数组?——用一个整数压缩选取方案
在折半搜索中,
- 左半边最多 20 个物品。
- 右半边最多 20 个物品。
要在每个状态里记录“到底选了哪几个物品”,千万不要开 vector<int> 去存物品编号列表!百万级数量的 vector 动态扩容与深拷贝会瞬间吃满内存并超时。
因为半边只有 20 个元素,一个 32 位整型(int)的二进制位,就足以完美记录该半边的所有选择:
- 第
位为 ,代表选了这半边的第 个物品;为 代表未选。 - 结构体只需紧凑地声明为:
struct Node {
	int w, v;    // 该方案消耗的重量与斩获的价值
	int mask;    // 二进制位掩码,记录该半边的选取路径
};
当我们要把最优解翻译成人类看得懂的物品编号时,只需对最终记下的 best_mask_l 与 best_mask_r 执行位运算提取:
- 左半边:若
(best_mask_l >> i) & 1为真,则选了第个物品(原始编号 )。 - 右半边:若
(best_mask_r >> j) & 1为真,则选了第个物品(原始编号 )。
2. 微型全流程手推:4 件物品手算方案复原
我们用一个精致的微型样例把“折半、支配删除、匹配、位解码”彻底串起来。
背包限重
- 编号 1:
- 编号 2:
- 编号 3:
- 编号 4:
步骤一:折半生成
- 左半边(物品 1、2):
- 空集:
- 只选 1:
- 只选 2:
- 选 1 和 2:
- 空集:
- 右半边(物品 3、4):
- 空集:
- 只选 3:
- 只选 4:
- 选 3 和 4:
(因 ,生成后也可以留着,后续二分自然会过滤掉)
- 空集:
步骤二:对右半边做支配删除
右半边按
步骤三:拿左半边逐个二分匹配右半边
- 左选空集
:右边限重 。二分找到 的最大项为 。总价值 。 - 左选物品 1
:右边限重 。二分找到 的最大项为 。总价值 。 - 左选物品 2
:右边限重 。二分找到 的最大项为 。总价值 !刷新全局最优!记下 best_mask_l = 10_2,best_mask_r = 10_2。 - 左选物品 1+2
:右边限重 。二分找到 的最大项为 。总价值 。
步骤四:方案解码
全局最大价值为
- 解码
best_mask_l = 10_2:第 0 位为 0,第 1 位为 1,说明选了左边第 1 个物品(即原编号 2)。 - 解码
best_mask_r = 10_2:第 0 位为 0,第 1 位为 1,说明选了右边第 1 个物品(原编号)。 - 最终确定最优选法为:选择物品 2 和物品 4。总重量
,总价值 。严丝合缝!
十、核心程序三:超大背包的最优解与方案恢复
1. 输入输出协议与数据范围
- 输入格式:第一行包含两个整数
;接下来 行,每行两个整数 ,表示每件物品的重量与价值。 - 输出格式:第一行输出一个整数,表示在限重
内能获取的最大总价值;第二行输出一个整数 ,表示所选物品的总件数;第三行升序输出 个空格分隔的整数,表示所选物品的原始编号(1-based)。若最大价值为 0,输出 件且第三行为空。 - 数据范围:
, , , 。所有计算在 long long范围内安全执行。
#include<bits/stdc++.h>
#define int long long
using namespace std;

struct Item {
	int w, v, id;
};

struct Node {
	int w, v;
	int mask; // 位掩码:低位记录选取方案
};

int n, W;
vector<Item> items;

// 迭代生成半边区间的子集状态,并附带 bitmask
vector<Node> gen_half(int l, int r){
	int len = r - l;
	vector<Node> res;
	res.reserve(1ULL << len);
	res.push_back({0, 0, 0}); // 基础空状态

	for(int i = 0; i < len; i++){
		int old_sz = res.size();
		int cur_w = items[l + i].w;
		int cur_v = items[l + i].v;
		for(int j = 0; j < old_sz; j++){
			// 若单项累加未超限则加入候选(剪去严重超重分支)
			if(res[j].w + cur_w <= W){
				res.push_back({
					res[j].w + cur_w,
					res[j].v + cur_v,
					res[j].mask | (1 << i)
				});
			}
		}
	}
	return res;
}

void solve(){
	if(!(cin >> n >> W)) return;
	items.resize(n);
	for(int i = 0; i < n; i++){
		cin >> items[i].w >> items[i].v;
		items[i].id = i + 1;
	}

	int mid = n / 2;
	vector<Node> left = gen_half(0, mid);
	vector<Node> right = gen_half(mid, n);

	// 1. 对右半边按重量升序排序,重量相同则价值降序
	sort(right.begin(), right.end(), [](const Node& a, const Node& b){
		if(a.w != b.w) return a.w < b.w;
		return a.v > b.v;
	});

	// 2. 支配删除清洗:构建重量递增、价值严格递增的 Pareto 前沿
	vector<Node> clean_r;
	clean_r.reserve(right.size());
	int max_v = -1;
	for(const auto& node : right){
		if(node.v > max_v){
			clean_r.push_back(node);
			max_v = node.v;
		}
	}

	// 3. 提取清洗后右半部的纯重量数组,便于调用 std::upper_bound 进行快速二分
	vector<int> rw;
	rw.reserve(clean_r.size());
	for(const auto& node : clean_r) rw.push_back(node.w);

	// 4. 左半部逐个出击,二分匹配最优值并记录最优 mask
	int best_val = 0;
	int best_mask_l = 0, best_mask_r = 0;

	for(const auto& l_node : left){
		if(l_node.w > W) continue;
		int rem_w = W - l_node.w;

		// 查找最后一个 weight <= rem_w 的位置
		int pos = upper_bound(rw.begin(), rw.end(), rem_w) - rw.begin() - 1;
		if(pos >= 0){
			int total_v = l_node.v + clean_r[pos].v;
			if(total_v > best_val){
				best_val = total_v;
				best_mask_l = l_node.mask;
				best_mask_r = clean_r[pos].mask;
			}
		}
	}

	// 5. 解码最优选取方案
	vector<int> chosen_ids;
	for(int i = 0; i < mid; i++){
		if((best_mask_l >> i) & 1) chosen_ids.push_back(items[i].id);
	}
	for(int j = 0; j < n - mid; j++){
		if((best_mask_r >> j) & 1) chosen_ids.push_back(items[mid + j].id);
	}

	// 6. 输出结果
	cout << best_val << '\n';
	cout << chosen_ids.size() << '\n';
	for(int i = 0; i < (int)chosen_ids.size(); i++){
		cout << chosen_ids[i] << (i + 1 == (int)chosen_ids.size() ? "" : " ");
	}
	cout << '\n';
}

signed main(){
	ios::sync_with_stdio(0), cin.tie(0);
	solve();
	return 0;
}
对应测试样例
输入样例:
4 8
2 3
3 5
4 6
5 7
输出样例:
12
2
2 4
样例解释:
背包限重为 8。选择第 2 件物品(重 3,值 5)和第 4 件物品(重 5,值 7),总重量为 2 4。
十一、双指针单调扫描与高维偏序前瞻(选学)
先修要求:熟练掌握基础双指针单调夹逼技巧,了解二维偏序基本概念。
在核心程序三中,我们在清洗完右半边后,遍历左半边的每一个元素并在右半边进行二分查找。如果左半边有
我们能不能把二分的对数也彻底干掉?
答案是:完全可以,用双指针!
1. 双单调性下的线性收割
请注意,不仅右半边可以做支配删除,左半边同样可以先按重量升序排序! 当左右两边都变得有序后:
- 左指针
从左往右扫,左半边选取的重量 单调递增。 - 随着左边消耗的重量不断增加,留给右半边的剩余预算
必然单调递减! - 右指针
初始停在右半边的最末尾(最重、价值最高的地方)。每当 时,右指针只需单向左移 j--,直到不超重为止。
因为右半边已经过支配清洗,此时停在合法边界上的
左指针单向右移
2. 高维偏序前瞻:多维约束下的分治延伸
我们在超大背包中进行的支配删除,本质上是在解决一个二维偏序问题(重量
但在更复杂的信奥题中,如果我们面对的是三个约束(例如:同时限制总重量
- 第一维由外层常规排序直接解决;
- 第二维由递归过程中的归并分治接管;
- 第三维由内层的数据结构(树状数组/线段树)在双指针归并时动态维护。
归并分治不是某种单题特化的奇技淫巧,它是整个算法进阶体系中,用于“降维打击”高维约束最锋利的基石。
十二、进阶心法:分治与折半搜索的解题雷达
当我们坐在考场上,如何敏锐地嗅出这两种算法的气味?
| 算法模型 | 典型识别特征 | 核心连接武器 | 经典应用场景 |
|---|---|---|---|
| 归并分治 | 数据规模 需要统计跨区间的二维偏序对(如位置与数值) |
双指针有序扫描 | 逆序对统计、平面最近点对、CDQ分治前置技能 |
| 折半搜索 | 01 选择/子集问题, 容量或数值极大,常规背包 DP 开不下 |
排序 + 二分查找 / 哈希表 | 子集和计数、超大背包最优解、多方程求整数解 |
1. 渐进式实战练习题单
- 洛谷 P1908 逆序对
- 训练指引:归并分治的母题。请脱离模板,独立默写双指针合并与跨界结算逻辑,严格核验相等元素的处理与
long long范围。
- 训练指引:归并分治的母题。请脱离模板,独立默写双指针合并与跨界结算逻辑,严格核验相等元素的处理与
- 洛谷 P4799 [CEOI 2015] 世界冰球锦标赛 (Day2)
- 训练指引:折半搜索的标准实战靶场。题目给出至多 40 场比赛的票价和总预算
,求合法观赛方案数。模型与本讲核心程序二完全一致,注意票价为正整数,体验折半搜索的秒杀快感。
- 训练指引:折半搜索的标准实战靶场。题目给出至多 40 场比赛的票价和总预算
- 洛谷 UVA1152 和为0的4个值
- 训练指引:四个长度为
的数组各选一个数,使其和为 0。直接四重循环是 。利用折半思想:把前两个数组的所有两两之和存下来,后两个数组的所有两两之和存下来,将问题转化为“在两个大小为 的表中查找相反数”,排序后二分或双指针即可 解决。
- 训练指引:四个长度为
- 洛谷 P5691 [NOI2001] 方程的解数
- 训练指引:多元高次方程在给定区间内的整数解个数,未知数个数
。若直接暴力枚举复杂度为 。将方程移项,左边放 3 个未知数,右边放 3 个未知数,两边各 ,通过哈希表或排序二分光速配对,是省选级别的折半搜索名题。
- 训练指引:多元高次方程在给定区间内的整数解个数,未知数个数