一、引入:做题时的两类痛点
在刷题过程中,有两类场景经常让人写得心烦:
- 去重与排序混在一起:给出一堆杂乱的数字,要求去掉所有重复的,并按从小到大输出。手写快排再扫一遍去重,或者用
sort配合unique,稍微手抖就容易写出边界 Bug。 - 数组开不下(计数桶失效):统计数字出现次数时,我们最习惯写计数数组
cnt[x]++。可如果给出的数字高达 、是负数,甚至是字符串(比如记录单词 "apple"出现了几次),普通数组就没法直接照搬了。
C++ STL 里的 set 和 map,就是为了优雅解决这两个问题而生的工具。
二、Set(集合):自动去重与排序
1. 核心特性
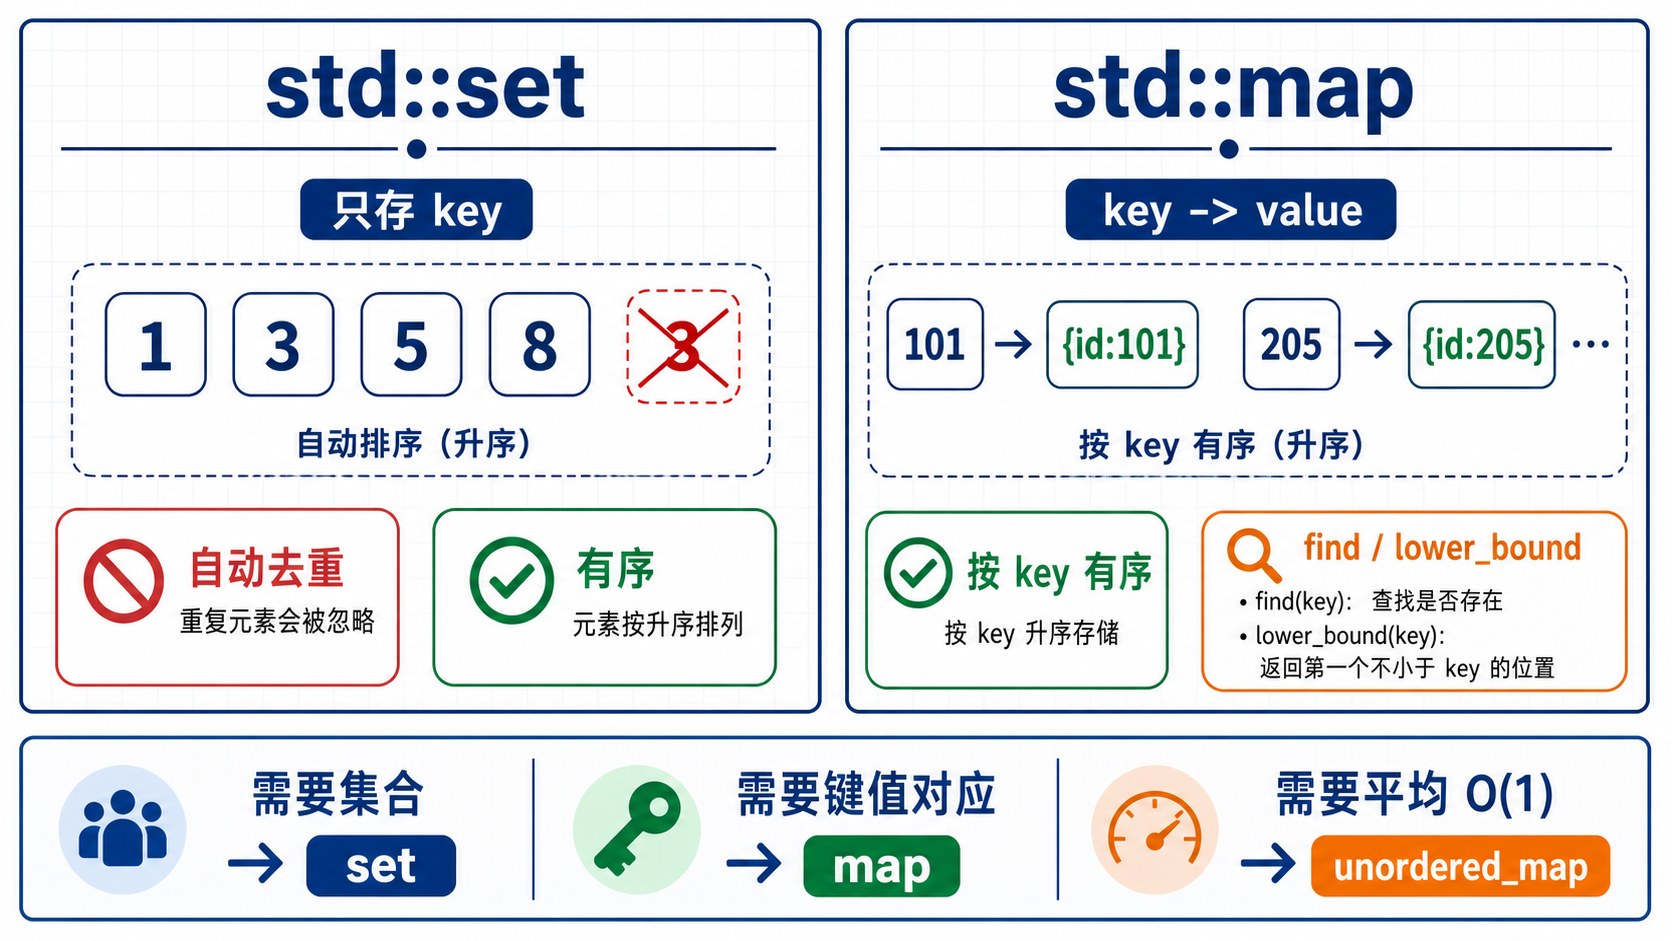
可以把 set 想象成一个“自带排序与查重功能的收纳盒”:
- 去重:里面绝不会出现两个相同的元素。如果往里扔已经存在的数字,它会自动忽略。
- 有序:不管按什么顺序塞数据,内部始终自动维护严格从小到大的升序。
2. 常用操作与小例子
大部分单次操作的时间复杂度都是
set<int> s;

s.insert(3); // 集合内: {3}
s.insert(1); // 集合内: {1, 3}
s.insert(3); // 再次插入 3,自动忽略,集合仍为: {1, 3}

cout << s.size() << "\n";  // 输出 2(元素总数)
cout << s.count(3) << "\n"; // 输出 1(存在返回 1,不存在返回 0)

s.erase(1);  // 删掉 1,集合内剩: {3}
s.empty();   // 判断是否为空(非空返回 0)
3. 遍历方式
利用 C++11 的范围 for 循环,可以直接按升序扫出所有元素:
for (auto x : s) {
    cout << x << " "; // 输出的数字一定严格单调递增
}
4. 实战例题:P1059 [NOIP2006 普及组] 明明的随机数
- 题目链接:洛谷 P1059
- 题意简述:输入
个正整数,要求去掉重复的数字,并将剩余的数字从小到大排序输出。 - 思路点拨:这道题完全贴合
set的特性。我们只管挨个s.insert(x),去重和排序由内部自动完成。最后先输出s.size(),再循环输出集合内容即可。
#include<bits/stdc++.h>
#define int long long
using namespace std;
int n,x;
set<int> s;
signed main(){
    ios::sync_with_stdio(0),cin.tie(0);
    cin>>n;
    for(int i=1;i<=n;i++){
        cin>>x;
        s.insert(x);
    }
    cout<<s.size()<<"\n";
    for(auto x:s) cout<<x<<" ";
    cout<<"\n";
    return 0;
}
三、Map(映射):下标任意开的超级数组
1. 核心定义
普通数组 a[i] 的下标 i 只能是较小的非负整数。而 map 就像一本自适应字典:
- 它存的是键值对(Key - Value),Key 相当于数组下标,Value 相当于存入的值。
- 下标类型随意选:下标可以是
级别的超大整数、负数,甚至是字符串 string。
2. 基础操作与 [] 的访问机制
声明时在尖括号内填入 <下标类型, 值类型>:
map<int, int> cnt;       // 大数计数桶
map<string, int> score;  // 名字映射到分数

score["alice"] = 95;
cnt[1000000000] = 3;
重点关注:mp[x] 不存在时的自动创建
map 用起来像数组一样顺手,关键在于它的读取机制:
- 统计很方便:当键
x之前从未出现过时,调用mp[x]会自动插入该键,并将值初始化为0(或默认空值)。正因如此,做频次统计时可以直接写cnt[x]++,完全不需要先判断x在不在。 - 纯查有无的区别:
if (mp[x])判断的是值是否非零,不是这个键在不在。比如已经存了mp["banana"]=0,判断仍然是假;原先没有这个键,还会顺手新增一个值为 0 的节点。只想查有没有,就用count或find:
map<string, int> mp;

// 1. 做计数直接自增,不用管原先有没有
mp["apple"]++;

// 2. 纯查有无的最小对照
if (mp.count("banana")) {
    // 存在 banana
}
// 或者用 find 迭代器
if (mp.find("banana") != mp.end()) {
    // 存在 banana
}
3. 实战例题:P1102 A-B 数对
- 题目链接:洛谷 P1102
- 题意简述:给出一串长度为
的数列(数字高达 ),以及一个常数 ( )。求有多少组下标数对 满足 。
思路点拨:
- 题目是按不同位置来统计数对的。两重循环暴力枚举数对是
,必定超时。 - 数学移项:
。 - 我们先把所有数字读入,并用
map<int, int> cnt记录每个数值出现的次数。 - 接着遍历数组中的每一个位置当作
,我们要找的目标 就是 。此时只要去查看 cnt[B + C]的出现频次,累加到答案里即可。 - 注意范围:数对总数可能会非常多,答案必须开
long long。
拿 [1,1,2,2,2]、
#include<bits/stdc++.h>
#define int long long
using namespace std;
const int N=2e5+5;
int n,c,ans,a[N];
map<int,int> cnt;
signed main(){
    ios::sync_with_stdio(0),cin.tie(0);
    cin>>n>>c;
    for(int i=1;i<=n;i++){
        cin>>a[i];
        cnt[a[i]]++;
    }
    for(int i=1;i<=n;i++){
        ans+=cnt[a[i]+c];
    }
    cout<<ans<<"\n";
    return 0;
}
四、Multiset:允许重复元素的有序集合
1. 为什么需要 Multiset?
普通的 set 会自动去重,但有时候我们就是需要保留重复的数字,仅仅是贪图它“随时插入数字并自动排好序”的功能。比如要动态维护一个班级的成绩排名,有两个人都考了 90 分,如果用 set,其中一个 90 分就被吃掉了,这显然不行。这时候就要用到 multiset。
2. 危险的 Erase:如何只删一个副本?
multiset 的基础操作(insert、size、empty)和 set 一模一样,但 erase 隐藏着一个很容易踩坑的机制。
当我们调用 s.erase(x) 时,它的默认逻辑是:删掉集合里所有的 x。
手算小例子:
假设我们按顺序执行 s.insert(3),s.insert(3),s.insert(5)。此时集合内是 {3, 3, 5}。
如果直接写 s.erase(3),集合会变成 {5},两个 3 都灰飞烟灭了。
正确解法:如果我们只想删掉其中一个 3(比如某位 90 分的同学转学了,另一位还在),我们需要先查找到某一个 3 的“迭代器(指针)”,然后针对这个位置进行删除。
multiset<int> ms;
ms.insert(3);
ms.insert(3);
ms.insert(5);

// 只删除一个 3 的标准写法
auto it=ms.find(3); // 找到其中一个 3 的位置
if(it!=ms.end()){   // 养成好习惯:删除前确保找到了
    ms.erase(it);   // 传位置给 erase,只会删掉这一个节点
}
五、Set/Map 的进阶检索:前驱、后继与边界
既然 set 和 map 内部是严格有序的,我们自然会想:能不能在里面快速找“刚好比某个数大一点的数”或者“刚好比它小的数”?这就是二分查找中的前驱与后继。
1. 专属的 lower_bound 与 upper_bound
千万不要用 std::lower_bound(s.begin(), s.end(), x)!因为 set 的迭代器不支持像数组那样直接跳跃,用通用的 std::lower_bound 会退化成
必须调用它们专属的成员函数,内部直接走红黑树的树干,时间复杂度是稳定的
s.lower_bound(x):返回的最小元素的迭代器。 s.upper_bound(x):返回的最小元素的迭代器。
2. 找不到怎么办?认识 end() 边界
如果集合里只有 {1, 5, 8},你去找 s.lower_bound(10),肯定找不到。这时候函数会返回 s.end()。
end() 是一个虚拟的越界指针,代表“最后一个元素的下一个位置”。在对迭代器取值(*it)前,务必检查它是不是等同于 end()。
3. 如何寻找前驱(严格
找后继直接用 upper_bound 就行了,但 set 没有提供 lower_bound 的反向版本。怎么找前驱呢?
物理推导一下:我们要找的是“刚好排在 lower_bound 找到位置,然后让指针后退一格(--it),就是前驱了!
set<int> s;
s.insert(10);
s.insert(20);
s.insert(30);

// 找第一个 >= 25 的数(相当于向后找)
auto it=s.lower_bound(25);
if(it!=s.end()){
    cout<<"找到: "<<*it<<"\n"; // 输出 30
}

// 找最后一个 < 25 的数(前驱方向)
if(it!=s.begin()){ // 退格前确保没退到最开头,否则会越界报错
    it--;
    cout<<"前驱是: "<<*it<<"\n"; // 输出 20
}
4. 完整代码演示:动态寻找前驱与后继
我们可以用一个简单的控制台程序,模拟动态加入数字,并实时查询某个数的前驱和后继。
/*
输入格式:
第一行一个整数 n (1 <= n <= 10^5),表示操作次数。
接下来 n 行,每行两个整数 op 和 x (1 <= x <= 10^9)。
op = 1: 将 x 插入集合
op = 2: 查询 x 的前驱(严格小于 x 的最大值),不存在输出 -1
op = 3: 查询 x 的后继(严格大于 x 的最小值),不存在输出 -1

输入样例:
5
1 10
1 20
2 15
3 10
2 5

输出样例:
10
20
-1
*/
#include<bits/stdc++.h>
#define int long long
using namespace std;
int n,op,x;
set<int> s;

void solve(){
    cin>>n;
    for(int i=1;i<=n;i++){
        cin>>op>>x;
        if(op==1){
            s.insert(x);
        }else if(op==2){
            auto it=s.lower_bound(x);
            if(it!=s.begin()){
                it--; // 退一格找到前驱
                cout<<*it<<"\n";
            }else{
                cout<<"-1\n"; // 连第一个元素都大于等于 x,说明没有前驱
            }
        }else if(op==3){
            auto it=s.upper_bound(x);
            if(it!=s.end()){
                cout<<*it<<"\n";
            }else{
                cout<<"-1\n"; // 已经越界,说明没有后继
            }
        }
    }
}

signed main(){
    ios::sync_with_stdio(0),cin.tie(0);
    solve();
    return 0;
}
六、组合键的应用:用 Pair 当 Map 的下标
前面我们说 map 就像一本自适应字典。有时候,我们的下标不仅是一个数字,而是一个“组合”。
比如:我们要统计平面直角坐标系上,每个点 pair(二元组)来当作 map 的 Key。
map<pair<int,int>, int> point_cnt;

// 在点 (3, 5) 扔一颗石子
point_cnt[{3, 5}]++;

// 查询点 (3, 5) 有几颗石子
cout<<point_cnt[{3, 5}]<<"\n";
实战扩展:如果在图论题中,你想记录某条无向边 pair 即 make_pair(min(u, v), max(u, v)) 存入 map,就能轻松应对频次统计,直接省去了复杂的状态哈希压缩。
七、选学:Unordered_map 与 Map 的实际考量
先修要求:了解哈希表(Hash Table)的基本概念。
既然 map 能当超级数组用,很多同学不管什么题都无脑上 map,结果遇到了 TLE(超时)。
这是因为 map 底层是红黑树,每次操作附带
C++11 提供了一个平替:unordered_map(无序映射)。
1. 两者的核心对比
map:底层是红黑树。保证元素按 Key 排序。单次操作稳定。 unordered_map:底层是哈希表。里面是完全乱序的。单次操作平均是神仙级的,但极端最坏情况会退化成 。
2. 比赛时的实际选择
你会觉得既然 unordered_map 平均
实用避坑指南:
- 优先用
map:只要题目时间限制不是极度苛刻,绝大部分普通计数题用map即可,稳定的让人安心。 - 需要防 Hack 时:如果时间太紧,非要用
unordered_map,而且怕被出题人卡,通常需要在内部手写一个随机哈希函数(防 Hack,属于进阶技巧)。 - 无需排序的普通题:如果是平时做一些没有故意卡哈希的水题,且并不需要对键值进行排序遍历,直接用
unordered_map确实能获得可观的性能提升。
八、典型应用模式与练习指引
除了简单的大数计数,map 还在很多空间受限的场景下充当降维神器。
1. 稀疏大空间的动态压缩:P3613 寄包柜
- 题目链接:洛谷 P3613
- 场景:有
个柜子,每个柜子最多有 个格子,查询和修改总共 次( )。 - 破局点:如果开二维数组
a[100005][100005],空间会瞬间炸掉。但次操作意味着绝大多数格子是空的。我们开一个 map数组:
map<int, int> box[N]; // 每一行是一个 map,记录被访问过的格子
// 存物品:box[i][j] = k;
// 查物品:cout << box[i][j] << "\n";
只有被访问过的格子才会新增节点,格子数据只需要
2. 字符串当下标:P5266 【深基17.例6】学籍管理
- 题目链接:洛谷 P5266
- 练习要点:直接使用
map<string, int> stu存储学生姓名和对应成绩。 - 插入/修改直接赋值
stu[name] = score,删除用stu.erase(name),人数查询用stu.size()。查成绩时,先用stu.count(name)看有没有这个学生,有的话再输出stu[name];别把count返回的 0/1 当成成绩。
3. 复合数据结构嵌套:P3879 [TJOI2010] 阅读理解
- 题目链接:洛谷 P3879
- 练习要点:要求快速查询某个单词在哪些短文中出现过,且输出的短文编号要去重并升序。
- 可以直接组合使用:
map<string, set<int>> pos;。
当第 word 时,直接 pos[word].insert(i)。查询时遍历对应的 set 即可,代码极其短小清晰。
九、底层认知与使用建议
1. 底层是一棵红黑树
set 和 map 的底层都是红黑树(一种自平衡二叉搜索树)。正因为是二叉树检索,每次插入、查找、删除都需要走一小段树高,耗时是稳定的
2. 能开数组时通常优先考虑数组
在考场上,数据结构的选取要根据题目数据范围做权衡:
- 普通数组:直接通过内存偏移寻址,速度是极其干净利落的
,常数极小。 - Map / Set:树上查找以及插入时的节点分配,常数相对明显。
如果题目给出的数值范围不大,空间足够开下数组做桶,通常优先使用数组;当数值范围过大开不下、出现负数或字符串、或者题目强依赖动态去重与有序性时,set 和 map 就是很省心的武器。