当动态规划的约束条件涉及“一个集合内的元素选取状态”,且集合规模较小(通常
一、状态压缩的核心原理与位运算基础
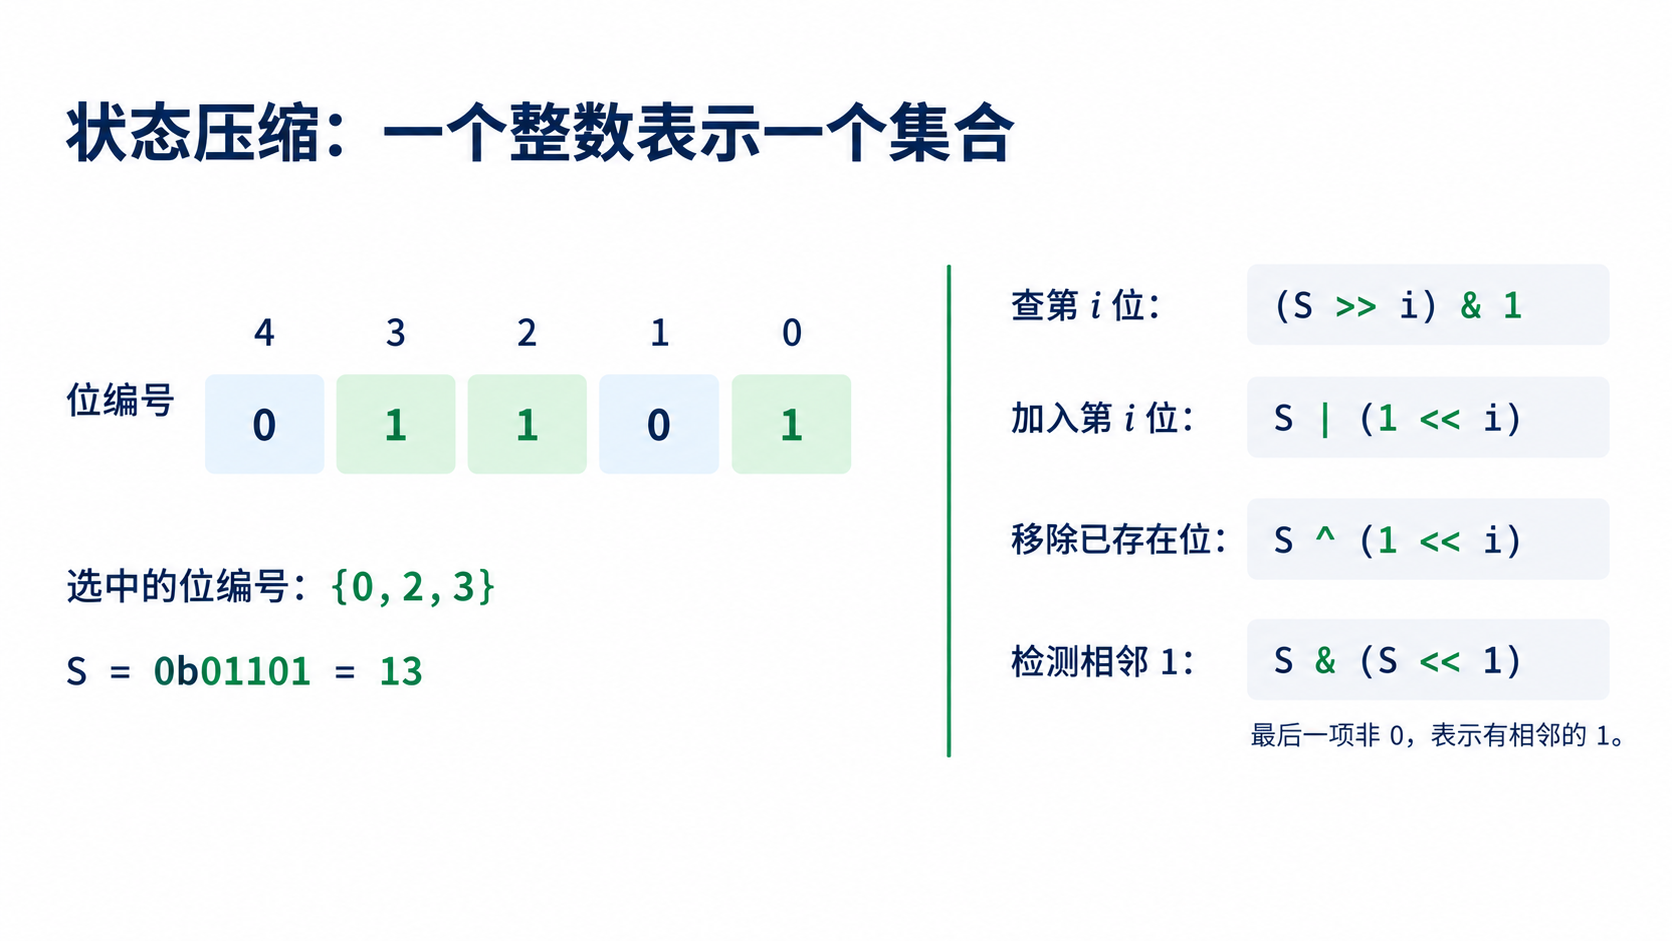
1. 集合的二进制映射
假设有一个包含 5 个元素的集合,我们选取了编号 0、2、3 的元素。这一状态可以表示为二进制串 01101(约定从右向左按
这个二进制状态对应的十进制整数为
2. 状态转移中的位运算
在状态压缩 DP 中,所有关于集合的交、并、查操作,均需转化为位运算以保证
- 状态查询:判断整数
的第 位是否为 1,表达式为 (S >> i) & 1。 - 状态添加:将整数
的第 位强制置为 1,表达式为 S | (1 << i)。 - 状态剥离:在已知第
位为 1 的前提下,将其置为 0,表达式为 S ^ (1 << i)。 - 相邻冲突校验:判断状态
内部是否存在相邻的 1,表达式为 S & (S << 1)。若运算结果不为 0,说明存在相邻元素,该状态不合法。
二、核心模型一:逐行网格放置与地形掩码
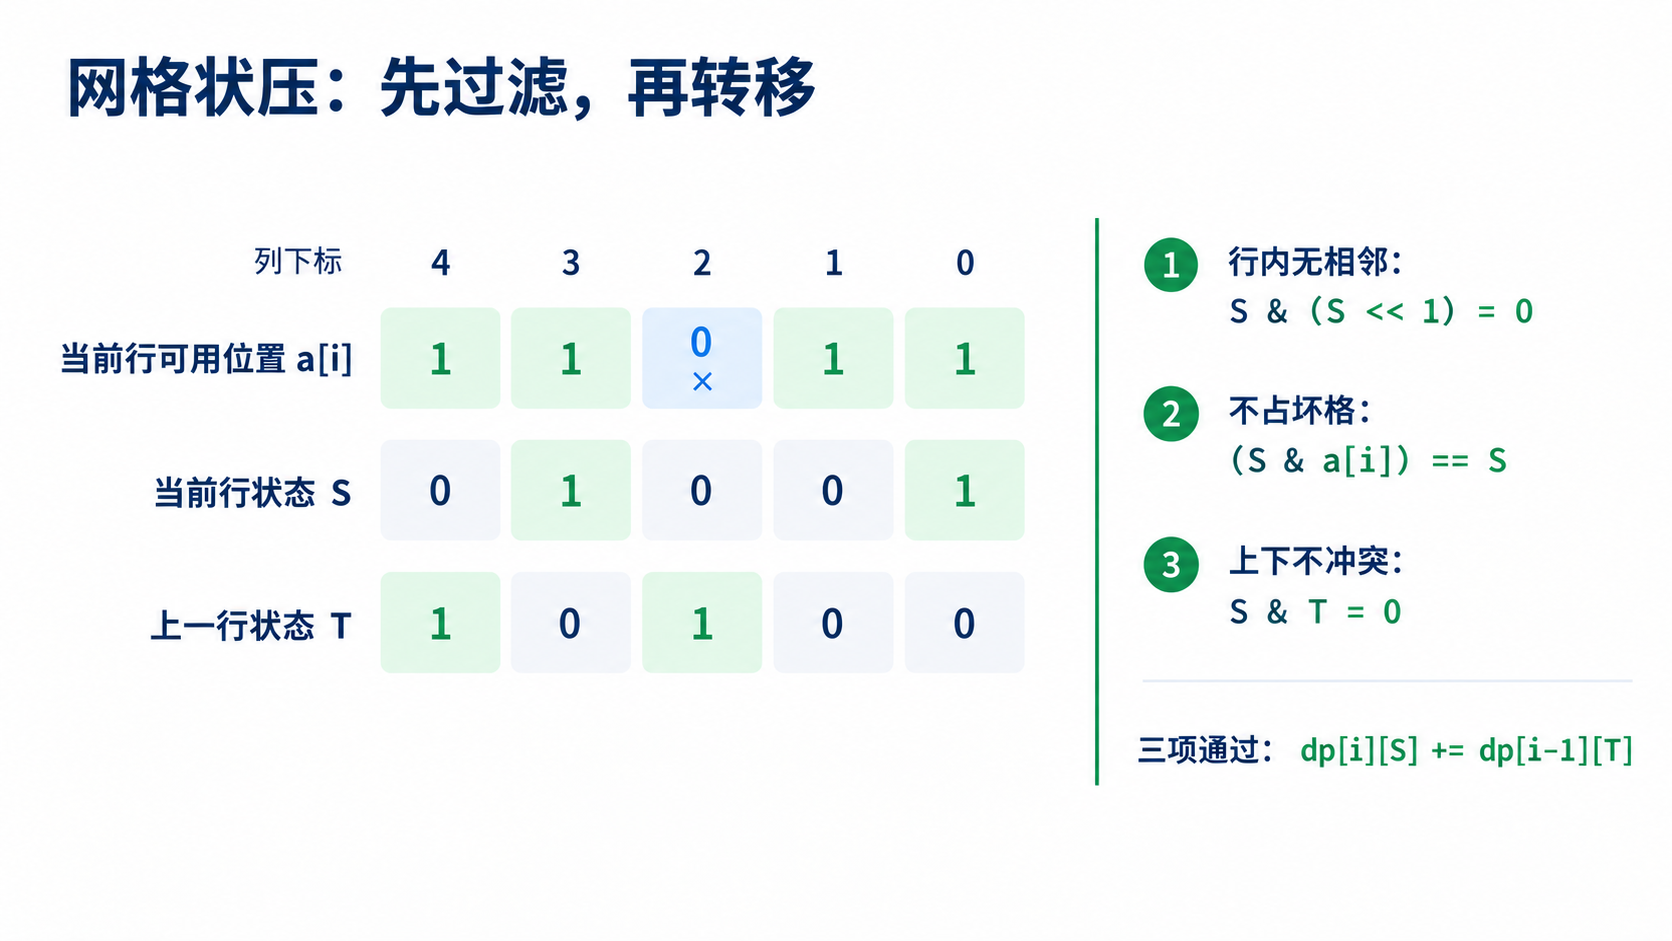
场景特征:在一个
推导过程:
网格的放置状态是按行递推的,第
定义
为了处理不可用的网格,引入地形掩码 (Map Mask) 技巧。将输入的每一行地形也压缩为一个整数 (S & a[i]) == S 即可快速校验放置位置是否全在可用网格上。
#include<bits/stdc++.h>
#define int long long
using namespace std;

const int N=15,M=1<<13;
const int mod=1e8;
int dp[N][M];
int a[N];
int state[M],tot;

// 预处理单行内无相邻元素的合法状态
void init(int m){
	for(int i=0;i<(1<<m);i++){
		if(!(i&(i<<1))) state[++tot]=i;
	}
}

void solve(){
	int n,m;
	cin>>n>>m;
	init(m);
	for(int i=1;i<=n;i++){
		for(int j=1;j<=m;j++){
			int x;
			cin>>x;
			a[i]=(a[i]<<1)|x; // 压缩地形为整数
		}
	}

	dp[0][0]=1;

	for(int i=1;i<=n;i++){
		for(int j=1;j<=tot;j++){
			int s1=state[j];
			if((s1&a[i])!=s1) continue; // 地形掩码校验

			for(int k=1;k<=tot;k++){
				int s2=state[k];
				if(s1&s2) continue; // 跨行相邻冲突校验

				dp[i][s1]=(dp[i][s1]+dp[i-1][s2])%mod;
			}
		}
	}

	int ans=0;
	for(int i=1;i<=tot;i++) ans=(ans+dp[n][state[i]])%mod;
	cout<<ans<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
三、核心模型二:TSP 与路径集合压缩
场景特征:求解经过给定节点集合的最短路径或全排列问题。此类问题若记录确切的访问顺序,复杂度将达到
推导过程:
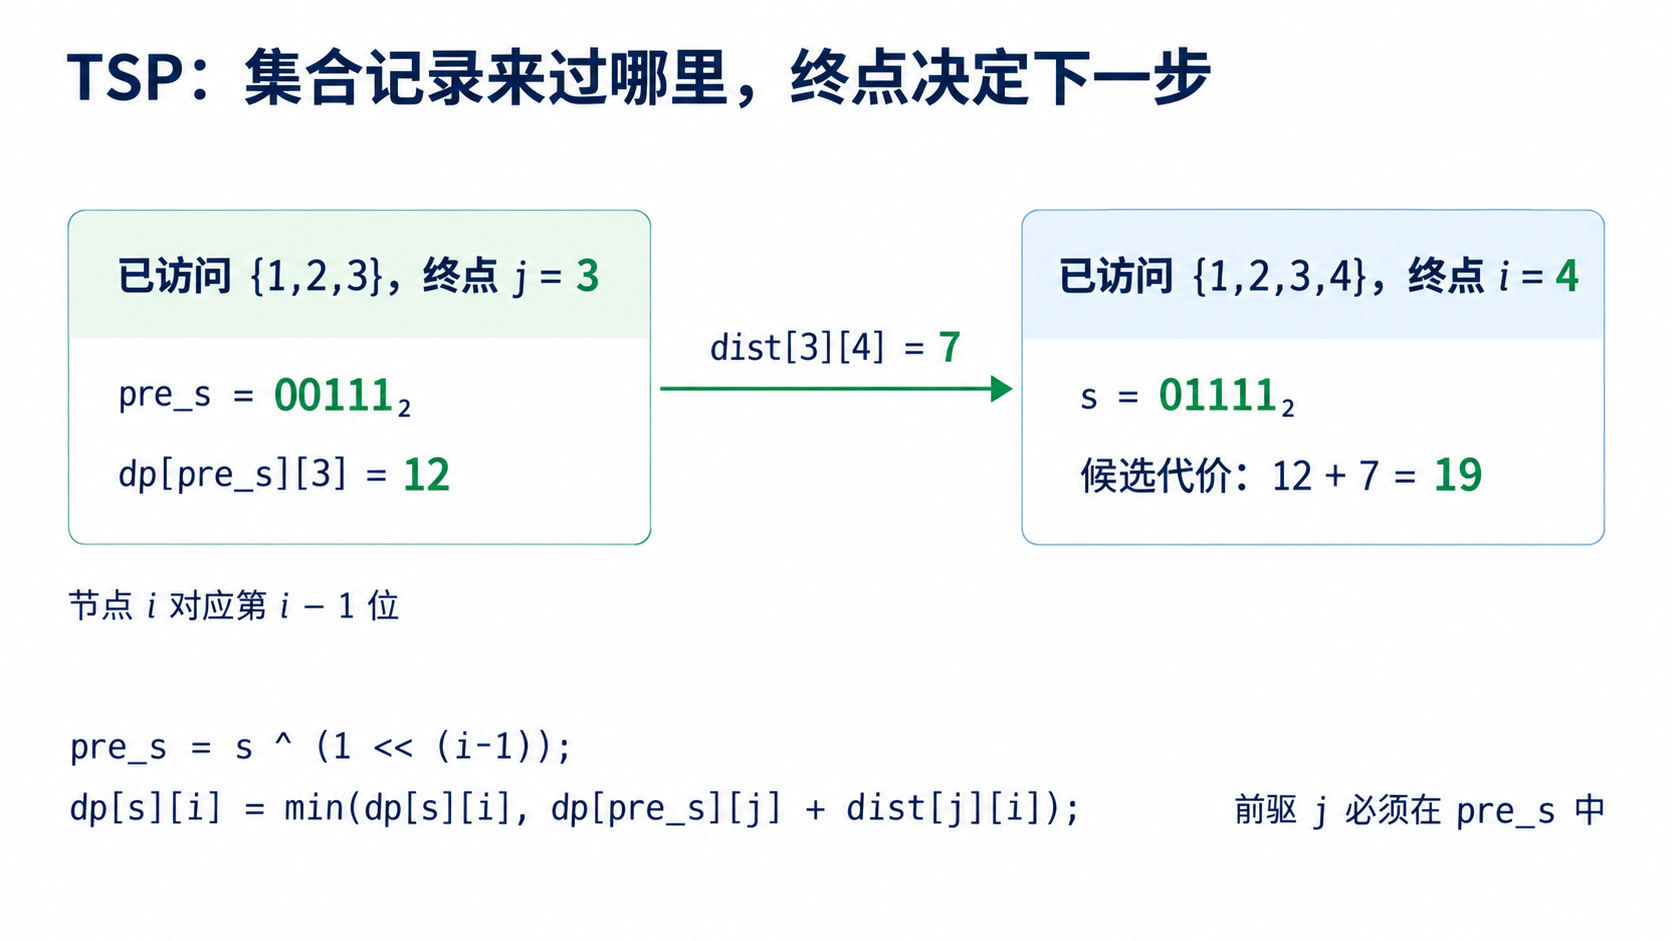
路径规划的核心在于“已经访问了哪些节点”以及“当前处于哪个节点”,中间的跳转顺序对后续决策无影响。
定义
状态转移:枚举状态
下面实现的是从 1 出发、走完所有点后回到 1 的最短回路,支持 dist[i][1]。这张 long long 表约占 168 MiB,使用前看清内存限制;只跳过部分状态并不会缩小已经声明的数组。
#include<bits/stdc++.h>
#define int long long
using namespace std;

const int N=21,M=1<<20;
int dist[N][N];
int dp[M][N];

void solve(){
	int n;
	cin>>n;
	for(int i=1;i<=n;i++){
		for(int j=1;j<=n;j++) cin>>dist[i][j];
	}

	memset(dp,0x3f,sizeof dp);
	if(n==1){ cout<<0<<'\n'; return; }
	dp[1][1]=0;

	int max_state=1<<n;
	for(int s=1;s<max_state;s++){
		for(int i=1;i<=n;i++){
			if(!((s>>(i-1))&1)) continue;

			int pre_s=s^(1<<(i-1)); // 状态剥离
			for(int j=1;j<=n;j++){
				if(!((pre_s>>(j-1))&1)) continue;
				dp[s][i]=min(dp[s][i],dp[pre_s][j]+dist[j][i]);
			}
		}
	}

	int ans=1e18;
	for(int i=2;i<=n;i++){
		ans=min(ans,dp[max_state-1][i]+dist[i][1]);
	}
	cout<<ans<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
四、集合划分的基石:子集枚举与
场景特征:在某些问题中,我们不是每次只加入一个节点,而是需要把若干个元素打包成一个整体加入。比如我们要将一个集合
1. 如何高效枚举子集?
假设当前状态为
最暴力的做法是:从 (sub & S) == sub 检查。但这会跑过大量根本不在
核心技巧:通过 sub = (sub - 1) & S,我们可以直接在
// 依赖变量:S 为当前要枚举子集的集合,例如 S = 10
// 这段逻辑直接嵌套在你的状态枚举循环内
for (int sub = S; sub; sub = (sub - 1) & S) {
    // sub 必然是 S 的非空子集
    int remain = S ^ sub; // 从 S 中剔除 sub 剩下的那部分

    // 状态转移示例:
    // dp[S] = min(dp[S], dp[remain] + cost[sub]);
}
物理推导:以 0111 & 1010 = 0010。
看,那些不属于
2.
如果外层循环枚举所有的
根据二项式定理:
因此,这类子集枚举 DP 的时间复杂度是严谨的
五、连通性与分组:集合划分 DP 与最小未选元素去重
场景特征:将
暴力转移的痛点:
如果我们直接套用前面的子集枚举:
去重解法:钉死一个元素
为了消除顺序带来的影响,我们可以立下一个规矩:当前这步切分出来的子集 sub,必须包含当前集合 S 中编号最小的那个元素!
不管你最终怎么分组,那个最小的元素总得归属在某个组里。我们就直接把包含它的那个组整个抠出来,这就彻底断绝了“先拿 A 后拿 B”和“先拿 B 后拿 A”的重复路径。
// 依赖数组:dp 为最小成本,w 为某个子集的单独成本,n 为元素总数
// 初始化:dp 数组全部赋为正无穷大,起步状态 dp[0] = 0

for (int S = 1; S < (1 << n); S++) {
    // 找到集合 S 中编号最小的元素(利用 lowbit 思想)
    // S & -S 能直接提取出最低位的 1 代表的值
    int p = S & -S;

    // 只枚举包含了元素 p 的子集
    for (int sub = S; sub; sub = (sub - 1) & S) {
        if (sub & p) { // 核心:当前划分出的组必须包含这个最小元素
            int remain = S ^ sub;
            dp[S] = min(dp[S], dp[remain] + w[sub]);
        }
    }
}
六、高维前缀和(SOS DP)与子集转移(选学)
先修要求:熟练掌握多维前缀和的思想与基本位运算,对维度拓展有一定直觉。
场景特征:给定一个大小为
暴力解法的瓶颈:
如果对每一个
物理推导:把子集看作高维空间
一维数组求前缀和是怎么做的?
- 第一步:只允许改变第 0 位(从 0 变成 1),把此时能累加的加起来。
- 第二步:只允许改变第 1 位(从 0 变成 1),把此时能累加的加起来。
- ……
- 第
步:处理最后一位。
通过这种“一层层剥开”的维度转移,每一层只需扫描所有状态一次。
手推小例子:
- 处理第 0 位:对于第 0 位是 1 的状态,加上把它变成 0 的状态。
- 处理第 1 位:对于第 1 位是 1 的状态,加上把它变成 0 的状态。
仔细看最后的
下面是独立可运行的 SOS DP 核心验证程序:
// 功能:给定长度为 2^n 的数组 A,计算每个状态的子集和 F。
// 输入:第一行一个整数 n (1 <= n <= 20)。
//       第二行 2^n 个整数,代表 A[0] 到 A[2^n - 1]。
// 输出:一行 2^n 个整数,代表 F[0] 到 F[2^n - 1]。
/*
样例输入:
2
1 2 3 4
样例输出:
1 3 4 10
*/
#include <bits/stdc++.h>
#define int long long
using namespace std;

const int N = 20;
int A[1 << N];
int F[1 << N];

void solve() {
    int n;
    if (!(cin >> n)) return;

    int max_state = 1 << n;
    for (int i = 0; i < max_state; i++) {
        cin >> A[i];
        F[i] = A[i]; // 初始状态,高维前缀和的起点
    }

    // 核心循环:逐个维度(位)进行前缀和累加
    for (int i = 0; i < n; i++) {
        for (int mask = 0; mask < max_state; mask++) {
            // 如果当前状态的第 i 位是 1,说明它可以被第 i 位为 0 的子集贡献
            if ((mask >> i) & 1) {
                // mask ^ (1 << i) 即把第 i 位的 1 拨成 0
                F[mask] += F[mask ^ (1 << i)];
            }
        }
    }

    for (int i = 0; i < max_state; i++) {
        cout << F[i] << (i == max_state - 1 ? "" : " ");
    }
    cout << '\n';
}

signed main() {
    ios::sync_with_stdio(0), cin.tie(0);
    solve();
    return 0;
}
七、降维扩展:折半搜索 (Meet-in-the-Middle)(选学)
场景特征:当状态压缩的规模扩张至
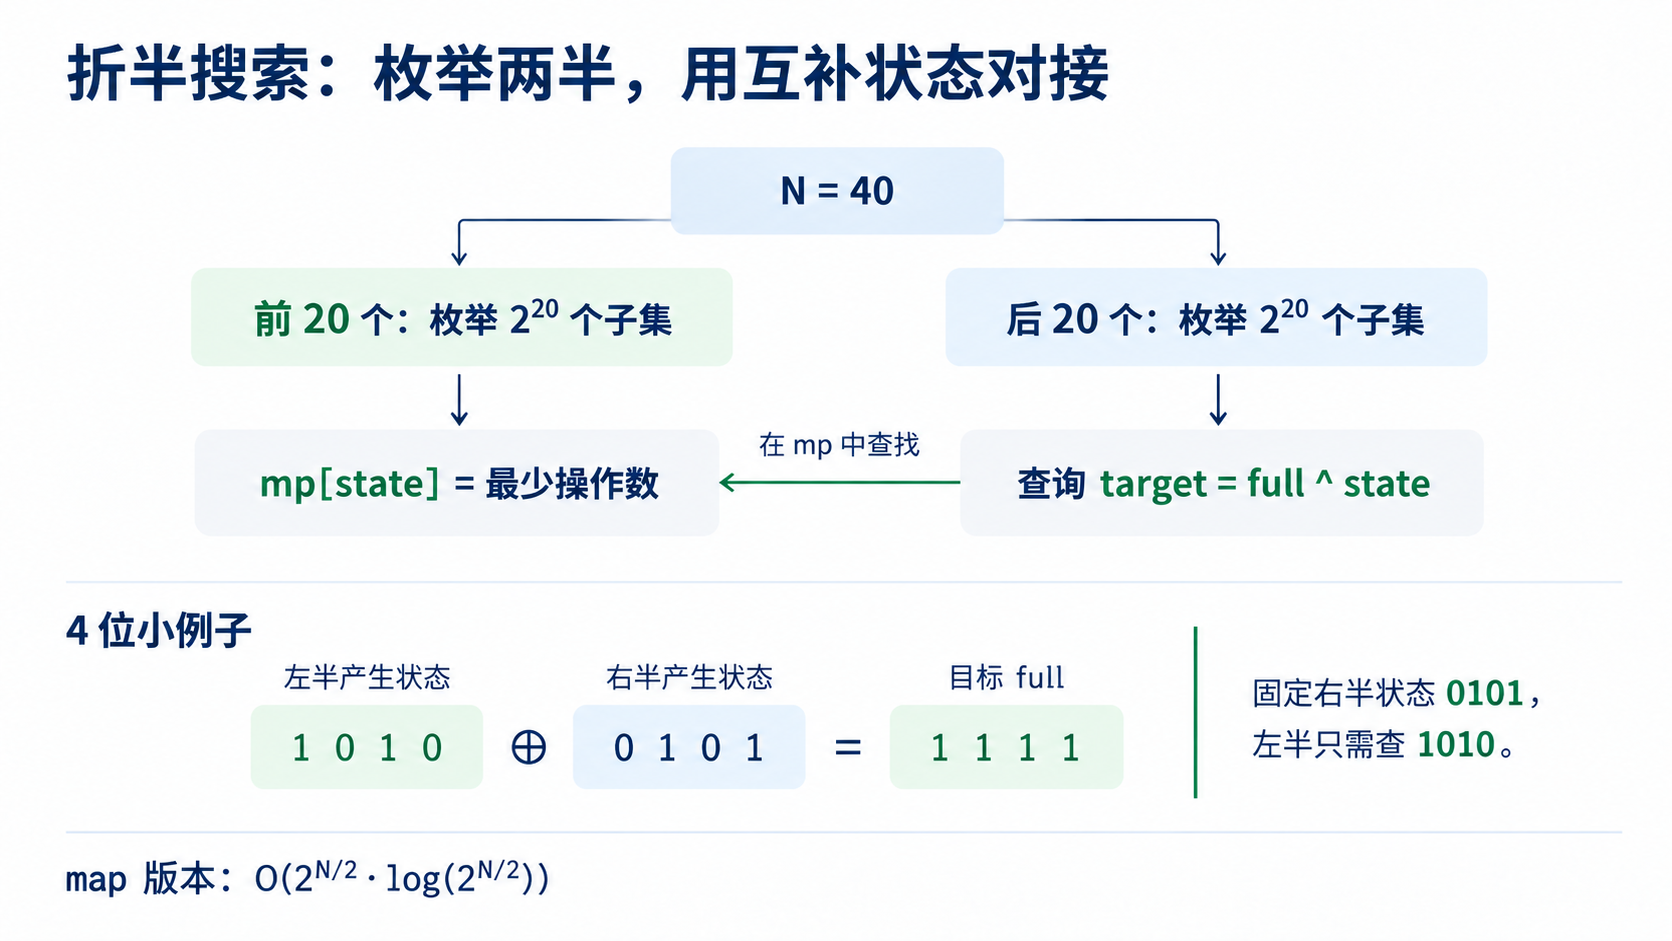
折半搜索的独立枚举与两半配对,详见《分治与折半搜索》;这里用点灯问题体会位掩码怎样表示互补状态。
推导过程:
将整个搜索空间一分为二。
前提是两半能独立枚举,并且能高效找到互补状态。不是看到
-
对前
个元素进行穷举搜索,将达成的状态及其最优代价存入哈希表或排序数组。 -
对后
个元素进行穷举搜索。在每次搜索到终点时,计算出需要的“互补状态”,并前往第一阶段建立的哈希表中查询。 此方案可将时间复杂度由
降维至 。
下面的代码具体在解什么?——点灯问题(P2962)
有 n m,接下来 m 行每行给一条无向边 u v,灯的编号为 1..n。
按同一个开关两次就抵消了,所以每个开关只考虑按或不按。adj[u] 记录它会翻转哪些灯,state ^ adj[u] 就是按下后的状态。把开关分成两半:前半用 mp[state] 记录最少操作数,后半枚举出 state 后,前半需要补上的正是 ((1LL<<n)-1) ^ state——两半异或,刚好得到全亮的位串。
#include<bits/stdc++.h>
#define int long long
using namespace std;

const int N=45;
int adj[N];
map<int,int> mp; // 本模板用有序 map;每次查询 O(log 状态数)
int n,m,ans=1e18;

void dfs1(int step,int max_step,int state,int cnt){
	if(step>max_step){
		if(mp.count(state)) mp[state]=min(mp[state],cnt);
		else mp[state]=cnt;
		return;
	}
	dfs1(step+1,max_step,state,cnt);
	dfs1(step+1,max_step,state^adj[step],cnt+1);
}

void dfs2(int step,int max_step,int state,int cnt){
	if(step>max_step){
		int target=((1ll<<n)-1)^state;
		if(mp.count(target)){
			ans=min(ans,cnt+mp[target]);
		}
		return;
	}
	dfs2(step+1,max_step,state,cnt);
	dfs2(step+1,max_step,state^adj[step],cnt+1);
}

void solve(){
	cin>>n>>m;
	for(int i=1;i<=n;i++) adj[i]=(1ll<<(i-1));
	for(int i=1;i<=m;i++){
		int u,v;
		cin>>u>>v;
		adj[u]|=(1ll<<(v-1));
		adj[v]|=(1ll<<(u-1));
	}

	int mid=n/2;
	dfs1(1,mid,0,0);
	dfs2(mid+1,n,0,0);
	cout<<ans<<'\n';
}

signed main(){
	ios::sync_with_stdio(0),cin.tie(0);
	solve();
	return 0;
}
八、渐进式实战练习题单
本题单按思维深度与代码实现复杂度分为三个阶梯,覆盖从普及组至省选级别的核心考点。
1. 第一阶梯:网格状压与状态过滤(建立一维到二维的映射)
该阶段侧重训练位运算的熟练度,以及如何在多维 DP 中运用状态掩码进行剪枝。
- 洛谷 P1879 [USACO06NOV] Corn Fields G
- 训练指引:基础网格状压。严格应用地形掩码,熟悉同行不相邻的二进制校验。
- 洛谷 P1896 [SCOI2005] 互不侵犯
- 训练指引:增加国王总数限制,状态由二维扩展为三维
;国王还攻击斜上方,因此跨行除了 s1&s2,还要检查(s1<<1)&s2和(s1>>1)&s2。
- 训练指引:增加国王总数限制,状态由二维扩展为三维
- 洛谷 P2704 [NOI2001] 炮兵阵地
- 训练指引:攻击范围扩张至距离 2。导致第
行的状态不仅受第 行限制,还受第 行限制。需要定义 进行滚动数组优化,是网格状压的毕业级题目。
- 训练指引:攻击范围扩张至距离 2。导致第
2. 第二阶梯:集合推演与 TSP 模型(突破排列组合的界限)
该阶段侧重将实际的图论或排列问题转化为集合推进,处理复杂的代价累加。
- 洛谷 P1433 吃奶酪
- 训练指引:浮点数 TSP 问题。数据量极小(
),适合用于第一次手写 TSP 状态转移方程。
- 训练指引:浮点数 TSP 问题。数据量极小(
- 洛谷 P1171 售货员的难题
- 训练指引:标准 TSP 模板。必须使用位运算完成集合剥离,重点关注初始化逻辑与终局状态的汇总。原题
、 ,整条回路小于 20000。第三节的 long long表约占 168 MiB;内存紧时可只把它改成int32_t dp[M][N](约 84 MiB),保留其他变量的 64 位设置。此时沿用memset(dp,0x3f,sizeof dp),匹配的无穷大是0x3f3f3f3f,不是1e18;把ans初值也改成0x3f3f3f3f,转移改用if(dp[pre_s][j]+dist[j][i]<dp[s][i]) dp[s][i]=dp[pre_s][j]+dist[j][i];,避免min的两参数类型不同而编译失败。不要顺手把其他题的方案计数表也改成 32 位。
- 训练指引:标准 TSP 模板。必须使用位运算完成集合剥离,重点关注初始化逻辑与终局状态的汇总。原题
- 洛谷 P3052 [USACO12MAR] Cows in a Skyscraper G
- 训练指引:状压 DP 与背包问题的结合。求解将集合
装入电梯的最少组数与当前电梯剩余空间,状态定义为 pair<int, int>具有极佳的思维拓展性。
- 训练指引:状压 DP 与背包问题的结合。求解将集合
3. 第三阶梯:折半搜索与高阶复合(挑战复杂度极限)
该阶段面向数据范围游走在传统算法盲区的题目,侧重解题视角的切换。
- 洛谷 P2962 [USACO09NOV] Lights G
- 训练指引:折半搜索基础。练习使用哈希表(或排序后二分)完成两端状态的拼凑。
- 洛谷 P4799 [CEOI2015 Day2] 世界冰球锦标赛
- 训练指引:折半搜索求解超大容量背包(
)。分别处理出两部分所有可能的子集和,对其一排序后,利用 upper_bound快速统计合法方案数。
- 训练指引:折半搜索求解超大容量背包(
- 洛谷 P3959 [NOIP2017 提高组] 宝藏
- 训练指引:历年 NOIP 中难度极高的状压 DP。需要在状态压缩的基础上,引入“树的深度”作为 DP 维度,考察状态展开与生成树性质的深度融合。